5. 고객 데이터 위의 RAG
RAG의 품질은 모델이 아니라 검색이 결정하므로, 고객 문서를 어떻게 자르고, 숫자로 바꾸고, 찾고, 다시 고르느냐가 프로토타입의 성패를 가릅니다. FDE가 "답이 엉뚱하다"는 불만을 검색 단계의 어디에서 일어난 일인지 짚어 내는 언어가 여기서 나옵니다.
영상: AI Engineering Explained: LLM, RAG, MCP, Agent, Fine-Tuning, Quantization
학습 동기: 이 장을 읽으면 고객의 문서 규모와 질문 유형을 듣고 벡터 DB, ANN 인덱스, 하이브리드 검색, 리랭커, 청킹 전략 중 무엇을 쓸지 고를 수 있고, 검색이 실패하는 지점을 청크·쿼리·인덱스 단계별로 진단해 비용과 지연 숫자와 함께 설명할 수 있습니다.
선행 가정: 임베딩이 의미를 숫자 목록으로 옮긴 것이라는 점(1.4.4, 2.6)과 코사인 유사도의 뜻(2.7)을 알고 있으면 충분합니다. 5.13은 프롬프트 캐싱(4.6)과 대비해 읽으며, 5.7과 5.16은 컨텍스트 윈도우의 한계(2.17)를 전제로 합니다. 코드는 짧은 파이썬 몇 줄만 읽을 수 있으면 됩니다.
5.1 벡터 데이터베이스(Vector Database)
원문: How does a Vector Database work?
고객 문서 위에 RAG를 올릴 때 가장 먼저 고르는 부품이 벡터 DB입니다. 무엇을 저장하고, 무엇으로 가깝다고 판정하며, 규모가 커질 때 어디서 느려지는지를 알아야 제품 선정과 장애 진단이 가능합니다. 이 절은 2026년 6월 글 기준으로 구성했습니다.
5.1.1 일반 DB가 못 푸는 문제와 벡터 DB의 저장 내용
벡터 데이터베이스(Vector Database)는 데이터를 숫자 목록(벡터)으로 저장하고, 글자가 같은 항목이 아니라 의미가 가까운 항목을 찾아 주는 데이터베이스입니다. 벡터는 [0.21, 0.87, 0.13]처럼 숫자를 늘어놓은 것이며, 이 숫자는 임베딩 모델이 만듭니다. 임베딩(2.6 참조)은 단어·문장·이미지·노래의 의미를 숫자 목록으로 옮긴 것으로, 의미가 비슷하면 숫자도 비슷해지도록 학습됩니다.
"king"   -> [0.91, 0.12, 0.55]
"queen"  -> [0.89, 0.15, 0.58]
"banana" -> [0.10, 0.95, 0.03]king과 queen은 숫자가 가깝고 banana는 멀리 떨어집니다. MySQL이나 PostgreSQL 같은 일반 DB는 정확히 일치하는 값을 찾는 데 강합니다. apple을 검색하면 그 단어가 든 행을 모두 찾지만, fruit that keeps the doctor away처럼 의미로 묻는 질문에는 답하지 못합니다. 다음 세 문서가 있을 때 healthy fruit advice from a doctor라는 문장은 어느 문서에도 그대로 들어 있지 않으므로 일반 DB는 아무것도 찾지 못합니다.
- "An apple a day keeps the doctor away."
- "Bananas are rich in potassium."
- "The doctor recommended eating more fruits."
벡터 DB는 항목마다 세 가지를 함께 저장합니다.
| 저장 대상 | 역할 | 예 |
|---|---|---|
| 벡터 | 의미를 담은 임베딩, 검색의 대상 | [0.91, 0.12, 0.55, ...] |
| 원본 데이터 | 사용자에게 되돌려 보여 줄 텍스트·이미지 링크·상품 | "An apple a day keeps the doctor away." |
| 메타데이터 | 필터링용 부가 정보 | {"category": "health", "year": 2024} |
메타데이터를 쓰는 방식은 두 가지입니다. 필터를 먼저 적용하고 통과한 항목에서만 유사도 검색을 하는 방식이 프리필터링(pre-filtering)이고, 유사도 검색을 먼저 한 뒤 조건에 안 맞는 결과를 버리는 방식이 포스트필터링(post-filtering)입니다. 어차피 버릴 항목에 검색을 낭비하지 않으므로 대개 프리필터링이 낫습니다.
일반 DB 대 벡터 DB의 구분은 절대적이지 않습니다. PostgreSQL은 pgvector 확장으로 벡터 검색을 추가할 수 있으며, 같은 벡터 검색 원리를 씁니다. 따라서 고객에게 물을 것은 "어떤 제품이냐"보다 "의미로 검색할 수 있느냐"입니다. 이미 PostgreSQL을 운영 중인 고객이라면 확장 사용 가능 여부부터 확인하는 편이 도입 비용을 줄입니다. 또한 필터 조건(연도, 부서, 권한)이 자주 걸리는 고객 문서라면 프리필터링을 지원하는지를 선정 기준에 넣습니다.
5.1.2 코사인·내적·유클리드 거리 (개념 정의는 2.7)
저장된 벡터 중 쿼리와 가까운 것을 고르려면 두 벡터가 얼마나 비슷한지 숫자로 재야 하며, 그 공식을 유사도 지표(similarity metric)라 합니다. 코사인 유사도의 개념 정의는 2.7에서 다뤘으므로 여기서는 벡터 DB가 지표를 고르는 관점으로 세 가지를 비교합니다.
코사인 유사도는 두 벡터 사이의 각도만 보고 길이는 무시합니다. 값은 -1에서 1 사이이며, 1에 가까우면 방향이 같아 비슷하고 0이면 직각이라 무관하며 -1이면 정반대입니다. 공식은 (A · B) / (|A| × |B|)입니다. A = [2, 3], B = [4, 6]으로 계산해 보면 B는 A를 두 배로 늘린 것이라 방향이 같습니다.
- 내적
A · B = 2×4 + 3×6 = 26 - 길이
|A| = √13 ≈ 3.61,|B| = √52 ≈ 7.21 - 코사인
26 / (3.61 × 7.21) ≈ 1.0
길이가 두 배 달라도 값이 1이므로 긴 문장과 짧은 문장이 같은 의미이면 비슷하다고 판정합니다. 현대 임베딩 모델 다수는 정규화된 벡터를 내놓아 실제 텍스트 검색에서는 음수가 거의 나오지 않습니다. 이 때문에 코사인은 텍스트와 시맨틱 검색의 기본 선택입니다(5.3 참조).
내적(dot product)은 같은 위치의 숫자끼리 곱해 모두 더한 값입니다. A = [1, 2, 3], B = [4, 5, 6]이면 4 + 10 + 18 = 32이고, C = [0, 0, 1]이면 0 + 0 + 3 = 3이므로 A는 C보다 B와 훨씬 비슷합니다. 다만 내적은 방향뿐 아니라 벡터 길이에도 좌우되어, 길이가 긴 벡터는 방향이 어긋나도 큰 값을 받을 수 있습니다. 그래서 모든 벡터를 같은 길이로 맞춘 정규화(normalized) 상태에서 쓰는 것이 안전하며, 이때는 내적과 코사인 순위가 일치하고 계산이 빠릅니다.
유클리드 거리(Euclidean distance)는 두 점 사이의 직선거리로, 같은 위치 숫자의 차를 제곱해 더한 뒤 제곱근을 취합니다. A = [1, 2], B = [4, 6]이면 가로 차이 3, 세로 차이 4이므로 √(9 + 16) = 5입니다. C = [1, 3]은 A와 거리 1이므로 C가 B보다 A에 훨씬 가깝습니다. 앞의 두 지표와 달리 값이 작을수록 비슷하다는 점에 주의합니다.
| 지표 | 재는 것 | 비슷하다는 신호 | 주 용도 |
|---|---|---|---|
| 코사인 유사도 | 벡터 사이 각도 | 1에 가까움 | 텍스트, 시맨틱 검색 |
| 내적 | 방향과 크기의 결합 | 값이 큼 | 정규화된 벡터 |
| 유클리드 거리 | 직선거리 | 값이 작음 | 이미지, 공간 데이터 |
지표는 임베딩 모델이 학습된 방식과 맞춰 고릅니다. 고객이 점수를 비교해 임계값을 정하겠다고 하면, 지표에 따라 큰 값이 좋은지 작은 값이 좋은지가 반대라는 점부터 확인합니다.
5.1.3 전수 탐색이 느린 이유
사용자의 쿼리도 벡터로 바꾼 뒤 저장 벡터 중 가장 가까운 것을 찾는 문제가 최근접 이웃(nearest neighbour) 문제입니다. 쿼리 healthy fruit는 임베딩 모델을 거쳐 [0.90, 0.13, 0.56, ...] 같은 쿼리 벡터가 되고, 벡터 DB가 사과 글과 바나나 글을 상위 결과로 돌려줍니다. 사용자가 그 단어를 입력하지 않았는데도 둘 다 건강한 과일에 대한 글이라 찾아집니다.
가장 단순한 방법은 쿼리 벡터를 저장된 모든 벡터와 하나씩 비교하는 전수 탐색(brute force)입니다. 벡터가 10개면 순식간이지만 실제 서비스는 수백만에서 수십억 개를 다룹니다. 벡터 1억 개, 벡터당 1000개 숫자라면 검색 한 번에 1억 번 비교하고, 비교마다 1000개 숫자를 만지므로 1000억 번(10^11)의 계산이 필요합니다. 사용자는 수 밀리초 안에 결과를 기대하므로 이 규모에서 전수 탐색은 버티지 못합니다.
- 정확도: 완벽함
- 비용: 데이터가 늘수록 검색 시간이 그대로 비례해 늘어남
- 적합한 곳: 벡터가 수천 개 이하인 소규모 데이터
고객 코퍼스가 작다면 전수 탐색(예: FAISS의 IndexFlatL2)으로 충분하고 복잡한 인덱스는 필요 없습니다. 문서 수와 응답 시간 목표를 묻고, 전수 탐색이 목표 안에 들어오는지 먼저 계산해 보는 것이 순서입니다.
5.1.4 HNSW
속도를 얻는 첫 번째 방법은 근사 최근접 이웃(ANN) 탐색입니다. 완벽하게 가장 가까운 것이 아니라 충분히 가까운 것을 빠르게 돌려주는 것으로, 대부분 벡터를 건너뛰고 가능성 높은 곳만 확인합니다(5.2 참조). 얼마나 가까우면 충분한지는 재현율로 잽니다. 진짜 상위 10개 중 9개를 찾았다면 재현율은 90%이며, 수 밀리초에 9개를 얻는 편이 수 초에 10개를 얻는 편보다 대개 낫습니다. 건너뛰기를 가능하게 하려면 벡터를 미리 정리해 두는 인덱스(index)가 필요합니다. 도시를 찾는 비유로, 전수 탐색은 전국의 모든 집 문을 두드리는 일이고 인덱스는 도시, 거리 순으로 좁혀 마지막 몇 집만 확인하는 일입니다.
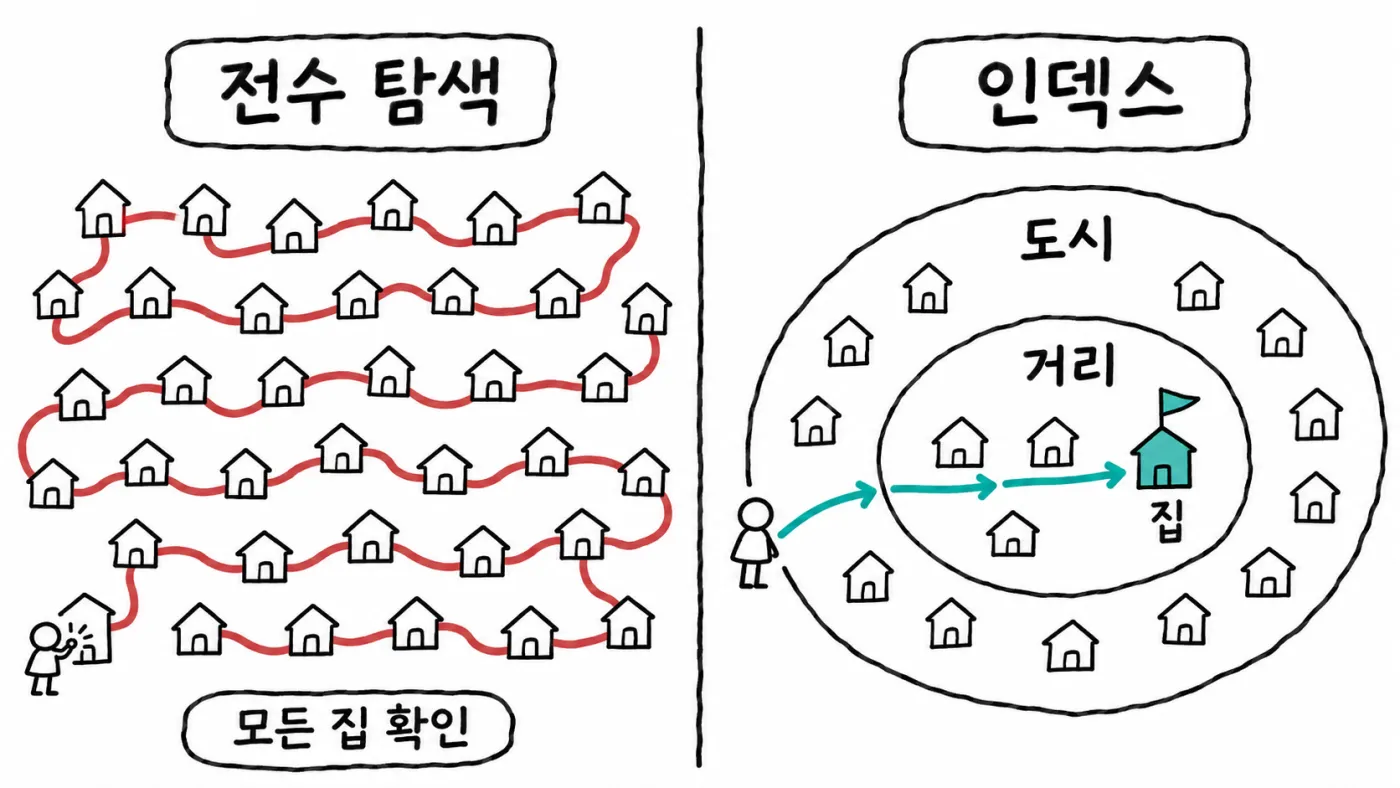
HNSW(Hierarchical Navigable Small World)는 층층이 쌓은 연결 지도입니다. Hierarchical은 층 구조를, Navigable Small World는 소셜 네트워크처럼 몇 걸음이면 누구에게든 닿는 연결을 뜻합니다.
| 층 | 점의 수 | 지도 비유 | 이동 |
|---|---|---|---|
| 최상층 | 극소수, 멀리 떨어짐 | 대도시만 표시 | 큰 도약 |
| 중간층 | 더 많고 가까움 | 지역 안의 마을 | 중간 걸음 |
| 최하층 | 전체 점 | 집 단위 거리 지도 | 세밀한 걸음 |
검색은 최상층에서 쿼리에 가까운 점으로 크게 이동하고, 한 층 내려가 더 가까운 이웃으로 옮기며, 최하층에서 촘촘한 점들 사이를 조심스럽게 걸어 최종 이웃에 닿는 순서입니다. 원문의 예에서는 최상층 A에서 F로, 중간층에서 C를 거쳐, 최하층에서 E에 도착합니다. 모든 점을 확인하지 않고도 가까운 점에 닿으며, 현대 벡터 DB에서 가장 널리 쓰는 인덱스입니다. 대신 그래프를 유지하느라 메모리를 더 쓰고 구축 시간이 길다는 대가가 있습니다(5.2 참조).
5.1.5 IVF
IVF(Inverted File Index)는 검색 전에 비슷한 벡터를 군집으로 묶어 두는 방식입니다. 묶는 작업은 한 번만 하며, 군집마다 평균에 해당하는 중심점(center point)이 있습니다. 검색할 때는 수백만 개 벡터가 아니라 군집 중심점들과만 쿼리를 비교하고, 중심이 가장 가까운 군집 몇 개를 고른 다음 그 안에서만 찾습니다.
수치로 보면 벡터 1억 개를 100개 군집으로 나누면 군집당 100만 개입니다. 가까운 3개 군집만 검색하면 300만 개(전체의 3%)만 확인하므로 전수 탐색보다 크게 빨라집니다.
- 장점: 검색 범위를 군집 몇 개로 줄여 시간을 절약
- 약점: 진짜 최근접 벡터가 건너뛴 군집에 있으면 놓침
- 조정: 더 많은 군집을 검색하면 정확도는 오르지만 시간이 더 듦
군집 수와 검색할 군집 수는 용도에 맞춰 조정하는 값입니다. 고객이 "가끔 명백한 문서가 빠진다"고 하면 검색 군집 수를 늘려 재현율이 오르는지 먼저 시험해 봅니다.
5.1.6 PQ(Product Quantization)
HNSW와 IVF가 어느 벡터를 볼지 정한다면, PQ(Product Quantization)는 벡터 하나하나를 작게 압축해 메모리를 아끼는 기법입니다. 벡터가 128개 숫자이고 숫자당 4바이트이면 벡터 하나가 512바이트이고, 10억 개면 약 512GB가 벡터를 담는 데만 듭니다.
- 벡터를 조각으로 나눕니다. 128개 숫자를 16개씩 8조각으로 자릅니다.
- 조각마다 대표 견본 256개를 미리 만들어 둡니다. 이 견본 묶음이 코드북(codebook)입니다.
- 각 조각을 코드북에서 가장 가까운 견본으로 바꿔 그 번호(0~255)만 저장합니다.
번호 하나가 1바이트이므로 벡터는 8바이트가 되어 512바이트의 64분의 1로 줄어듭니다. 압축본은 원본의 근사치이므로 정확도를 조금 내주고 메모리를 크게 아끼는 거래입니다. 실무에서는 IVF가 군집을 좁히고 PQ가 벡터를 작게 유지하는 IVF-PQ 조합으로 수십억 벡터 검색을 감당할 만한 비용으로 만듭니다. 각 숫자를 작은 자료형으로 줄이는 스칼라 양자화(scalar quantization)와 이진 양자화(binary quantization)는 PQ보다 쓰기 쉬워 운영 환경에서 적은 노력으로 메모리를 줄일 때 인기가 많습니다. 원문은 이 밖에 대규모 데이터용 인덱스로 DiskANN과 ScaNN이 있다고 소개합니다.
| 기법 | 해결하는 문제 | 대가 |
|---|---|---|
| HNSW | 어디를 볼지(그래프 탐색) | 더 많은 메모리와 긴 구축 시간 |
| IVF | 어디를 볼지(군집 선택) | 건너뛴 군집의 정답 누락 |
| PQ | 벡터 메모리 | 근사에 따른 정확도 손실 |
코드로 확인하면 요점이 분명해집니다. FAISS(Meta의 오픈소스 벡터 검색 라이브러리)에서 IndexFlatL2(4)에 벡터 3개를 넣고 쿼리 [0.90, 0.13, 0.56, 0.11]로 상위 2개를 찾으면 ids = [[0 2]]가 나옵니다. 재계산한 거리는 항목 0이 0.0004, 항목 2가 0.0013, 항목 1이 1.6774로, 사과 글(0)과 의사·과일 글(2)이 가깝습니다. IndexFlatL2는 제곱근을 생략한 제곱 유클리드 거리를 돌려주므로 값은 앞서 본 거리 공식과 다르지만 순서는 같습니다. 이 인덱스는 전수 탐색이어서 작은 데이터용이며, 수백만 개 규모에서는 FAISS가 지원하는 HNSW나 IVF로 바꾸고 검색 코드는 거의 그대로 둡니다.
벡터 DB의 용도는 다음과 같습니다.
- 시맨틱 검색:
cheap flights to the beach처럼 단어가 없어도 의도에 맞는 결과를 반환 - LLM용 RAG: 문서를 청크로 자르고(5.6 참조) 벡터로 저장하며, 질문이 오면 관련 조각을 찾아 LLM에 넘겨 사설 데이터로 답하게 함
- 추천: 상품과 취향을 벡터로 바꿔 비슷한 상품을 찾음
- 이미지 검색: 사진을 벡터로 바꿔 시각적으로 비슷한 이미지를 찾음
- 중복·사기 탐지: 비슷한 거래나 문서가 비슷한 벡터가 되는 성질을 이용
- 시맨틱 캐싱: 의미가 같은 과거 질문의 답을 재사용해 모델 호출을 생략
벡터 검색과 키워드 검색을 섞는 하이브리드 검색(5.4 참조), 쿼리 대신 가상 답변으로 검색하는 HyDE(5.8 참조), 후보를 진짜 관련도 순으로 재정렬하는 리랭커(5.5 참조)가 이 위에 얹는 보강책입니다. 벡터 없이 문서 구조를 읽어 검색하는 벡터리스 RAG도 있으므로 RAG에 벡터 DB가 반드시 필요한 것은 아닙니다.
고객 현장에서는 네 가지를 묻습니다. 문서 수가 몇 개이고 목표 응답 시간이 얼마인가, 메타데이터 필터가 얼마나 자주 걸리는가, 메모리 예산 안에 벡터가 들어가는가(차원 수와 건수로 건수 × 차원 × 4바이트를 곱해 봅니다), 몇 퍼센트의 재현율 손실을 감수할 수 있는가입니다.
5.2 근사 최근접 이웃(ANN) 탐색
원문: How does Approximate Nearest Neighbor (ANN) search work?
벡터 DB의 검색 속도는 ANN 알고리즘이 결정하며, 알고리즘마다 강점과 대가가 다릅니다(5.1에서 소개). 이 절은 2026년 6월 글 기준으로 트리, 해싱, 클러스터링, 그래프 네 계열을 같은 축에서 비교해 고객 데이터 규모에 맞는 방식을 고르는 근거를 만듭니다.
5.2.1 속도 대 정확도 트레이드오프
최근접 이웃 탐색(Nearest Neighbor Search)은 주어진 항목과 컬렉션 안에서 가장 비슷한 항목을 찾는 일입니다. 음악 앱에서 한 곡을 재생하면 라이브러리 전체에서 스타일이 가장 가까운 곡을 찾아 추천하는 것이 그 예이고, 사진 업로드 후 비슷한 사진 찾기, 질문에 맞는 검색 결과 찾기, 다음 영상 추천도 같은 구조입니다.
컴퓨터는 노래나 사진을 직접 이해하지 못하므로 항목마다 숫자 목록인 벡터로 바꿉니다. 사람을 나이와 키 두 숫자로 나타내면 A [25, 170], B [27, 172], C [60, 165]가 되어 A와 B는 가깝고 C는 멉니다. 실제 사진과 문장은 수백에서 수천 개 숫자로 표현되며, 이를 만드는 모델이 임베딩 모델입니다. 벡터가 되면 "비슷하다"는 "가깝다"로 바뀌고, 가장 흔한 거리는 유클리드 거리입니다. A = [1, 2], B = [4, 6]이면 차이 3과 4의 제곱합 25의 제곱근으로 거리가 5이고, 거리가 작을수록 비슷합니다. 텍스트에는 각도를 보는 코사인 유사도를 널리 씁니다(2.7 참조).
가장 단순한 방법은 쿼리를 모든 벡터와 비교해 거리가 가장 작은 하나를 고르는 전수 탐색(brute force)이며, 항상 완벽한 답을 주므로 정확 탐색(exact search)이라고도 합니다. 문제는 규모입니다. 벡터가 10억 개이고 각각 1000개 숫자라면 쿼리 한 번에 10억 번의 거리 계산이 필요하고 계산마다 1000개 숫자를 만지므로 총 10^12번, 즉 1조 번의 연산입니다. 큰 서비스는 이런 검색을 초당 수천 번 처리하므로 전수 탐색은 확장되지 않습니다.
근사 최근접 이웃(ANN, Approximate Nearest Neighbor) 탐색은 진짜 최근접에 아주 가까운 이웃을 훨씬 빨리 찾되, 완벽하지 않을 약간의 확률을 허용하는 방식입니다. 거대한 도서관에서 요리책을 찾을 때 모든 책 제목을 읽는 것이 전수 탐색이고, "요리" 서가로 바로 가서 그곳만 보는 것이 ANN입니다. 건물 전체에서 가장 좋은 책은 놓칠 수 있어도 훌륭한 책을 몇 초 안에 찾습니다. 데이터를 미리 정리해 두었다가 검색 때 알맞은 구역으로 건너뛰고 나머지는 무시하는 것이 핵심입니다.
품질은 재현율(recall)로 측정합니다. 근사 답이 진짜 최근접과 일치하는 비율이며, 100%이면 항상 완벽하고 95%이면 100번 중 95번 맞고 5번은 조금 어긋난다는 뜻입니다. 어긋난다 해도 대개 첫째가 아니라 둘째나 셋째로 가까운 항목을 돌려주므로 대부분의 앱에서는 문제가 되지 않습니다.
| 방식 | 재현율 | 속도 |
|---|---|---|
| 전수 탐색(정확) | 100% | 느림 |
| ANN, 정확도 중심 조정 | 약 99% | 빠름 |
| ANN, 속도 중심 조정 | 약 90% | 더 빠름 |
속도를 더 얻으면 재현율이 조금 떨어지고, 정확도를 더 얻으면 속도가 조금 떨어집니다. 모든 ANN 방법에는 이 둘을 맞바꾸는 손잡이가 있고, 용도에 맞게 돌립니다. 위 표의 수치는 원문이 개념을 보이려고 제시한 예시이므로 고객 데이터에서 실측해야 합니다. 고객에게는 "재현율 몇 퍼센트까지 괜찮고 응답 시간 목표가 몇 밀리초인가"를 먼저 묻고, 그 두 숫자 사이에서 손잡이를 정합니다.
5.2.2 트리 방식: KD-Tree
트리 방식은 공간을 점점 작은 구역으로 쪼개 쿼리가 속한 구역만 검색합니다. 대표가 KD-Tree(K-Dimensional Tree)이며 공간을 반으로 거듭 자릅니다. 점들이 평평한 판 위에 있다면 먼저 세로선으로 좌우를 나누고, 각 쪽을 다시 가로선으로 위아래로 나누며, 이를 반복해 구역의 나무를 만듭니다.
graph TD
    A["전체 점"] -->|세로선으로 분할| B["왼쪽 구역"]
    A --> C["오른쪽 구역"]
    B --> D["하위 구역"]
    B --> E["하위 구역"]
    C --> F["하위 구역"]
    C --> G["하위 구역"]
쿼리가 오면 분할선을 따라 내려가 해당하는 작은 구역에 도달하고, 그 구역의 몇 점과만 비교하며 나머지 나무는 건너뜁니다.
- 강점: 단순하고, 숫자가 적은 벡터에서는 정확하게 동작
- 약점: 벡터에 숫자가 수백 개로 늘면 분할이 도움이 되지 않아 결국 거의 전부를 확인
- 이름: 고차원 데이터에서 이런 현상이 생기는 것을 차원의 저주(curse of dimensionality)라 부름
현대 AI 임베딩은 수백에서 수천 차원이므로 KD-Tree는 저차원 데이터에는 좋아도 여기에는 맞지 않습니다. 고객 데이터가 좌표나 센서값처럼 열 개 안팎의 숫자라면 트리로 충분할 수 있고, 텍스트 임베딩이라면 트리를 후보에서 제외합니다.
5.2.3 해싱 방식: LSH
해싱은 보통 항목을 짧은 코드로 바꾸되 서로 다른 항목에는 크게 다른 코드를 줍니다. ANN은 여기에 비틀기를 더한 LSH(Locality Sensitive Hashing)를 쓰며, 비슷한 항목이 일부러 같은 코드를 받아 같은 버킷(bucket)에 들어가게 합니다. 구슬을 색깔 비슷한 것끼리 같은 상자에 나눠 담아 두면, 붉은 구슬과 비슷한 것을 찾을 때 붉은 상자만 열면 됩니다.
원문의 그림에서는 모든 벡터를 LSH에 통과시켜 버킷 1(v3, v9, v14), 버킷 2(v1, v7), 버킷 3(v2, v5, v8, v11)에 담습니다. 쿼리에 같은 해싱을 적용해 버킷 3이 나오면 v2, v5, v8, v11하고만 비교합니다.
- 강점: 고정된 단순 규칙으로 빠르고 구현이 단순
- 약점: 정확도가 고르지 않아 진짜 이웃이 다른 버킷에 떨어지면 놓침
- 보완: 해시 테이블을 여러 개 함께 쓰면 놓침이 줄지만 메모리를 더 씀
LSH는 빠르고 단순한 대신 높은 정확도를 얻으려면 메모리를 추가로 내야 합니다. 메모리 예산이 빠듯한 고객에게는 이 거래 조건이 곧 비용 항목이 됩니다.
5.2.4 클러스터링 방식: IVF
클러스터링 방식은 가까운 벡터를 미리 묶어 두고 쿼리에 가까운 묶음만 검색합니다. 이것이 IVF(Inverted File Index)입니다. 한 나라의 사람들을 사는 도시별로 분류하고 도시마다 중심이 있다고 하면, 특정 위치 근처 사람을 찾을 때 가장 가까운 도시 한두 개를 고른 뒤 그 도시의 사람만 봅니다. 나라 전체를 훑지 않습니다.
과정은 두 단계입니다.
- 클러스터 구축(미리 한 번): 모든 벡터를 군집으로 묶고 군집마다 대표 중심점을 둡니다. 데이터의 자연스러운 묶음을 찾는 k-means를 흔히 씁니다.
- 검색(쿼리마다): 쿼리를 극소수의 중심점과만 비교해 가장 가까운 군집 몇 개를 고르고, 그 안의 벡터하고만 비교합니다.
원문 예에서는 군집 A(v1, v4, v8), B(v2, v6), C(v3, v5, v7, v9) 중 쿼리가 C와 가장 가까우므로 v3, v5, v7, v9만 비교합니다. 손잡이는 nprobe이며 열어 볼 군집 수를 정합니다. 많이 열면 정확도가 오르고 느려지며, 적게 열면 빨라지고 정확도가 내려갑니다. 군집 방식은 균형이 좋고 수십억 벡터까지 확장되지만 군집 수 등 조정이 필요합니다.
FAISS 코드로 보면 구조가 한눈에 들어옵니다. 벡터 10만 개(128차원)에 IndexIVFFlat(quantizer, dimension, 100)으로 군집 100개짜리 인덱스를 만들고, index.train(data)로 군집 중심을 학습하며, index.add(data)로 각 벡터를 가장 가까운 군집에 넣습니다. index.nprobe = 10으로 쿼리마다 가까운 군집 10개를 열고, index.search(query, 5)로 최근접 5개의 거리와 위치를 얻습니다. 군집 10개만 열면 데이터 10%만 보므로 전수 탐색 없이 검색이 끝납니다. 검색 결과가 만족스럽지 않다고 할 때 가장 먼저 만질 값이 nprobe입니다.
5.2.5 그래프 방식: HNSW
오늘날 가장 널리 쓰는 ANN은 그래프 기반 HNSW(Hierarchical Navigable Small World)입니다. 그래프는 링크로 이어진 점들의 집합이며, 여기서는 벡터마다 점을 두고 가까운 벡터와 링크로 연결합니다. 쿼리에 가까워지는 방향으로 링크를 따라 점에서 점으로 뛰어 이웃을 찾는 것이 Navigable(항해 가능)의 의미입니다.
Hierarchical은 그래프를 여러 층으로 쌓는다는 뜻입니다. 최상층은 점이 적고 긴 링크가 있으며 아래층일수록 촘촘합니다. 두 도시 사이를 이동할 때 고속도로로 대부분의 거리를 가고(최상층), 간선도로로 갈아타며(중간층), 마지막에 동네 길로 정확한 집에 가는(최하층) 것과 같습니다.
graph LR
    subgraph 최상층
        A1[A] --- F1[F]
    end
    subgraph 중간층
        A2[A] --- C2[C] --- D2[D] --- F2[F]
    end
    subgraph 최하층
        A3[A] --- B3[B] --- C3[C] --- D3[D] --- E3[E] --- F3[F] --- G3[G]
    end
쿼리는 최상층에서 큰 도약으로 알맞은 영역에 들어가고, 층을 내려가며 걸음을 줄여 최하층에서 가장 가까운 점에 닿습니다. 멀리 있는 점은 건드리지 않습니다. 이 탐욕적 도약은 속도와 높은 정확도를 함께 주어 많은 벡터 DB가 내세우는 기본 선택으로 알려져 있습니다. 약점은 그래프가 메모리를 더 쓰고 구축에 다른 방식보다 오래 걸린다는 점이지만, 대부분의 앱에서는 검색 속도가 우선이어서 HNSW가 우세합니다.
5.2.6 방법 선택 기준
네 계열을 한 표로 비교하면 선택 기준이 보입니다.
| 방법 | 핵심 아이디어 | 강점 | 약점 |
|---|---|---|---|
| KD-Tree | 공간을 구역으로 분할 | 단순, 숫자 적은 벡터에서 정확 | 숫자 많으면 실패 |
| LSH | 비슷한 항목을 같은 버킷에 | 빠르고 단순 | 정확도를 위해 메모리 추가 |
| IVF | 군집화 후 가까운 군집 검색 | 수십억까지 확장, 균형 | 군집 조정 필요 |
| HNSW | 층층 그래프를 도약 | 속도와 정확도를 함께 | 구축 시 메모리 더 씀 |
속도와 정확도를 최대로 원하고 메모리가 충분하면 HNSW가 대개 첫째 선택입니다. 데이터가 방대해 메모리를 아껴야 하면 IVF가 훌륭하며, 단순한 저차원 데이터라면 트리로 충분할 수 있습니다. 어느 쪽이든 ANN은 "모든 것과 비교"하는 느린 일을 "알맞은 동네만 보는" 빠른 일로 바꾸며, 벡터 변환, 거리 측정, 구조를 통한 건너뛰기의 순서를 따릅니다.
ANN은 시맨틱 검색(5.3 참조), 추천, 이미지 검색, 얼굴 인식, RAG, 시맨틱 캐싱, 중복 탐지에 쓰입니다. 검색과 RAG 파이프라인에서 ANN은 대략의 후보 목록을 가져오고, 리랭커가 그 목록을 다시 정렬해 관련도 높은 항목을 위로 올립니다(5.5 참조). 숫자 검색을 아예 건너뛰고 모델이 문서 구조를 읽어 알맞은 절에 도달하는 벡터리스 RAG라는 접근도 있습니다.
고객 현장의 판단 기준은 세 가지입니다. 벡터가 몇 차원이고 몇 건인가(저차원이면 트리, 고차원 대규모면 IVF나 HNSW), 메모리 예산이 넉넉한가(넉넉하면 HNSW, 빠듯하면 IVF), 목표 재현율이 몇 퍼센트인가(nprobe 같은 손잡이로 맞춤)입니다. 이 세 질문에 답을 받으면 방법을 정할 수 있습니다.
5.3 시맨틱 검색(Semantic Search)
원문: How does Semantic Search work?
고객이 "우리 문서에서 답을 찾아 주는 검색"을 요구할 때 실제로 구현되는 것이 시맨틱 검색입니다. 임베딩, 코사인 유사도, 벡터 DB, ANN이 한 흐름으로 이어지는 모습을 이해하면 어느 단계가 품질과 비용을 좌우하는지 짚을 수 있습니다. 이 절은 2026년 7월 글 기준입니다.
5.3.1 키워드 검색이 실패하는 경우
검색은 큰 문서 컬렉션과 사용자의 질문(쿼리, query)을 맞대어 질문에 맞는 문서 몇 개를 돌려주는 일입니다. 도움말 문서가 수천 개인 사이트에서 사용자가 "how do I get my money back"을 입력하면 환불에 도움이 되는 문서만 골라내야 합니다. 가장 오래되고 단순한 방식이 키워드 검색(keyword search)이며, 쿼리의 단어와 문서의 단어가 글자 그대로 같은지로 판정합니다.
문서가 세 개 있다고 가정합니다.
- 문서 1: "How to get a refund for your order"
- 문서 2: "Track your shipping and delivery status"
- 문서 3: "Reset your account password"
사용자가 refund를 검색하면 문서 1만 그 단어를 포함하므로 문서 1이 반환됩니다. 사용자가 문서와 같은 단어를 썼기 때문에 잘 동작하며, 빠르고 단순하고 이해하기 쉽다는 장점이 있습니다.
약점은 의미를 전혀 모른다는 점입니다. 문서가 "How to repair your car at home"이고 쿼리가 "fixing my automobile"이면 사람은 둘이 같은 주제임을 바로 압니다.
| 쿼리 단어 | 문서 단어 | 의미 | 글자 일치 |
|---|---|---|---|
| fixing | repair | 같음 | 아니오 |
| automobile | car | 같음 | 아니오 |
일치하는 핵심 단어가 0개이므로 키워드 검색은 쓸모 있는 결과를 돌려주지 못하고, 완벽한 문서가 있어도 사용자는 찾지 못합니다. car와 automobile을 서로 무관한 두 문자열로 취급하기 때문입니다. 사람은 의미로 검색하는데 키워드 검색은 철자로 맞춘다는 차이가 근본 원인입니다.
고객 현장에서는 사내 용어, 동의어, 약어가 섞인 문서에서 이 실패가 자주 드러납니다. 사용자 질문 로그에서 "결과 없음"이거나 엉뚱한 결과가 나온 쿼리를 모아, 단어는 다르지만 의미는 같은 쌍이 얼마나 되는지 세어 보면 시맨틱 검색의 필요를 수치로 보일 수 있습니다.
5.3.2 의미 검색 전체 흐름: 임베딩·유사도·벡터 DB
시맨틱 검색(Semantic Search)은 글자가 아니라 의미로 문서를 찾는 검색입니다. "fixing my automobile"을 검색하면 "repair your car" 문서를 찾아 줍니다. 컴퓨터는 숫자만 다루므로 의미를 비교하려면 먼저 텍스트를 숫자로 바꿔야 합니다. 임베딩(embedding)은 텍스트의 의미를 나타내는 숫자 목록(벡터)이며, 예를 들어 car -> [0.91, 0.12, 0.88, 0.05, ...]입니다. 실제 임베딩은 수백에서 수천 개 숫자이고, 대량의 텍스트를 읽고 단어와 문장의 의미를 학습한 임베딩 모델이 만듭니다.
핵심 성질은 의미가 비슷한 텍스트는 비슷한 숫자를, 의미가 다른 텍스트는 크게 다른 숫자를 받도록 모델이 만들어졌다는 점입니다. 임베딩을 숫자 두 개로 단순화하면 평면의 점으로 그릴 수 있고, car, automobile, vehicle은 서로 가까이 모이며 cat, dog는 동물끼리 가까이 모이되 차 무리와는 멀리 떨어집니다. 컴퓨터가 사람처럼 언어를 이해할 필요 없이 두 점이 얼마나 가까운지만 보면 되고, 가까우면 의미가 비슷합니다.
거리는 코사인 유사도로 잽니다(2.7 참조). 두 임베딩을 화살표로 보고 얼마나 같은 방향을 가리키는지를 한 점수로 나타내며, 1에 가까우면 의미가 아주 비슷하고 0에 가까우면 무관하며 -1에 가까우면 정반대입니다.
| 쌍 | 유사도 | 해석 |
|---|---|---|
| car, automobile | 0.95 | 거의 같은 의미 |
| car, vehicle | 0.88 | 관련된 의미 |
| car, banana | 0.04 | 전혀 무관 |
이 점수가 키워드 검색에는 없던 능력입니다. 이제 car와 automobile은 무관한 문자열이 아니라 아주 가까운 두 점입니다.
이 부품들을 실제 검색 시스템으로 조립하는 데 벡터 DB가 쓰입니다(5.1 참조). 사용자가 검색할 때마다 문서를 임베딩하면 느리고 낭비이므로 미리 해 두고 저장합니다. 흐름은 두 국면으로 나뉩니다.
미리 한 번 하는 준비입니다.
- 컬렉션의 모든 문서를 임베딩 모델에 통과시켜 임베딩으로 만듭니다.
- 임베딩을 벡터 DB에 저장하고, 나중에 사용자에게 보여 줄 원문도 함께 둡니다.
실제 시스템은 문서를 통째로 임베딩하지 않고 먼저 작은 청크로 잘라 조각마다 하나의 분명한 의미를 담게 합니다(5.6 참조).
쿼리마다 하는 검색입니다.
- 사용자가 "fixing my automobile"을 입력합니다.
- 문서에 쓴 것과 같은 임베딩 모델로 쿼리를 임베딩합니다.
- 쿼리 임베딩을 벡터 DB에 넘겨 코사인 유사도로 가장 가까운 저장 임베딩을 묻습니다.
- 유사도가 가장 높은 문서가 반환되며, 이를 최근접 이웃(nearest neighbors)이라 부릅니다.
- 상위 문서를 검색 결과로 보여 줍니다.
원문 예에서는 1위 "How to repair your car at home"(0.93), 2위 "Car maintenance basics"(0.81), 3위 "Replacing a flat tyre"(0.67)가 나옵니다. 1위 문서는 쿼리와 핵심 단어를 하나도 공유하지 않지만 의미가 맞아 검색이 성공합니다.
문서와 쿼리에 반드시 같은 임베딩 모델을 써야 합니다. 서로 다른 모델이면 숫자가 서로 다른 의미 공간에 놓여 가까움 점수가 의미를 잃습니다. 문서 임베딩은 한 번만 계산해 저장하고 검색 때는 쿼리만 임베딩하므로 검색이 빠릅니다. 실제 시스템에서는 이 뒤에 두 번째 모델이 상위 결과를 다시 정렬해 최상위에 가장 좋은 문서를 올리기도 합니다(5.5 참조). 고객이 임베딩 모델을 교체하고 싶다고 하면 저장된 문서 임베딩을 모두 다시 만들어야 한다는 점을 비용에 반영해야 합니다.
5.3.3 대규모에서 ANN으로 속도 확보
가장 가까운 이웃을 완벽히 찾으려면 벡터 DB가 쿼리 임베딩을 저장된 모든 문서 임베딩과 비교해야 합니다. 문서가 수백 개면 문제없지만 실제 시스템은 수백만에서 수십억 개를 다루므로 검색마다 전부 비교하는 것은 너무 느립니다.
해법이 근사 최근접 이웃(ANN)이며(5.2 참조), 영리한 구조로 알맞은 영역 가까이 건너뛰어 소수의 후보만 확인합니다. 결과는 거의 항상 진짜 최근접이지만 매번 완벽하다고 보장하지는 않습니다. 약간의 정확도를 내주는 대신 속도를 크게 얻습니다.
| 방식 | 비교 대상 | 결과 | 규모가 커지면 |
|---|---|---|---|
| 정확 탐색 | 모든 임베딩 | 완벽 | 느려짐 |
| ANN | 작은 부분집합 | 거의 완벽 | 빠르게 유지 |
정확도 99%이면서 수 밀리초에 돌아오는 결과가 수 초 걸리는 완벽한 결과보다 훨씬 낫기 때문에 대형 벡터 DB 다수가 내부에서 ANN을 씁니다. 따라서 시맨틱 검색이 가끔 가장 가까운 문서를 놓친다는 보고를 받으면 ANN의 근사 때문인지, 임베딩 모델 선택이나 청킹 때문인지를 가려서 진단합니다. 소규모 코퍼스에서는 정확 탐색으로 바꿔 결과가 달라지는지 비교하는 것이 가장 빠른 확인법입니다.
5.3.4 실제 적용 사례
시맨틱 검색은 의미로 맞춰야 하는 곳이면 어디든 쓰입니다.
- 검색 자체: 앱, 헬프센터, 웹사이트에서 문서에 있는 정확한 단어를 쓰지 않아도 알맞은 결과를 찾고 사용자가 자연어로 물어도 의도가 전달됩니다. 실제 제품에서는 키워드 검색과 함께 돌리고 결과를 하나의 목록으로 합치는 경우가 많습니다(5.4 참조).
- RAG: 먼저 관련 문서를 가져와 사용자 질문과 함께 LLM에 보내 실제 정보로 답하게 하는 구조입니다. 가져오는 부분이 시맨틱 검색이며, 질문을 임베딩하고 가장 가까운 문서 임베딩을 찾아 모델에 먹입니다. 비공개 문서에 대한 질문에 AI 비서가 정확히 답하는 방식입니다. 가져오는 일이 항상 이렇게 이뤄지는 것은 아니며, 모델이 문서 구조를 단계적으로 읽어 알맞은 절에 도달하는 벡터리스 RAG도 있습니다.
- 추천: 항목을 임베딩해 두고 지금 보는 항목에 가장 가까운 임베딩의 항목을 추천합니다. 검색 쿼리 대신 상품, 노래, 영상에 같은 최근접 이웃 발상을 적용한 것입니다.
전체 흐름은 모든 문서를 한 번 임베딩해 벡터 DB에 저장하고, 쿼리를 같은 모델로 임베딩해 코사인 유사도와 ANN으로 가까운 임베딩을 찾아, 그 문서를 결과로 돌려주는 것입니다. 단어가 하나도 맞지 않아도 의미로 답을 찾습니다.
시맨틱 검색이 항상 키워드 검색보다 낫다고 단정하지 않습니다. 사용자가 같은 대상을 다른 단어로 말할 때는 시맨틱이 낫고, 실제 제품은 둘을 함께 씁니다. 고객 현장에서는 쿼리 로그를 키워드 일치형(제품 코드, 고유명사)과 의미 설명형(자연어 질문)으로 나눠 보고, 어느 쪽이 많은지에 따라 시맨틱 단독으로 갈지 키워드와 병행할지를 판단합니다.
5.4 하이브리드 검색(Hybrid Search)
원문: How does Hybrid Search work?
키워드 검색은 정확한 코드에 강하고 시맨틱 검색은 의미에 강하며, 고객 문서는 대개 두 종류의 질문이 섞여 들어옵니다. 하이브리드 검색은 두 검색을 함께 돌려 하나의 순위 목록으로 합치는 방법입니다. 이 절은 2026년 7월 글 기준입니다.
5.4.1 키워드·시맨틱 각각의 한계
키워드 검색(keyword search)은 쿼리와 같은 단어가 든 문서를 찾는 방식으로, refund policy를 검색하면 모든 문서에서 refund와 policy가 있는지 확인하고 그 단어가 있는 문서, 특히 여러 번 나오는 문서를 위로 올립니다. 대표 알고리즘이 BM25이며 문서마다 쿼리 단어가 얼마나 잘 맞는지를 나타내는 점수(score)를 매기고 높은 점수 순으로 정렬합니다. 점수를 정하는 단서는 두 가지입니다.
- 쿼리 단어가 문서에 얼마나 자주 나오는가: 많이 나올수록 대개 잘 맞는 문서
- 그 단어가 전체 문서에서 얼마나 드문가:
refund처럼 드문 단어가the처럼 흔한 단어보다 더 중요
점수순으로 정렬한 목록이 순위 목록(ranked list)입니다. 키워드 검색은 단어 기반이라 어휘 검색(lexical search)이라고도 부르며, 빠르고 단순하고 정확한 단어를 찾는 데 뛰어납니다.
한계는 의미를 모른다는 점입니다. 문서에 "how to return your shoes"가 있는데 사용자가 "how to send shoes back"을 입력하면 사람은 같은 뜻임을 알지만 키워드 검색은 return과 send back이 다른 단어라 정답 문서를 아주 낮게 매기거나 놓칩니다. 이것이 동의어 문제(synonym problem)이며, car와 automobile, doctor와 physician처럼 철자가 다르면 완전히 무관한 단어로 취급합니다.
시맨틱 검색(semantic search)은 단어가 달라도 쿼리와 의미가 같은 문서를 찾습니다(5.3 참조). 임베딩 모델이 텍스트를 벡터로 바꾸며, 의미가 비슷하면 숫자 목록이 가깝습니다. return your shoes -> [0.91, 0.12, 0.77, ...]과 send shoes back -> [0.89, 0.15, 0.74, ...]은 가깝고, order a pizza -> [0.04, 0.88, 0.21, ...]은 멉니다. 문서를 미리 벡터로 바꿔 두고 쿼리도 벡터로 바꾼 뒤 가장 가까운 문서 벡터를 찾는 것이 벡터 검색(vector search)이며(5.1 참조), 많은 문서에서 빠르게 찾는 데는 ANN이 쓰입니다(5.2 참조). 점수는 벡터 사이의 가까움이고 높을수록 의미가 잘 맞습니다. 동의어와 바꿔 말하기를 잘 처리하지만 자체 약점이 있습니다.
- 대상:
SKU-48217같은 제품 코드,ERR_500같은 오류 코드, 특정 인물 이름, 드문 기술 용어 - 이유: 이런 문자열은 부드러운 의미가 아니라 정확히 일치해야 하는 값이며, 제품 코드에는 사실상 의미가 없음
- 증상: 관련 있어 보이지만 정확한 코드가 없는 문서를 올리고, 정확한 용어가 든 단 하나의 문서를 조용히 놓침
| 검색 | 강한 곳 | 약한 곳 |
|---|---|---|
| 키워드(BM25) | 정확한 단어와 코드 | 동의어, 바꿔 말하기 |
| 시맨틱(벡터) | 의미, 바꿔 말하기 | 정확한 코드, 드문 용어 |
한쪽이 약한 곳에서 다른 쪽이 강하므로 둘을 합칠 이유가 생깁니다. 고객이 오류 코드와 자연어 질문을 모두 입력하는 지원 포털이라면 어느 한쪽만으로는 한 종류의 쿼리를 반드시 놓친다고 보고 설계를 시작합니다.
5.4.2 두 검색을 병렬 실행
하이브리드 검색(Hybrid Search)은 키워드 검색과 시맨틱 검색을 모두 실행해 결과를 하나의 최종 순위 목록으로 합치는 기법입니다. 한 도우미는 정확한 단어와 코드를 잘 잡고 다른 도우미는 의도를 잘 이해할 때, 한 명의 말만 들으면 다른 쪽의 강점을 잃으므로 둘 다에게 물어 답을 합치는 것과 같습니다. 정확한 코드를 검색하면 키워드가 잡고, 같은 생각을 다른 단어로 물으면 시맨틱이 잡으므로 어느 쪽도 잃지 않습니다.
같은 쿼리에 대해 두 검색을 동시에 돌립니다.
- 사용자가 "how to send shoes back"을 입력합니다.
- BM25로 어휘 검색을 해 BM25 점수가 붙은 순위 목록을 얻습니다.
- 동시에 임베딩으로 벡터 검색을 해 쿼리를 벡터로 바꾸고 가장 가까운 문서 벡터를 찾아 가까움 점수가 붙은 순위 목록을 얻습니다.
| 순위 | 목록 A: 키워드(BM25) | 목록 B: 시맨틱(임베딩) |
|---|---|---|
| 1 | Doc-7 (9.1) | Doc-3 (0.95) |
| 2 | Doc-2 (6.4) | Doc-7 (0.88) |
| 3 | Doc-9 (4.2) | Doc-5 (0.81) |
같은 쿼리인데 목록이 다릅니다. 키워드는 단어를 공유하는 Doc-7을 1위로, 시맨틱은 의미가 가장 가까운 Doc-3을 1위로 올렸습니다. Doc-7은 두 목록 모두에 있으며 이는 좋은 문서라는 강한 신호입니다. 이제 두 목록을 한 목록으로 합쳐야 합니다.
두 검색은 서로 의존하지 않으므로 병렬로 실행할 수 있고, 지연은 둘 중 느린 쪽에 좌우됩니다. 고객 환경에서는 두 검색이 같은 저장소에서 지원되는지(예: 한 시스템 안에서 BM25와 벡터를 모두 제공하는지)를 확인하면 운영 부담을 줄일 수 있습니다.
5.4.3 RRF(Reciprocal Rank Fusion)
두 순위 목록을 하나로 합치는 단계를 퓨전(fusion)이라 합니다. 그런데 점수를 그대로 더할 수는 없습니다. Doc-7의 BM25 점수는 9.1이고 시맨틱 점수는 0.88로 척도가 전혀 다릅니다. BM25는 2, 6, 40처럼 정해진 상한이 없는 값이고 시맨틱 가까움 점수는 보통 0과 1 사이이므로, 그냥 더하면 큰 BM25 숫자가 작은 시맨틱 숫자를 눌러 키워드가 항상 이기고 시맨틱은 거의 반영되지 않습니다. 합치는 목적이 사라지는 것입니다.
첫 번째이자 가장 널리 쓰는 방법이 RRF(Reciprocal Rank Fusion)이며, 원점수가 아니라 각 목록 안에서의 순위(rank)만 씁니다. 1위는 9.1점이든 0.88점이든 똑같이 1위이므로 척도 문제가 사라집니다. 역수(reciprocal)는 1을 그 수로 나눈 값이며, 순위의 역수로 점수를 줍니다.
- 1위 문서: 1/1 = 1.00점
- 2위 문서: 1/2 = 0.50점
- 3위 문서: 1/3 ≈ 0.33점
문서마다 두 목록에서 받은 점수를 합산하고 합계가 큰 문서를 최종 목록 위에 둡니다.
| 문서 | 키워드 목록 | 시맨틱 목록 | 합계 |
|---|---|---|---|
| Doc-7 | 1위: 1/1 = 1.00 | 2위: 1/2 = 0.50 | 1.50 |
| Doc-3 | 없음: 0 | 1위: 1/1 = 1.00 | 1.00 |
| Doc-2 | 2위: 1/2 = 0.50 | 없음: 0 | 0.50 |
두 검색이 모두 위에 둔 Doc-7이 이겨 최종 1위가 됩니다. Doc-3은 시맨틱에서만, Doc-2는 키워드에서만 강했습니다. 양쪽이 모두 좋다고 한 문서가 양쪽에서 점수를 모아 자연스럽게 떠오르는 것이 RRF의 장점입니다.
실제 RRF 공식은 순위를 나누기 전에 작은 고정 수를 더해 상위 순위가 나머지보다 지나치게 앞서지 않게 합니다. 이 수를 60으로 두는 구현이 많아서(원문에는 값이 없습니다. 60은 RRF를 제안한 Cormack 등의 2009년 논문이 쓴 값이며 널리 쓰는 관례입니다) 그 경우 Doc-7은 1/61 + 1/62 ≈ 0.0325, Doc-3은 1/61 ≈ 0.0164, Doc-2는 1/62 ≈ 0.0161이 되며 순서는 같습니다. RRF는 단순하고 공정하며 실무에서 잘 동작해 하이브리드 검색에서 널리 쓰이는 퓨전 방법입니다. 사용자 질문의 여러 버전으로 검색한 결과 목록을 하나로 합치는 멀티 쿼리 검색에도 같은 RRF를 씁니다(5.9 참조). 가중치를 따로 조정할 근거 데이터가 없는 초기 구축 단계에서는 RRF를 기본값으로 시작합니다.
5.4.4 가중 합산과 점수 정규화
두 번째 방법인 가중 합산(weighted score combination)은 두 검색의 실제 점수를 쓰되 먼저 척도를 맞추고 가중치로 섞습니다. 척도를 맞추는 작업이 정규화(normalization)이며, 모든 점수를 보통 0과 1 사이의 같은 범위로 재조정하는 일입니다. 서로 다른 단위를 하나의 공통 단위로 바꿔 공정하게 비교하는 것과 같습니다. 정규화 뒤에는 각 검색에 가중치(weight), 즉 중요도를 곱합니다.
최종 점수 = (키워드 가중치 × 정규화한 키워드 점수)
          + (시맨틱 가중치 × 정규화한 시맨틱 점수)
두 가중치를 0.5와 0.5로 두면 둘을 똑같이 신뢰합니다. 문서에 정확한 코드와 제품명이 많다면 키워드를 0.7, 시맨틱을 0.3으로 올리고, 의미가 더 중요하면 반대로 합니다.
앞의 원문 수치로 직접 계산해 보겠습니다(아래 값은 원문 점수를 각 목록의 최고점 1, 최저점 0이 되도록 선형으로 맞춘 재계산 예시입니다). 키워드 목록에서 9.1은 1.0, 6.4는 0.449로, 시맨틱 목록에서 0.95는 1.0, 0.88은 0.5로 바뀝니다. 한 목록에만 있는 문서는 다른 쪽을 0으로 둡니다.
| 문서 | 정규화 키워드 | 정규화 시맨틱 | 0.5 : 0.5 | 0.7 : 0.3 |
|---|---|---|---|---|
| Doc-7 | 1.000 | 0.5 | 0.750 | 0.850 |
| Doc-3 | 0 (없음) | 1.0 | 0.500 | 0.300 |
| Doc-2 | 0.449 | 0 (없음) | 0.224 | 0.314 |
0.5 : 0.5에서는 Doc-3이 Doc-2보다 앞서지만 키워드 쪽 가중치를 0.7로 올리면 Doc-2가 Doc-3을 앞섭니다. 가중치가 순위를 실제로 바꾼다는 점을 보여 줍니다. 세 개짜리 목록에서 최저점을 0으로 만드는 정규화는 거친 방식이어서 실제로는 더 긴 목록으로 계산해야 하며, 이 표는 원리를 보이는 용도입니다.
두 방법의 차이는 다음과 같습니다.
| 항목 | RRF | 가중 합산 |
|---|---|---|
| 쓰는 것 | 각 문서의 순위(위치) | 정규화한 실제 점수 |
| 정규화 필요 | 불필요, 순위는 이미 같은 척도 | 필요, 먼저 정규화해야 함 |
| 조정 | 균형을 조정할 여지가 적음 | 가중치로 세밀하게 조정 |
| 사용 난이도 | 단순하고 기본값으로 잘 동작 | 제대로 쓰려면 더 많은 조정 |
RRF는 쉽고 믿을 만한 기본값이고, 가중 합산은 조정할 준비가 되었을 때 더 세밀한 통제를 줍니다.
하이브리드 검색이 가장 빛나는 곳은 RAG입니다. 검색(retrieval)에서 틀린 문서를 가져오면 모델이 아무리 똑똑해도 틀린 답을 내므로 RAG 품질은 이 단계에 크게 좌우됩니다. 특정 오류 코드를 물으면 키워드가, 같은 질문을 다른 단어로 하면 시맨틱이 잡아서 검색이 정답 문서를 놓치는 일이 드물어지고, 더 나은 검색은 더 나은 답으로 이어집니다. 검색 단계를 더 날카롭게 하는 기법으로는 질문 대신 가상 답변으로 검색하는 HyDE(5.8 참조)와 청크마다 출처 문서 설명을 붙여 인덱싱하는 컨텍스추얼 리트리벌(5.7 참조)이 있습니다. 많은 운영 RAG는 하이브리드 검색 바로 뒤에 리랭커를 두어 가져온 문서를 진짜 관련도 순으로 다시 정렬한 뒤 LLM에 넘깁니다(5.5 참조). 검색에 벡터가 꼭 필요한 것도 아니어서, 값싼 검색으로 큰 컬렉션을 몇 개 문서로 좁힌 뒤 모델이 그 문서의 구조를 읽게 하는 구성도 흔합니다.
고객 현장에서는 쿼리 로그에 코드나 고유명사형 질문이 얼마나 되는지로 키워드 가중치를 정하고, 처음에는 RRF로 시작해 평가 질문 세트에서 정답 문서가 상위에 오는 비율을 보며 가중 합산으로 넘어갈지 판단합니다. 둘을 단순 덧셈으로 합치겠다는 제안이 나오면 척도가 다르다는 점을 먼저 지적합니다.
5.5 리랭커(Reranker)
리랭커(Reranker)는 문서 목록을 받아 질문에 가장 관련 있는 것이 위로 오도록 순서를 다시 매기는 모델입니다. 빠른 1차 검색 뒤에 놓이는 똑똑한 정렬기이며, RAG 답변이 실망스러울 때 가장 먼저 의심하는 부품 중 하나입니다. 이 절은 2026년 6월 글 기준입니다. 도서관에 비유하면 이렇습니다. 초급 도우미가 표지에 "healthy"나 "cooking"이 들어간 책 50권을 빠르게 가져오는 것이 거칠지만 빠른 1차 선별입니다. 그 뒤 선임 사서가 50권을 하나씩 펴서 몇 쪽을 실제로 읽고, 운동선수용 요리책과 식단표와 요리를 한 번 언급하고 마는 책을 가려 최적의 책을 맨 위로 올립니다. 이 선임 사서가 리랭커입니다. 리랭커는 세상 전체를 검색하지 않고, 새 문서를 만들지도 않으며, 누군가 이미 모은 후보 목록의 순서만 바꿉니다.
5.5.1 2단계 검색 구조
현대 검색과 AI 쿼리응답 시스템은 한 단계의 출력이 다음 단계의 입력이 되는 파이프라인으로 동작합니다. RAG(Retrieval-Augmented Generation)는 AI 모델이 답하기 전에 관련 문서를 먼저 가져와 건네, 추측 대신 실제 사실로 답하게 하는 기법입니다.
graph TD
    Q[질문] --> R["리트리버: 후보 문서를 많이 가져옴 (빠르고 거침)"]
    R --> RR["리랭커: 진짜 관련도 순으로 재정렬 (느리고 정밀)"]
    RR --> L["LLM: 최상위 문서를 읽고 답 작성"]
    L --> A[답변]
리랭커는 1차 검색 뒤, LLM이 답을 쓰기 전에 놓이며 LLM이 가장 좋은 자료를 읽도록 정리하는 일만 합니다. 왜 한 모델이 모두 하지 않고 두 단계로 나눌까요. 코퍼스(corpus), 즉 수백만 웹페이지나 수천 개 사내 문서 전체를 질문마다 꼼꼼히 읽는 것이 이상적이지만 그러면 너무 느리고 비싸기 때문입니다.
- 1단계 검색(Retrieval): 빠른 리트리버가 코퍼스 전체를 훑어 대략 관련 있어 보이는 후보 100~200개를 뽑습니다. 속도를 위해 만든 단계이므로 조금 거칠어도 됩니다.
- 2단계 재정렬(Reranking): 리랭커가 그 후보만 질문과 대조해 꼼꼼히 읽고 순서를 바꾼 뒤 상위 5개나 10개만 남깁니다.
100만 개 문서에서 1단계가 100개 후보를 만들고, 2단계가 상위 5개를 남깁니다. 느리고 꼼꼼한 모델을 100만 개 전체에 돌리지 않고 1단계를 통과한 100개에만 돌려 속도와 정확도를 함께 얻습니다. 1단계는 정밀도를 속도와 바꾸고 2단계는 속도를 정밀도와 바꿉니다.
1단계가 정밀하지 못한 이유도 알아야 합니다. 1단계는 보통 두 방식이며 둘을 합친 것이 하이브리드 검색입니다(5.4 참조).
- BM25(키워드): 질문의 단어와 문서의 단어를 맞추고, 더 드물고 의미 있는 단어가 자주 나오는 문서에 가점을 줍니다. 빠르고 잘 동작하지만 정확한 단어만 이해합니다. 문서가 "healthy cooking" 대신 "nutritious recipes"라고 쓰면 뜻이 같아도 단어가 달라 어려워합니다.
- 벡터 검색(시맨틱): 문서를 임베딩이라는 숫자 목록으로 바꿔, 질문 임베딩에 가장 가까운 문서를 찾습니다. 의미를 이해하지만 완벽하지 않습니다.
벡터 검색의 구조적 약점은 질문과 문서가 미리 완전히 따로 임베딩된다는 점입니다. 모델은 질문과 문서를 함께 볼 기회가 없고, 문서 전체를 질문을 보기도 전에 고정된 숫자 목록 하나로 압축하므로 세부가 많이 사라집니다. 예를 들어 "고혈압이면 피해야 할 약은?"이라고 물으면 혈압과 약 일반을 길게 다루는 문서가 어떤 약을 피해야 하는지는 말하지 않아도 벡터 공간에서 아주 가깝게 보입니다. 임베딩은 넓은 주제를 포착하지만 정확한 답은 놓칠 수 있습니다. 그래서 1단계는 좋은 후보 목록을 주지만 "대충 관련 있는" 문서를 "정확히 맞는" 문서 위에 놓기 쉽습니다. 올바른 동네에는 데려다 주지만 올바른 집까지는 못 갑니다. 1단계 자체를 개선하는 방법으로는 질문 대신 가상 답변으로 검색하는 HyDE(5.8 참조)와 LLM이 질문의 여러 버전을 만들어 각각 검색하고 결과를 합치는 멀티 쿼리 검색(5.9 참조)이 있습니다.
5.5.2 Bi-encoder vs Cross-encoder
1차 검색인 벡터 검색은 바이 인코더(bi-encoder) 위에 있고 리랭커는 크로스 인코더(cross-encoder) 위에 있습니다. 이름은 비슷하지만 이 차이가 핵심입니다.
바이 인코더는 bi가 둘을 뜻하듯 질문과 문서를 서로 다른 패스로 따로 인코딩해 별도의 임베딩으로 만들고, 맨 끝에서만 두 임베딩이 얼마나 가까운지 비교합니다. 질문과 문서가 모델 안에서 만나지 않습니다.
BI-ENCODER:   질문 -> [인코더] -> 벡터 A \
                                          거리 비교 -> 점수
              문서 -> [인코더] -> 벡터 B /
장점은 속도입니다. 문서가 각각 독립적으로 인코딩되므로 모든 문서를 미리 한 번 인코딩해 저장해 두고, 질문이 오면 질문만 인코딩해 비교하면 됩니다. 이 많은 벡터를 빠르게 훑는 구조가 ANN 탐색입니다(5.2 참조). 단점은 정밀도입니다. 모델이 사용자가 무엇을 물을지 모른 채 문서의 의미를 정했으므로 어떤 세부가 중요할지 미리 짐작해야 했습니다.
크로스 인코더는 cross가 교차·결합을 뜻하듯 질문과 문서 하나를 이어 붙여 하나의 입력으로 함께 넣습니다. 모델이 둘을 나란히 읽으며 질문의 각 단어를 문서의 각 단어와 직접 연결할 수 있고, 끝에서 이 문서가 이 질문에 얼마나 답하는지를 나타내는 관련도 점수(relevance score) 하나를 냅니다.
CROSS-ENCODER: 질문 + 문서 -> [모델이 함께 읽음] -> 관련도 점수 (예: 0.92)장점은 정확도입니다. 질문과 문서를 동시에 보므로 문서가 피해야 할 약 이름을 실제로 적었는지, 아니면 약을 일반적으로만 말하는지 같은 세부를 잡습니다. 단점은 속도입니다. 질문마다 문서마다 새로 돌려야 하고, 질문이 매번 새로우므로 미리 준비해 둘 수 없습니다. 문서가 100만 개면 질문 하나에 100만 번 돌려야 해서 너무 느립니다.
| 항목 | 바이 인코더 | 크로스 인코더 |
|---|---|---|
| 읽는 방식 | 질문과 문서를 따로 | 질문과 문서를 함께 |
| 출력 | 텍스트마다 임베딩 하나 | 쌍마다 관련도 점수 하나 |
| 속도 | 빠름 | 느림 |
| 정밀도 | 좋지만 세부를 잃음 | 높고 세부를 잡음 |
| 사전 계산 | 가능, 문서를 미리 임베딩 | 불가능, 질문마다 실행 |
| 적합한 곳 | 전체 코퍼스 1단계 검색 | 작은 후보 목록 재정렬 |
계획은 빠른 바이 인코더로 후보를 많이 모으고 정확한 크로스 인코더로 그 후보만 재정렬하는 것이며, 리랭커가 곧 크로스 인코더입니다. 이 때문에 크로스 인코더를 리트리버로 직접 쓸 수 없고 다른 리트리버가 만든 소규모 후보에만 적용할 수 있습니다. 또 리랭커는 리트리버가 놓친 문서를 찾아내지 못합니다. 후보에 아예 없는 문서는 되살릴 수 없으므로, 재정렬 대상이 너무 적으면 1단계가 낮게 매긴 좋은 문서를 놓칠 위험이 있습니다.
5.5.3 문서 점수화 단계
네 개 후보로 리랭커가 하는 일을 따라가 보겠습니다. 질문은 "What is the capital of France?"이고 1단계가 4개 후보를 돌려줍니다.
- 문서 1: "France is a country in Europe known for its food and culture."
- 문서 2: "Paris is the capital and largest city of France."
- 문서 3: "The Eiffel Tower is located in Paris and is very famous."
- 문서 4: "Berlin is the capital of Germany."
- 리랭커가 질문을 문서와 한 쌍씩 짝지어 4개 쌍을 만듭니다.
- 각 쌍을 크로스 인코더에 넣어 질문과 문서를 함께 읽고 관련도 점수를 얻습니다.
- 점수가 높은 순으로 정렬합니다.
- 상위 k개만 남깁니다.
| 쌍 | 점수 | 이유 |
|---|---|---|
| 질문 + 문서 1 | 0.34 | 프랑스를 말하지만 수도는 말하지 않음 |
| 질문 + 문서 2 | 0.97 | 파리가 수도라고 직접 말함 |
| 질문 + 문서 3 | 0.55 | 파리를 언급하지만 질문에 답하지 않음 |
| 질문 + 문서 4 | 0.21 | 독일 이야기, "capital"이라는 단어만 공유 |
정렬하면 문서 2, 3, 1, 4 순서가 되고 top-2를 고르면 문서 2와 3이 남습니다. 재정렬 전 1단계 순서는 문서 1, 4, 2, 3이어서 독일 문서(4)가 capital이라는 강한 단어를 공유한다는 이유로 높았고 정답인 문서 2는 아래에 묻혀 있었습니다. 재정렬 뒤에는 순수하게 관련도 점수로 정렬되어 문서 2가 맨 위로, 문서 4가 맨 아래로 갑니다. 리랭커가 의미를 이해해 1단계의 실수를 고친 것입니다. RAG에서는 남긴 두 문서를 AI 모델에 건네고 모델이 "The capital of France is Paris."처럼 답을 씁니다.
점수 숫자 자체에는 의미가 없고 중요한 것은 그 숫자가 만드는 순서입니다. 따라서 고객 환경에서 "점수 0.5 이상만 사용"처럼 절대 임계값을 쓰려면 반드시 자기 데이터에서 점수 분포를 먼저 확인합니다.
5.5.4 정확도 vs 지연·비용 트레이드오프
크로스 인코더는 강력하지만 느리고 비쌉니다. 질문-문서 쌍마다 모델을 한 번 통과해야 하므로 재정렬할 문서가 늘수록 시간과 돈이 늘어납니다. 여기서 비용은 두 가지이며, 지연(latency)은 사용자가 답을 기다리는 시간이고 다른 하나는 모델 실행에 드는 금전 비용입니다. 쌍 하나가 짧은 순간이면 100쌍은 사용자가 기다릴 만큼 빠르지만, 질문마다 100만 쌍을 돌리면 지독하게 느리고 큰돈이 듭니다.
크로스 인코더를 100만 문서 전체에 -> 극도로 느리고 비쌈 (피함)
크로스 인코더를 상위 100개에만     -> 충분히 빠르고 정확 (이렇게 함)
싸고 빠른 바이 인코더가 수백만 건을 맡고, 비싸고 정확한 크로스 인코더는 작은 후보에만 쓰는 것이 2단계 설계의 이유입니다. 흔한 선택은 100~200개 후보를 가져와 상위 5개나 10개로 줄이는 것입니다. 이렇게 하면 최종 프롬프트가 짧아져 관련 있는 문서가 긴 프롬프트의 중간에 묻히는 현상(lost in the middle, 2.17 참조)도 피합니다. 재정렬할 후보 수는 조정하는 손잡이입니다.
| 후보 수 | 정확도 | 지연·비용 | 위험 |
|---|---|---|---|
| 많이 | 높음 | 느리고 비쌈 | 비용 증가 |
| 적게 | 낮아질 수 있음 | 빠르고 쌈 | 1단계가 낮게 매긴 좋은 문서를 놓침 |
고객 현장에서는 응답 시간 목표(예: 사용자가 기다릴 수 있는 한계)와 쿼리당 비용 예산에서 거꾸로 재정렬 후보 수를 정합니다. 쿼리 100건에서 후보 수를 50, 100, 200으로 바꿔 정답 문서가 상위 5에 들어오는 비율과 응답 시간을 함께 재면 근거 있는 숫자를 고객에게 보일 수 있습니다.
5.5.5 ColBERT식 후기 상호작용
바이 인코더는 빠르지만 거칠고 크로스 인코더는 정밀하지만 느립니다. 그 중간이 후기 상호작용(late interaction) 모델이며 가장 유명한 것이 ColBERT(Contextualized Late Interaction over BERT)입니다. 일반 바이 인코더는 문서 전체를 임베딩 하나로 쥐어짜지만, ColBERT는 문서의 단어마다 작은 임베딩을 따로 유지하고 이를 바이 인코더처럼 미리 계산해 둡니다. 그래서 빠릅니다. 질문이 오면 질문의 단어들을 문서의 단어들과 세밀하게 비교해 가장 잘 맞는 것들을 더합니다. 단어 단위 비교가 뒤늦게(late) 일어나므로 후기 상호작용이라 부르며, 일반 바이 인코더가 잃는 세부를 상당 부분 되찾습니다. 단어 수준에서 비교하므로 바이 인코더보다 정밀하고, 문서 쪽을 미리 계산하므로 크로스 인코더보다 빠릅니다. 논문 수준의 상세는 5.10을 참조합니다.
ColBERT는 파이프라인에서 두 곳에 놓을 수 있습니다.
graph LR
    subgraph 옵션A["옵션 A: 2단계(리랭커)만 ColBERT"]
        Q1[질문] --> R1[리트리버] --> C1[ColBERT] --> L1[LLM]
    end
    subgraph 옵션B["옵션 B: 1단계와 2단계를 ColBERT가 모두"]
        Q2[질문] --> C2[ColBERT] --> L2[LLM]
    end
- 옵션 A의 장점: 기존 빠른 리트리버를 그대로 두고 ColBERT가 그 후보만 재정렬하면 되므로 이미 있는 시스템에 붙이기 쉽습니다. 후보를 즉석에서 인코딩하면 인덱스도 작게 유지할 수 있습니다.
- 옵션 B의 장점: ColBERT가 코퍼스 전체를 단어 수준으로 직접 검색하므로 약한 1단계가 좋은 문서를 재정렬 전에 떨어뜨릴 수 없어 재현율이 더 좋습니다. 대가는 훨씬 큰 인덱스입니다. 작은 후보가 아니라 코퍼스 전체 문서의 모든 단어에 대해 임베딩을 따로 저장해야 하기 때문입니다.
- 일반 크로스 인코더는 옵션 B가 불가능합니다. 질문과 문서를 함께 읽어야 하므로 다른 리트리버가 준비한 소규모 후보에만 작동합니다.
문서 쪽을 다루는 방법도 두 가지입니다.
| 방식 | 저장 용량 | 쿼리 지연 |
|---|---|---|
| 미리 인코딩해 저장(표준) | 큼 | 낮음 |
| 즉석에서 인코딩 | 작음 | 높음 |
표준 ColBERT는 모든 문서를 한 번 인코딩해 단어 수준 임베딩을 저장해 두고 질문 때는 질문만 인코딩해 비교하므로 지연이 아주 낮지만 인덱스가 큽니다. 저장을 건너뛰고 후보 문서를 질문 때 즉석에서 인코딩하면 저장은 줄지만 질문마다 느려집니다. 큰 시스템에서는 한 번 저장해 이후 모든 질문을 빠르게 처리하는 쪽이 보통입니다. 요약하면 바이 인코더는 빠르고 거칠며 크로스 인코더는 느리고 정밀하고 ColBERT는 쓸 만한 중간 선택입니다. 고객이 인덱스 저장소 예산이 빠듯하다면 옵션 B의 큰 인덱스가 걸림돌이 되는지를 먼저 계산합니다.
5.5.6 대표 리랭커
운영에서 쓰는 대표 리랭커는 두 가지로 소개됩니다.
- BGE 리랭커(BGE reranker): BGE는 오픈소스 모델 계열이며 BGE 리랭커는 내려받아 자체 머신에서 돌릴 수 있는 크로스 인코더입니다. 오픈소스이고 무료여서, 전체 통제를 원하거나 데이터를 외부 서비스로 보내고 싶지 않은 팀에서 인기가 많습니다.
- ColBERT: 앞서 본 후기 상호작용 모델로, 리트리버로도 리랭커로도 쓰이며 완전한 크로스 인코더보다 빠르면서 강한 정확도를 원할 때 좋은 선택입니다.
호스팅 재정렬 서비스를 쓰든 BGE 리랭커 같은 자체 호스팅을 쓰든 핵심 동작은 같습니다. 질문을 후보 문서 각각과 함께 읽어 관련도 점수를 내고 그 점수로 순서를 바꿉니다. 원문은 2026년 6월 글 기준으로 두 예만 소개하며 각 모델의 최신 성능과 가격은 다루지 않으므로, 도입 시점에 고객 데이터로 직접 비교해야 합니다. 데이터를 외부로 보낼 수 없는 고객에게는 자체 호스팅이 가능한 오픈소스 리랭커가 선택지가 됩니다.
RAG에서 리랭커가 중요한 이유는 LLM이 좋은 문서를 받아야만 잘 답하기 때문입니다. 1단계가 어중간한 문서를 맨 위에 두면 AI가 어중간한 자료를 읽고 약하거나 틀린 답을 쓰며, RAG 답변이 사람들을 실망시키는 흔한 이유 중 하나입니다. 도움말 시스템에서 "How do I get a refund?"를 물었는데 리랭커가 없으면 단어를 조금 공유한다는 이유로 배송 문서가 AI에 전달되어 답이 헷갈리고, 리랭커가 있으면 환불 정책 문서가 맨 위로 올라와 명확하고 정확한 답이 나옵니다. 작고 한정된 단계지만 시스템 전체 품질을 끌어올립니다. 전체 흐름은 빠른 1단계가 바이 인코더로 거친 후보를 뽑고, 크로스 인코더 기반 리랭커가 질문과 후보를 함께 읽어 점수를 매겨 재정렬하며, 느리고 꼼꼼한 단계를 후보에만 적용해 정확도와 지연·비용을 맞추고, 속도와 정밀도를 함께 원하면 ColBERT 같은 중간 모델을 고려하는 것입니다.
고객 현장에서 RAG 답변이 엉뚱할 때는 정답 문서가 1단계 후보에 있는지, 있다면 몇 위인지를 먼저 봅니다. 후보에 없으면 검색을 고치고, 후보에는 있는데 낮은 순위라면 리랭커 도입이 해법입니다.
5.6 RAG 청킹(Chunking) 전략
원문: How to Chunk Documents for RAG? Chunking Strategies Explained
RAG에서 검색이 실패하면 아무리 좋은 프롬프트와 큰 모델도 답을 살리지 못하며, 검색의 성패는 문서를 어디서 자르느냐에서 갈립니다. 이 절은 2026년 9월 글 기준으로 청킹의 여덟 가지 전략과 오버랩·크기 설정, 흔한 실수를 다룹니다.
5.6.1 나쁜 청킹이 부르는 문제
RAG는 먼저 관련 정보를 찾고(Retrieval), 그것을 질문에 덧붙여(Augmented), 모델이 답을 쓰게 하는(Generation) 시스템입니다. 500쪽짜리 사내 핸드북을 모델이 읽은 적이 없어도, 해당 쪽만 찾아 붙여 주면 재학습 없이 답할 수 있습니다. 오픈북 시험을 치르게 하는 방식입니다. 이때 500쪽을 통째로 보낼 수는 없으므로 문서를 작은 조각, 즉 청크(chunk)로 먼저 자릅니다. 초콜릿 바 한 판이 문서라면 한 칸이 청크입니다.
청킹이 필요한 이유는 네 가지입니다.
- 컨텍스트 윈도우 한계: 모델은 한 번에 읽을 수 있는 토큰 수가 정해져 있습니다. 토큰은 대략 단어의 4분의 3이며 100토큰이 약 75단어입니다. 핸드북은 수백만 토큰이라 들어가지 않습니다(2.16 참조).
- 비용과 속도: 보내는 토큰마다 비용을 내므로 한 문단과 500쪽의 차이는 곧 비용 차이입니다.
- 정확도: 긴 텍스트에서는 필요한 한 줄이 묻히고 두 쪽의 사실이 섞입니다. 짧고 관련 있는 청크 셋이 길고 시끄러운 텍스트보다 낫습니다(2.17 참조).
- 검색 자체가 작은 단위를 요구함: 작은 청크는 의미가 하나이지만, 거대한 청크는 의미 오십 개가 섞여 흐려집니다.
검색은 키워드 검색이 아니라 시맨틱 검색이며 다섯 단계로 움직입니다.
- 각 청크를 임베딩 모델에 통과시켜 숫자 목록(임베딩)을 얻습니다. 같은 내용을 말하는 청크는 서로 가까운 주소를 갖습니다(2.6 참조).
- 이 목록을 벡터 DB에 저장합니다. 자르기, 임베딩, 저장을 합친 일회성 작업이 인덱싱(indexing)입니다(5.1 참조).
- 사용자 질문도 같은 임베딩 모델로 숫자 주소로 바꿉니다.
- 질문 주소와 가장 가까운 청크 상위 3~5개를 고릅니다. 실제 시스템에서는 이 사이에 리랭커가 순서를 다시 정합니다(5.5 참조).
- 선택된 청크를 질문과 함께 모델에 보냅니다.
이 전체 구조는 "청크 하나가 하나의 분명한 의미를 지닌다"는 가정 위에 서 있습니다. 열 가지 무관한 생각이 섞인 청크의 주소는 열 가지의 평균이 되어 어떤 질문과도 가깝지 않게 됩니다.
원문의 실패 사례는 이렇습니다. 핸드북에 "첫해에 유급휴가 24일을 받습니다. 신청은 HR 포털에서 최소 7일 전에 제출합니다"라는 문장이 있고, 글자 수로 자르다 보니 다음처럼 갈렸다고 가정합니다.
| 청크 | 내용 | 문제 |
|---|---|---|
| 청크 1 | "…최소 (여기서 절단)" | 답 직전에서 끝남 |
| 청크 2 | "7일 전에." | 휴가·신청이라는 단어가 없어 주소가 질문과 멀다 |
사용자가 "휴가는 얼마나 일찍 신청해야 하나요?"라고 물으면 정답이 든 청크 2는 검색되지 않고, 청크 1이 검색되어 모델은 "모른다"고 하거나 숫자를 지어냅니다. 나쁜 청크는 작은 문제가 아니라 답을 조용히 파괴합니다. 목표는 완결된 생각이 끝나는 지점에서 자르는 것이며, 그 뒤의 모든 전략은 그 지점을 찾는 더 영리한 방법입니다.
FDE 관점에서는 고객이 "RAG가 엉뚱한 답을 한다"고 할 때 모델이나 프롬프트보다 먼저 정답이 들어 있는 청크가 검색 결과에 있었는지, 그 청크가 중간에 잘린 파편은 아닌지를 확인합니다.
5.6.2 고정 크기·문장 단위 청킹
고정 크기 청킹(fixed-size chunking)은 내용과 무관하게 일정한 글자 수나 토큰 수마다 자르는 방식입니다. 500자마다 자르는 text[i:i + size] 한 줄 반복이면 구현이 끝납니다.
- 장점: 구현이 단순하고 빠르며, 청크 크기가 예측 가능해 모델 한도를 넘지 않고, 구조가 없는 지저분한 텍스트에도 쓸 수 있습니다.
- 단점: 단어, 문장, 생각의 한가운데를 자릅니다. 5.6.1의 휴가 신청 사례가 바로 이 결과입니다.
자르는 위치를 의미가 아니라 개수가 정하는 것이 한계입니다.
문장 단위 청킹(sentence-based chunking)은 먼저 문장으로 나눈 다음 몇 문장씩 묶어 청크로 만드는 방식입니다. 원문 코드는 re.split(r'(?<=[.!?])\s+', text)로 마침표·물음표·느낌표 뒤 공백에서 나누고 5문장씩 묶습니다. 이 작은 변화로 깨진 단어와 반쪽 문장이 사라집니다.
- 장점: 청크가 항상 온전한 문장으로 읽히고, 여전히 단순하고 빠릅니다.
- 단점: 문장 길이가 제각각이라 청크 크기가 고르지 않습니다. 5번째 문장이 한 주제의 끝이고 6번째가 새 주제의 시작이어도 같은 청크에 묶습니다.
문장은 존중하지만 문단과 절은 존중하지 않는다는 뜻입니다. 두 방식은 프로토타입이나 구조 없는 짧은 텍스트에서 출발점으로 쓸 만하고, 운영 품질이 필요한 고객 문서에는 다음 방식들로 올라갑니다.
5.6.3 재귀적 청킹
재귀적 청킹(recursive chunking)은 가장 큰 자연 경계에서 먼저 자르고, 조각이 아직 크면 더 작은 경계로 내려가며 자르는 방식입니다. 실무에서 가장 널리 쓰이며 대부분의 RAG 시스템의 기본값입니다. 문서에는 이미 강도 순서가 있는 경계가 있습니다.
| 경계 | 강도 |
|---|---|
문단 사이 빈 줄 ("\n\n") |
강함 |
줄바꿈 ("\n") |
그보다 약함 |
마침표 (". ") |
더 약함 |
공백 (" ") |
가장 약함 |
먼저 빈 줄에서 자르고, 여전히 청크 크기보다 큰 조각만 줄바꿈으로, 그래도 크면 마침표로, 마지막에 공백으로 내려갑니다. 필요할 때만 목록 아래로 내려가므로 재귀라 부릅니다. 원문 코드는 separators[0]으로 쪼갠 뒤 큰 조각에만 separators[1:]을 넘겨 자기 자신을 다시 호출합니다. 이 코드는 이해를 위한 축약본이며, 실제 구현은 너무 작은 이웃 조각을 청크 크기에 닿을 때까지 다시 합쳐서 한 줄짜리 청크가 쏟아지는 것을 막습니다.
- 장점: 대부분의 청크가 실제 문단과 일치해 완결된 생각을 담습니다. 최악의 경우 공백에서 자르므로 크기 제한을 넘지 않습니다. 거의 모든 문서에서 무난합니다.
- 단점: 의미가 아니라 글의 모양을 따릅니다. 작성자가 한 문단에 무관한 두 생각을 넣었다면 그대로 함께 둡니다.
또한 문서가 이미 제공하는 제목을 무시하고 평문으로만 다룹니다. 어떤 방식을 쓸지 모르겠는 고객 문서라면 재귀적 청킹이 안전한 기본값입니다.
5.6.4 문서 구조 기반 청킹
문서 구조 기반 청킹(document structure based chunking)은 문서에 이미 있는 제목, 절, 표를 따라 자르는 방식입니다. Markdown은 #과 ##, HTML은 <h1>과 <h2>, PDF는 장, 코드 파일은 함수와 클래스가 경계입니다. 작성자가 주제의 끝과 시작을 이미 알려 주었는데 무시하면 낭비입니다.
원문 예시는 # Leave Policy 아래 ## Paid Leave와 ## Sick Leave가 있는 Markdown입니다. ##마다 자르면 유급휴가만 다루는 청크와 병가만 다루는 청크가 나와 섞임이 없습니다. 여기에 한 가지 요령이 더해집니다. 부모 제목을 청크에 함께 실어야 합니다. 둘째 청크를 Leave Policy > Sick Leave라는 제목 경로를 맨 위에 붙여 저장하면, 혼자 떼어 와도 어느 문서의 어느 절인지 알 수 있습니다.
- 장점: 경계를 쓴 사람이 정했으므로 대체로 정확하고, 제목 경로가 청크에 정체성을 줍니다.
- 단점: 구조가 있는 문서에서만 작동합니다. 회의 녹취록이나 스캔한 쪽에는 제목이 없습니다. 절 길이도 들쭉날쭉해서 어떤 절은 두 줄이고 어떤 절은 스무 쪽이므로, 큰 절 안에서는 크기 기반 분할이 따로 필요합니다.
실무에서는 먼저 제목으로 자르고 크기를 넘는 절만 재귀적으로 자르는 조합을 씁니다. 거의 모든 실제 문서가 이 조합으로 처리됩니다. 다만 좋은 제목을 누군가 써 두었다는 전제에 의존하므로, 고객 문서의 제목 품질부터 확인해야 합니다.
5.6.5 시맨틱 청킹
지금까지는 모두 글자, 문장, 문단, 제목 같은 모양을 기준으로 잘랐습니다. 시맨틱 청킹(semantic chunking)은 의미를 측정해 주제가 바뀌는 정확한 지점에서 자르는 첫 번째 방식입니다. 동작은 네 단계입니다.
- 문서를 문장으로 나눕니다.
- 모든 문장을 임베딩으로 바꿉니다.
- 이웃한 문장끼리 의미가 얼마나 비슷한지, 즉 두 주소가 얼마나 가까운지 측정합니다(2.7 참조).
- 같은 주제를 말하는 동안은 유사도가 높아 묶어 두고, 유사도가 갑자기 떨어지면 주제가 바뀐 것이므로 그곳에서 자릅니다.
원문 예시에서 문장 1 "첫해 유급휴가 24일"과 문장 2 "이월되지 않음"은 모두 휴가 이야기라 유사도가 높고, 문장 2와 문장 3 "사내 식당은 오전 8시부터 오후 6시까지"는 주제가 달라 유사도가 급락합니다. 그 급락 지점이 절단점이므로 휴가 청크와 식당 청크가 나오며, 제목이 필요하지 않습니다.
- 장점: 청크가 실제로 한 주제를 다루고, 제목 없는 녹취록과 채팅 로그에서도 작동합니다.
- 단점: 모든 문장을 임베딩해야 청킹을 시작할 수 있어 느리고 비쌉니다. 하락 폭을 얼마로 볼지 정하는 임계값을 조정해야 하며, 너무 민감하면 수백 개의 작은 청크가, 둔하면 소수의 거대한 청크가 나옵니다. 하나의 긴 주제가 흘러가는 문서에서는 뚜렷한 절단점이 나오지 않습니다.
제목이 없는 상담 녹취나 채팅 기록이 핵심 데이터인 고객에게 적합하고, 비용은 문서 전체 문장 수에 비례해 늘어난다는 점을 견적에 반영합니다.
5.6.6 컨텍스추얼·small-to-big 청킹
완벽하게 잘린 청크도 혼자서는 쓸모없을 수 있습니다. 청크가 "한도가 4월부터 18일로 상향되었고 진단서 요건이 폐지되었습니다"라고만 말한다고 가정합니다. 사용자가 "현재 병가 한도는?"이라고 물어도 이 청크에는 병가라는 단어가 없고 "한도"만 있습니다. 전체 문서를 읽은 사람은 두 쪽 위 제목이 병가였음을 알지만, 데이터베이스에 홀로 저장된 청크는 출처의 기억이 없어 주소가 흐려지고 검색되지 않습니다. 맥락을 잃은 청크는 쓸모를 잃습니다.
컨텍스추얼 청킹(contextual chunking)은 저장 전에 각 청크 위에 짧은 맥락 한 줄을 붙여 청크가 홀로 설 수 있게 하는 방식입니다. "직원 핸드북, 휴가 정책 절, 병가에 관한 내용:"을 앞에 붙이면 병가라는 단어, 절, 출처가 모두 들어 있어 질문과 쉽게 맞습니다. 맥락을 만드는 방법은 둘입니다.
- 저렴한 방법: 파일명, 제목 경로 같은 이미 가진 메타데이터로 만듭니다. 추가 비용이 거의 없는데 효과는 큽니다.
- 비싼 방법: 청크와 전체 문서를 언어 모델에 보내 "이 청크가 문서 안에서 무엇에 관한 것인지" 한 줄로 쓰게 합니다. 결과는 더 낫지만 청크마다 모델 호출 비용이 듭니다. 이 아이디어가 컨텍스추얼 리트리벌입니다(5.7 참조).
장점은 "그것", "이", "위의"처럼 대명사가 많은 청크에서 검색 정확도가 크게 오르고, 어떤 다른 전략 위에도 얹을 수 있다는 점입니다. 단점은 비싼 방법이 인덱싱 때 청크당 모델 호출을 요구하고, 맥락 줄이 청크 공간을 일부 차지한다는 점입니다. 원문은 저렴한 방법이 거의 공짜이니 빠뜨리지 말라고 권합니다.
용어 주의: 이 절의 컨텍스추얼 청킹은 맥락 줄을 붙인다는 개념 전반을 가리키며, 5.7의 컨텍스추얼 리트리벌은 비싼 방법을 임베딩과 BM25까지 확장한 구체 기법입니다.
또 하나의 긴장이 남습니다. 작은 청크는 의미가 날카로워 검색은 잘 되지만 모델에게 전달되면 주변 정보가 부족해 답이 빈약하고, 큰 청크는 답할 재료가 풍부하지만 의미가 평균이 되어 검색이 어렵습니다. small-to-big 청킹은 작은 청크로 검색하고 더 큰 주변 조각을 모델에 보내는 방식입니다. 문서를 두 번 자릅니다. 먼저 절 전체 같은 큰 부모 청크로, 그다음 각 부모를 문장이나 짧은 문단 같은 작은 자식 청크로 자릅니다. 벡터 DB에는 자식 임베딩만 저장하되 각 자식에 부모 정보를 기록해 둡니다. 쿼리 시에는 자식을 검색하고, 매칭된 자식은 버린 채 부모를 모델에 보냅니다.
원문 예시에서는 12문장짜리 "병가" 절이 부모이고, "병가는 12일로 제한", "3일 초과 시 진단서 필요", "한도가 18일로 상향" 세 문장이 자식입니다. "병가에 진단서가 필요한가요?"라는 질문에 두 번째 자식이 날카롭게 매칭되지만, 그 한 줄이 아니라 병가 절 전체를 보냅니다. 모델은 일수, 진단서 규칙, 4월 개정을 함께 보고 완전한 답을 씁니다.
- 장점: 정밀한 검색과 풍부한 맥락을 동시에 얻고, 한 가지 크기가 두 역할을 모두 해야 한다는 고민이 사라집니다.
- 단점: 두 단계 청크를 저장·관리해야 해 파이프라인이 복잡해집니다. 최종 프롬프트가 커져 질문당 비용이 늘어납니다. 같은 부모에 속한 자식이 여럿 매칭되면 중복을 제거해야 하며, 그렇지 않으면 같은 부모를 두 번 보냅니다.
긴 규정집이나 계약서처럼 한 절을 통째로 읽어야 답이 나오는 고객 문서에서 고려합니다.
5.6.7 에이전틱 청킹
앞선 전략은 모두 사람이 규칙을 직접 정했습니다. 에이전틱 청킹(agentic chunking)은 문서를 언어 모델에 맡겨 모델이 편집자처럼 읽고 경계를 직접 정하게 하는 방식입니다. 지시문은 "아래 문서를 읽고, 각 조각이 정확히 하나의 완결된 생각을 다루도록 나누십시오. 표나 목록을 중간에 끊지 마십시오. 조각마다 한 줄 제목을 붙이십시오"와 같은 형태입니다. 모델이 돌려준 조각과 제목이 그대로 청크가 됩니다.
- 장점: 두 쪽에 걸친 표, 번호 목록, 절대 끊어서는 안 되는 법률 조항처럼 규칙으로 다루기 어려운 경우를 처리하고, 붙여 준 한 줄 제목이 청크의 무료 맥락 역할을 합니다.
- 단점: 가장 느리고 가장 비쌉니다. 재현성이 없어 같은 문서에 두 번 실행하면 다른 청크가 나올 수 있습니다. 수백만 문서로 확장되지 않습니다.
따라서 계약서, 의료 기록, 금융 공시처럼 소수의 고가치·난잡한 문서에만 씁니다. 나머지는 앞선 전략이 훨씬 실용적입니다. 검색 쪽에서 에이전트가 무엇을 언제 가져올지 정하는 것도 같은 발상입니다(5.14 참조). 고객에게 수만 건 규모를 제안할 때는 에이전틱 청킹을 전체 파이프라인이 아니라 예외 처리 경로로만 둡니다.
5.6.8 청크 오버랩과 청크 크기 선택
어떤 전략을 써도 절단은 어딘가에서 일어나며, 때로 답이 절단선 바로 위에 놓입니다. 절반은 청크 1의 끝에, 절반은 청크 2의 시작에 있어 어느 쪽도 질문에 완전히 답하지 못합니다. 청크 오버랩(chunk overlap)은 한 청크의 마지막 몇 줄을 다음 청크의 시작에 반복하는 안전망입니다.
- 오버랩 없음: 청크 1 끝이 "휴가는 7일 전에 신청해야 합니다."이고 청크 2가 "긴급 휴가는 이 규칙의 예외입니다."로 시작하면, 청크 2만 검색될 때 모델은 "이 규칙"이 무엇인지 모릅니다.
- 오버랩 있음: 청크 2가 "휴가는 7일 전에 신청해야 합니다. 긴급 휴가는 이 규칙의 예외입니다."로 시작해 홀로 완결됩니다.
일반 설정은 청크 크기의 10~20%이며, 500토큰 청크라면 50~100토큰입니다. 오버랩은 공짜가 아닙니다. 반복된 줄은 다시 저장되고 다시 임베딩되어 데이터베이스가 커지고, 너무 크면 같은 텍스트가 여러 번 검색되어 프롬프트 공간을 낭비합니다. 작게 유지합니다.
청크 크기에는 정답이 없지만 신뢰할 만한 판단 기준이 있습니다. 청크 크기는 내 데이터에서 완결된 답 하나의 크기와 맞아야 합니다.
| 데이터 유형 | 답의 크기 | 권장 청크 크기 |
|---|---|---|
| 짧은 사실형 (상품 카탈로그, FAQ, 정의 목록) | 한두 줄 | 약 200~300토큰 |
| 설명·절차 (기술 문서, 정책 핸드북, 튜토리얼) | 한두 문단 | 약 500~800토큰, 대부분 프로젝트의 안전한 기본값 |
| 긴 추론·서술 (논문, 법률 계약, 회의 녹취) | 긴 논증 필요 | 약 1000~1500토큰, small-to-big과 함께 쓰면 더 좋음 |
나만의 값을 찾는 방법은 실제 사용자가 던질 질문 약 20개를 모으는 것입니다. 청크 500, 오버랩 50으로 시스템을 만들어 각 질문마다 정답 청크가 상위 결과에 들어오는지 확인하고, 300과 1000으로 바꿔 같은 20개로 비교하여 이긴 값을 씁니다. 추측이 아니라 실제 질문으로 측정합니다.
임베딩 모델에도 읽을 수 있는 길이의 한도가 있습니다. 청크가 한도보다 길면 초과분은 조용히 버려져 의미 주소에 반영되지 않으므로, 청크 크기는 사용하는 임베딩 모델의 한도 안에 두어야 합니다. 이 한도는 고객이 선택한 임베딩 모델 문서에서 가장 먼저 확인할 항목입니다.
여덟 전략의 비교는 다음과 같습니다.
| 전략 | 자르는 방식 | 비용 | 품질 | 적합한 경우 |
|---|---|---|---|---|
| 고정 크기 | N자마다 | 최저 | 낮음 | 빠른 프로토타입, 지저분한 텍스트 |
| 문장 | 마침표에서 | 최저 | 낮음~중간 | 짧고 깨끗한 텍스트 |
| 재귀적 | 문단, 이어 더 작은 경계 | 낮음 | 좋음 | 대부분 프로젝트의 기본값 |
| 문서 구조 | 제목과 절에서 | 낮음 | 우수 | Markdown, HTML, 제목 있는 PDF |
| 시맨틱 | 주제가 바뀌는 곳 | 높음 | 우수 | 녹취록 등 제목 없는 텍스트 |
| 컨텍스추얼 | 어떤 청크에도 맥락 추가 | 중간~높음 | 우수 | 대명사·참조가 많은 문서 |
| small-to-big | 작게 검색, 크게 전달 | 중간 | 우수 | 전체 맥락이 필요한 긴 문서 |
| 에이전틱 | 모델이 결정 | 최고 | 최상 | 소수의 핵심 난잡 문서 |
표 5.6 — 컨텍스추얼과 small-to-big은 다른 전략을 대체하지 않고 그 위에 얹는 보강입니다.
전략들은 서로 경쟁하지 않습니다. 원문이 권하는 실용 구성은 다음과 같습니다. 문서를 정리하고 제목으로 나눈 뒤, 크기를 넘는 절은 작은 오버랩으로 재귀 분할하고, 모든 청크에 짧은 맥락 줄을 붙이며, 긴 절은 작은 자식으로 검색해 부모를 보냅니다. 만들기 쉽고 운영 비용이 낮으며 거의 모든 경우를 덮습니다. 시맨틱이나 에이전틱 청킹은 필요한 소수 문서에 나중에 추가합니다.
원문이 꼽는 흔한 실수 여섯 가지는 고객 현장의 점검표가 됩니다.
| 실수 | 결과 | 대응 |
|---|---|---|
| 원본 파일을 바로 청킹 | 부주의하게 변환한 PDF의 쪽 번호·머리글·바닥글이 청크에 섞여 의미를 오염 | 청킹 전에 텍스트를 정제 |
| 표와 코드 블록 분할 | 반쪽 표는 표가 없는 것보다 나쁨 | 표, 코드 블록, 목록은 크기 한도를 넘더라도 한 단위로 유지 |
| 메타데이터 미저장 | 검색 필터와 출처 표시 불가 | 원본 파일, 절, 쪽 번호, 날짜를 청크마다 저장 |
| 모든 문서에 단일 청크 크기 | FAQ와 법률 계약은 필요한 크기가 전혀 다름 | 문서 유형별로 설정 |
| 측정 없음 | 한 번 정한 크기를 다시 점검하지 않음 | 작은 테스트 질문 세트로 측정 |
| 변경 후 재인덱싱 누락 | 청크 크기, 오버랩, 임베딩 모델을 바꾸는 순간 저장된 임베딩이 모두 낡음 | 인덱스 전체를 다시 구축 |
문서 전체가 컨텍스트 윈도우에 들어가더라도 청킹은 여전히 필요합니다. 매번 큰 문서를 보내면 느리고 비싸며, 유용한 줄이 묻혀 정확도도 떨어집니다. 한편 청킹 자체를 건너뛰고 모델이 문서 구조를 직접 탐색하게 하는 접근도 있습니다(5.16 참조). 청킹의 한 줄 원칙은 "한 청크는 하나의 완결된 생각을 담고, 혼자 읽어도 말이 되어야 한다"입니다. 고객의 청킹 설계를 검토할 때는 이 원칙을 기준으로 세 가지를 묻습니다. 정답 청크가 혼자서도 읽히는가, 표와 코드가 잘리지 않는가, 설정을 바꾼 뒤 재인덱싱했는가.
5.7 컨텍스추얼 리트리벌(Contextual Retrieval)
원문: How does Contextual Retrieval work?
문서를 청크로 자르는 순간 청크는 "어느 회사의 어느 분기인지" 같은 정보를 잃고, 검색은 그 빈자리에서 실패합니다. 컨텍스추얼 리트리벌은 저장 전에 청크마다 출처 설명을 붙여 이 손실을 되돌리는 기법이며, 이 절은 2026년 10월 글 기준으로 그 동작과 효과, 비용, 적용 한계를 다룹니다.
5.7.1 문맥을 잃은 청크 문제
RAG는 긴 문서를 청크로 잘라 질문과 가까운 청크 몇 개만 LLM에 전달합니다(5.6 참조). 검색이 실패하면 LLM이 엉뚱한 텍스트를 받아 답이 틀립니다. 청크를 찾는 방법은 두 가지이고, 컨텍스추얼 리트리벌은 이 둘을 모두 개선합니다.
| 방식 | 원리 | 강점 | 약점 |
|---|---|---|---|
| 임베딩(시맨틱 검색) | 청크와 질문을 숫자 목록으로 바꿔 가까운 것을 고름 | "비밀번호를 어떻게 재설정하나요"와 "잊어버린 비밀번호 변경 절차"처럼 단어가 달라도 뜻이 같으면 찾음 | 정확 일치에 약함 |
| BM25 | 질문의 단어, 특히 희귀한 단어가 많이 든 청크에 높은 점수를 주는 고전적 키워드 검색 | 오류 코드 TS-999 같은 정확한 단어를 찾음 |
뜻이 같아도 단어가 다르면 놓침 |
임베딩은 TS-999를 "어떤 오류 코드"로만 이해해 아무 오류 코드 청크나 가져오지만, BM25는 TS-999라는 단어 자체를 찾습니다. 그래서 좋은 RAG는 둘을 함께 쓰고 결과를 합칩니다(5.4 참조).
문제는 청크가 잘려 나오는 순간 문맥(context), 즉 그 청크가 무엇에 관한 것인지 알려 주는 주변 정보를 잃는다는 점입니다. 원문 사례는 ACME Corp의 2023년 2분기(Q2 2023) 재무 보고서 한가운데에 있는 청크입니다.
The company's revenue grew by 3% over the previous quarter.사용자가 "ACME Corp의 Q2 2023 매출 성장률은?"이라고 물어도 이 청크에는 "ACME"도 "Q2 2023"도 없습니다. 그 정보는 보고서 1쪽에 있었고 다른 청크로 갔습니다. 따라서 세 가지 문제가 생깁니다.
- 이 청크의 임베딩에 "ACME"나 "Q2 2023"의 의미가 담기지 않아 시맨틱 검색이 상위에 올리지 못합니다.
- BM25는 "ACME"와 "Q2"가 청크에 없으므로 일치를 찾지 못합니다.
- 열 개 회사의 보고서가 있으면 모두 "the company's revenue grew by..."로 시작하는 청크를 갖고 있어 서로 구별되지 않습니다.
책에서 한 쪽을 찢어 건네면서 "그가 문을 열었다"라고 쓰여 있는데 "그"가 누구인지 알 수 없는 상황과 같습니다. 고객 문서 중 "당사", "본 방법", "위 표" 같은 지시어가 많은 문서, 같은 양식이 여러 회사나 여러 버전으로 반복되는 문서가 이 문제에 가장 취약합니다.
5.7.2 컨텍스추얼 임베딩
컨텍스추얼 리트리벌(Contextual Retrieval)은 각 청크를 저장하기 전에 LLM에게 "이 청크가 전체 문서의 어디에 해당하는지" 짧은 설명을 쓰게 하고, 그 설명을 청크 앞에 붙이는 기법입니다. 2024년 Anthropic이 소개했다고 원문은 밝힙니다. 앞의 청크는 다음과 같이 바뀝니다.
This chunk is from an SEC filing on ACME Corp's performance in Q2 2023;
the previous quarter's revenue was $314 million.
The company's revenue grew by 3% over the previous quarter.
앞 두 줄이 LLM이 쓴 맥락 설명이고 마지막 줄이 원래 청크입니다. SEC 공시는 미국 상장사가 정부에 제출하는 공식 재무 보고서입니다. 전체 흐름은 다섯 단계입니다.
- 문서를 청크로 자릅니다. 일반 RAG와 같습니다.
- 청크마다 LLM에 문서 전체와 해당 청크를 주고 짧은 맥락 설명을 쓰게 합니다. 설명은 보통 50~100토큰으로 2~4문장 정도입니다.
- 설명을 청크 앞에 붙여 "문맥화된 청크"를 만듭니다.
- 문맥화된 청크로 임베딩을 만들고 BM25 인덱스에도 넣습니다.
- 질문 시에는 평소처럼 검색하고 상위 청크를 LLM에 줍니다.
flowchart TD
    A[문서] --> B[청크로 분할]
    B --> C[LLM이 청크마다 맥락 설명 작성]
    C --> D[설명 + 청크 = 문맥화된 청크]
    D --> E[임베딩 인덱스]
    D --> F[BM25 인덱스]
    E --> G[질문으로 양쪽 검색]
    F --> G
    G --> H[상위 청크]
    H --> I[LLM 답변]
그림 5.7 — 일반 RAG에서 달라지는 부분은 청크마다 맥락 설명을 쓰는 단계 하나입니다.
Anthropic이 쓴 프롬프트는 <document>{{WHOLE_DOCUMENT}}</document>와 <chunk>{{CHUNK_CONTENT}}</chunk>를 주고, "검색 개선을 위해 이 청크를 문서 전체 안에 위치시키는 짧고 간결한 맥락만 답하라"고 요청합니다. 이 설명은 데이터 준비 때 한 번만 붙이므로 질문 시점에는 추가 LLM 호출이 없고 답변 속도도 느려지지 않습니다.
문맥화된 청크로 만든 임베딩을 컨텍스추얼 임베딩(Contextual Embeddings)이라 부릅니다. 이전에는 "어떤 회사의 매출이 올랐다"였던 의미가 "ACME Corp의 2023년 2분기 매출이 3% 올랐다"로 바뀌므로, ACME의 2분기 성장률을 묻는 질문과 가까워져 상위에 오릅니다. 고객 문서에서 이 기법을 검토할 때는 청크 안에 회사명, 날짜, 절 이름 중 무엇이 빠져 있는지부터 확인합니다.
5.7.3 컨텍스추얼 BM25
문맥화된 청크로 BM25 키워드 인덱스를 만들면 컨텍스추얼 BM25(Contextual BM25)입니다. 전에는 청크에 "ACME"라는 단어가 없어 BM25가 일치시킬 수 없었지만, 이제는 "ACME", "Q2", "2023"이 청크 텍스트 안에 있으므로 높은 점수를 줍니다.
키워드 검색은 이름, 제품 코드, ID, 날짜에 강한데, 청크가 잘릴 때 가장 먼저 잃는 정보가 바로 이런 것들입니다. 맥락 설명이 이 손실을 키워드 쪽에서 메꿉니다. 고객 질문에 제품 코드, 계약 번호, 날짜가 자주 들어간다면 컨텍스추얼 임베딩만이 아니라 BM25 쪽에도 같은 문맥화 청크를 넣었는지가 점검 항목입니다.
5.7.4 결합과 리랭킹
두 검색을 모두 실행해 컨텍스추얼 임베딩의 상위 청크와 컨텍스추얼 BM25의 상위 청크를 가져온 뒤, 중복을 제거해 하나의 목록으로 합칩니다. 두 목록에서 모두 높은 순위인 청크는 최종 순위가 더 좋아집니다. 이것이 하이브리드 검색입니다(5.4 참조).
그다음 리랭커(reranker)를 더할 수 있습니다. 리랭커는 질문과 후보 청크를 함께 읽고 관련도를 정밀하게 점수화하는 모델입니다(5.5 참조). 원문 예시에서 첫 검색이 후보 150개를 가져오면 리랭커가 질문과 하나씩 짝지어 읽고 순서를 다시 정한 뒤 상위 20개만 LLM에 보냅니다. 처음부터 전체 청크에 리랭커를 쓰지 않는 이유는 질문과 청크를 한 쌍씩 읽어 느리기 때문입니다. 수백만 개에 돌리면 시간이 너무 걸리므로, 빠른 검색으로 후보를 추리고 신중한 리랭커로 최종을 고릅니다. 이력서를 빠르게 훑어 150명을 추리고 상세 면접으로 20명을 고르는 채용과 같은 구조입니다. 후보 수와 최종 전달 수는 고객의 지연 한도와 프롬프트 예산에 맞춰 정합니다.
5.7.5 효과와 비용 절감
Anthropic은 코드베이스, 소설, 연구 논문, 과학 논문 등 여러 데이터로 검색 실패율, 곧 정답 청크가 상위 20개 결과에 없는 비율을 측정했습니다. 낮을수록 좋습니다. 원문 표의 감소율은 재계산해도 일치합니다.
| 구성 | 상위 20개 실패율 | 감소율 |
|---|---|---|
| 일반 임베딩 | 5.7% | 기준 |
| 컨텍스추얼 임베딩 | 3.7% | 35% 감소 |
| 컨텍스추얼 임베딩 + 컨텍스추얼 BM25 | 2.9% | 49% 감소 |
| 위 둘 + 리랭킹 | 1.9% | 67% 감소 |
표 5.7 — 맥락 설명만으로 실패의 약 3분의 1이, 키워드 검색과 리랭킹까지 더하면 약 3분의 2가 사라집니다. (5.7 - 3.7) / 5.7 = 35.1%, (5.7 - 2.9) / 5.7 = 49.1%, (5.7 - 1.9) / 5.7 = 66.7%.
이 수치는 Anthropic이 공개한 실험 결과이며 2026년 10월 글 기준입니다. 고객 데이터에서는 값이 달라지므로 자체 질문 세트로 재측정해야 합니다.
비용 쪽의 우려는 청크가 500개인 문서라면 문서 전체를 LLM에 500번 보내야 하지 않느냐는 점입니다. 여기서 프롬프트 캐싱이 쓰입니다. LLM 제공자가 길게 반복되는 프롬프트 부분의 처리 결과를 기억해 두었다가 같은 부분이 오는 다음 요청을 싸고 빠르게 처리하는 기능입니다(4.6 참조). 이 프롬프트에서 문서 전체는 해당 문서의 500개 청크에 대해 동일하고 작은 청크 부분만 바뀌므로, 문서를 캐시에 한 번 올리고 청크마다 재사용합니다. 문서 값은 한 번만 정가로 내고 나머지 호출은 훨씬 쌉니다.
Anthropic은 프롬프트 캐싱과 Claude 3 Haiku(Anthropic의 작고 빠른 LLM)를 사용했을 때 일회성 비용을 문서 토큰 100만 개당 약 1.02달러로 추정했습니다. 2줄짜리 설명을 쓰는 일은 쉬우므로 작고 싼 모델이면 충분합니다. 이 비용은 데이터 준비 때 한 번만 들며, 문서가 바뀌면 바뀐 문서의 설명만 다시 쓰면 됩니다. 모델명과 단가는 원문 시점의 값이므로 고객 견적에는 현재 가격으로 다시 계산합니다.
코드의 핵심은 단순합니다. 청크마다 프롬프트를 채워 call_llm을 호출해 note를 얻고, note + "\n" + chunk로 이어 붙입니다. 인덱싱은 embed_model.embed(contextual_chunks)로 벡터를 만들어 vector_db.add에 넣고 bm25_index.add(contextual_chunks)를 호출하는 것이 전부이며, 나머지 파이프라인은 그대로입니다. 실제 코드에서는 문서 부분에 프롬프트 캐싱을 켜서 반복되는 문서가 매번 정가로 청구되지 않게 합니다.
5.7.6 적용 시점
컨텍스추얼 리트리벌이 잘 맞는 경우는 세 가지입니다.
- 청크가 "그 회사", "이 방법", "위 표"처럼 청크 밖을 가리키는 표현을 자주 쓸 때.
- 여러 회사의 보고서나 한 매뉴얼의 여러 버전처럼 비슷한 문서가 많을 때.
- 사용자가 문서 맨 위에만 나오는 이름, 코드, 날짜로 검색할 때.
한계도 있습니다.
- 데이터 준비 때 청크당 LLM 호출이 한 번씩 듭니다. 대규모 컬렉션에서는 캐싱을 써도 시간과 비용이 듭니다.
- 설명은 LLM이 쓰므로 틀릴 수 있고, 틀린 설명은 검색을 오도합니다.
- FAQ처럼 답마다 질문을 반복해 이미 청크가 자기완결적이면 이득이 작습니다.
- 지식 베이스 전체가 작다면 RAG 자체가 필요 없을 수 있습니다. Anthropic은 약 200,000토큰(약 500쪽) 미만이면 전체를 프롬프트에 넣을 수 있다고 제안합니다.
도메인에 맞게 프롬프트를 바꿀 수도 있습니다. 법률 지식 베이스라면 설명에 사건명과 조항 번호를 항상 적도록 요청합니다. 청크 쪽이 아니라 질문 쪽을 개선하는 기법으로는 모델이 가상 답변을 먼저 쓰고 그것으로 검색하는 방식(5.8 참조)과, 질문을 더 명확한 쿼리 하나나 여러 개로 바꾸는 방식(5.9 참조)이 있습니다.
| 항목 | 일반 검색 | 컨텍스추얼 리트리벌 |
|---|---|---|
| 저장하는 것 | 원본 청크 | 맥락 설명 + 청크 |
| 회사·날짜·절을 아는가 | 청크 안에 쓰여 있을 때만 | 설명이 보탬 |
| 데이터 준비 시 추가 작업 | 없음 | 청크당 LLM 호출 1회 |
| 질문 시 추가 작업 | 없음 | 없음 |
| 비용 | 낮음 | 일회성으로 조금 높음 |
| 검색 품질 | 양호 | 더 좋음, 놓치는 청크 감소 |
표 5.7b — 비용은 데이터 준비 시점에 한 번 들고 질문 시점에는 들지 않습니다.
고객 제안에서는 문서에 지시어가 많은지, 같은 양식의 문서가 몇 벌인지, 지식 베이스가 20만 토큰을 넘는지를 먼저 묻고, 청크가 이미 자기완결적이면 이 기법을 건너뜁니다.
5.8 HyDE(가상 문서 임베딩)
원문: How does HyDE work in RAG?
RAG의 성능은 검색 단계가 정답 텍스트를 찾아내느냐에 달려 있고, 짧은 질문은 긴 답변과 모양이 달라 그 검색에서 불리합니다. HyDE는 질문 대신 모델이 지어낸 답으로 검색해 이 간극을 줄이는 기법이며, 이 절은 2026년 7월 글 기준으로 동작과 장단점, 사용 시점을 다룹니다.
5.8.1 질문으로 검색하는 것의 약점
RAG는 문서를 청크로 나눠 임베딩으로 저장하고, 사용자 질문도 임베딩으로 바꿔 가장 가까운 청크를 고릅니다(5.1, 5.3 참조). 임베딩은 텍스트의 의미를 숫자 목록으로 적은 것이며, 뜻이 비슷한 텍스트는 비슷한 숫자를 갖는다는 것이 기본 규칙입니다. 검색이 엉뚱한 페이지를 가져오면 모델이 틀린 정보를 받아 답도 틀립니다.
문제는 질문과 답이 서로 다른 세계에 산다는 점입니다. 사용자가 "노트북 배터리가 왜 이렇게 빨리 닳죠?"라고 묻는다고 가정합니다. 문서 속 실제 답은 "백그라운드 애플리케이션, 높은 화면 밝기, 낡은 배터리 상태가 배터리 수명을 줄입니다. 안 쓰는 앱을 닫고 밝기를 낮추면 사용 시간이 늘어납니다"일 수 있습니다.
| 구분 | 질문 | 문서 속 답 |
|---|---|---|
| 길이 | 짧음 | 상세함 |
| 쓰는 단어 | "닳는다", "빨리" | "백그라운드 애플리케이션", "밝기", "배터리 상태" |
| 문체 | 질문형 | 설명형 |
문체와 어휘가 다르니 두 임베딩이 항상 가깝지는 않습니다. 질문만으로 검색하면 의미 간극이 커져, 문서에 분명히 있는 완벽한 답을 놓칠 수 있습니다. 고객이 "검색은 되는데 짧은 질문에서만 정답이 안 나온다"고 하면 이 간극을 먼저 의심합니다.
5.8.2 가짜 답으로 검색하는 이유
HyDE(Hypothetical Document Embeddings)는 모델에게 먼저 질문에 대한 가짜 답을 쓰게 하고, 질문 대신 그 가짜 답으로 검색하는 기법입니다. Hypothetical은 지어낸 것, Document는 진짜 답처럼 생긴 텍스트, Embeddings는 그 의미를 숫자로 적은 것입니다. 핵심 발상은 답은 답을 닮았다는 것이며, 진짜 답을 찾으려면 답처럼 생긴 것으로 검색해야 합니다. 이 지어낸 답이 가상 문서(hypothetical document)입니다. 사용자에게 보여 주지도 않고 정확하다고 믿지도 않으며, 더 나은 검색 키, 곧 검색에 쓰는 텍스트로만 씁니다.
가짜 답에 틀린 사실이 있어도 도움이 되는 이유는 사실이 아니라 모양에 있습니다. 배터리 소모에 대한 가짜 답은 자연스럽게 "백그라운드 앱", "화면 밝기", "배터리 상태" 같은, 문서 속 진짜 답과 같은 종류의 단어를 씁니다. 그래서 진짜 답과 가짜 답의 임베딩이 가까워지고, 가까운 임베딩이 강한 검색 일치를 만듭니다.
flowchart LR
    Q["질문: 배터리 빨리 닳음"] -. 멀다 .-> R["진짜 답 청크: 백그라운드 앱, 높은 밝기, 배터리 상태가 수명을 줄임"]
    F["가짜 답: 백그라운드 앱, 밝기, 배터리 상태"] == 가깝다 ==> R
그림 5.8 — 질문은 진짜 답 청크와 멀지만, 같은 어휘를 쓰는 가짜 답은 가깝습니다.
틀린 사실이 섞여도 검색 방향은 맞게 잡히고, 틀린 내용은 뒤 단계에서 버려집니다. 최종 답은 진짜 문서만으로 쓰기 때문입니다. 이 절의 한 줄 요약은 질문으로 검색하지 않고 답 모양의 것으로 검색한다는 것입니다.
5.8.3 단계별 동작과 예제
동작은 여섯 단계입니다.
- 사용자가 질문합니다. 예: "노트북 배터리가 왜 이렇게 빨리 닳죠?"
- 모델에게 "확신이 없어도 이 질문에 대한 짧은 답을 쓰라"고 지시해 가짜 답, 곧 가상 문서를 얻습니다.
- 가짜 답을 임베딩으로 바꿉니다.
- 이 임베딩을 저장된 진짜 문서 청크의 임베딩과 비교해 의미가 가장 가까운 청크를 고릅니다.
- 선택된 진짜 청크와 원래 질문을 모델에 보냅니다.
- 모델이 진짜 청크를 읽고 최종 답을 씁니다. 이 답은 가짜 답이 아니라 실제 문서에 근거합니다.
flowchart TD
    A[사용자 질문] --> B["모델이 가짜 답 작성 (확신이 없어도)"]
    B --> C[가짜 답을 임베딩으로 변환]
    C --> D[저장된 문서 청크 검색]
    D --> E[가장 가까운 진짜 청크 선택]
    A --> F
    E --> F["모델이 진짜 청크만으로 최종 답 작성"]
    F --> G[최종 답]
그림 5.8b — 가짜 답은 중간의 검색 단계에서만 쓰이고, 최종 답에는 진짜 청크와 원래 질문이 들어갑니다.
일반 RAG와 HyDE의 차이는 아래 표와 같습니다.
| 단계 | 일반 RAG | HyDE |
|---|---|---|
| 검색에 쓰는 것 | 사용자의 질문 | 모델이 쓴 가짜 답 |
| 검색 텍스트의 모양 | 짧고 질문형 | 상세하고 답 형태 |
| 진짜 답과의 거리 | 의미상 멀 때가 많음 | 의미상 가까울 때가 많음 |
| 최종 답의 출처 | 진짜 문서 | 진짜 문서 |
원문은 이해를 돕기 위한 가정 수치로 유사도를 0(완전히 다름)에서 1(같은 의미) 사이로 두고, 질문과 진짜 답 청크는 0.55, 가짜 답과 진짜 답 청크는 0.88이라고 예시합니다. 격차는 0.88 - 0.55 = 0.33이며, 실제 값은 모델과 데이터에 따라 달라지므로 구조를 설명하는 숫자로만 읽습니다.
코드의 핵심은 두 함수입니다. hyde_search는 model.generate("Write a short answer to this question: " + question)로 fake_answer를 얻고, model.embed(fake_answer)로 임베딩을 만들어 vector_store.search(..., top_k=5)로 상위 5개 청크를 가져옵니다. 원래 question으로는 검색하지 않는다는 점이 전부입니다. answer_with_hyde는 그 청크를 줄바꿈으로 이어 context를 만들고, "아래 컨텍스트로 질문에 답하라"는 최종 프롬프트에 context와 question을 넣어 모델에 보냅니다. 가짜 답은 청크를 찾는 데만 도움이 되고 최종 답에는 닿지 않습니다.
5.8.4 장단점과 사용 시점
장점은 다음과 같습니다.
- 답 모양의 텍스트로 검색하므로 질문과 답 사이의 간극이 줄어듭니다.
- 더 나은 청크를 찾는 경우가 많아 최종 답이 좋아집니다.
- 사용자의 질문이 짧거나 모호해도 잘 작동합니다.
- 모델을 추가로 학습할 필요가 없고 검색 방식만 바뀝니다.
단점은 다음과 같습니다.
- 가짜 답을 쓰는 모델 호출이 한 번 더 있어 느립니다.
- 그 호출이 추가 연산을 쓰므로 비용이 늘어납니다.
- 가짜 답이 주제에서 벗어나면 검색이 엉뚱한 방향으로 갈 수 있습니다.
- 아주 단순한 질문은 질문 자체로 충분해서, HyDE가 이득 없이 비용만 더합니다.
HyDE는 검색을 영리하게 만드는 대신 약간의 시간과 비용을 치르게 합니다. 질문과 답이 서로 다르게 생긴 경우, 즉 짧은 질문, 고객 지원 티켓, 기술 문서 검색에서 효과가 큽니다. 반대로 짧고 직접적인 조회라면 일반 RAG 검색으로 충분합니다.
선택은 실측으로 합니다. 같은 질문 세트에 일반 검색과 HyDE 검색을 모두 돌려 어느 쪽이 더 나은 청크를 찾는지 비교하고, 이기는 쪽을 데이터에 맞게 채택합니다. 질문 쪽을 개선하는 다른 방법으로 LLM이 질문을 더 명확한 쿼리 하나나 여러 개로 바꾸는 쿼리 재작성이 있고(5.9 참조), 청크 쪽을 개선하는 방법으로 청크마다 출처 설명을 붙이는 컨텍스추얼 리트리벌이 있습니다(5.7 참조).
고객 현장에서는 사용자 질문이 평균 몇 단어인지, 문서가 어떤 어휘로 쓰였는지, 추가 LLM 호출 한 번을 지연 예산이 허용하는지를 묻고, 판단 근거는 두 방식의 같은 질문 세트 비교 결과로 삼습니다.
5.9 쿼리 재작성(Query Rewriting)과 멀티 쿼리 검색
원문: How do Query Rewriting and Multi-Query Retrieval work?
사용자가 입력한 질문은 대개 좋은 검색어가 아니며, RAG는 검색어가 나쁘면 엉뚱한 청크를 가져와 틀린 답을 냅니다. 쿼리 재작성은 LLM으로 질문을 명확한 검색어 하나로 고치고, 멀티 쿼리 검색은 여러 개로 늘려 합치는 방법입니다. 이 절은 2026년 10월 글 기준으로 두 기법의 동작과 병합 방식, 선택 기준을 다룹니다.
5.9.1 질문이 좋은 검색어가 아닌 문제
RAG의 검색 단계는 문서에서 질문과 관련 있는 청크를 골라 LLM에 주며(5.6 참조), 흐름은 사용자 질문 → 검색기 → 상위 청크 → LLM → 답입니다. 리트리버가 잘못된 청크를 가져오면 LLM의 답도 대개 틀립니다. 그리고 검색은 전적으로 검색어(search query), 곧 검색에 쓰는 텍스트에 달려 있습니다. 단순한 RAG는 사용자가 입력한 질문을 그대로 검색어로 쓰지만, 실제 사용자는 완벽한 검색어를 입력하지 않습니다.
| 상황 | 예 | 검색이 실패하는 이유 |
|---|---|---|
| 후속 질문 | "Pro 요금제 환불 정책은?" 다음에 "Basic은요?" | "Basic은요?"만으로는 환불 이야기인지 알 수 없음 |
| 모호한 질문 | "업데이트 후에 그게 안 돼요" | 무엇이, 어떤 업데이트인지 모름 |
| 다른 어휘 | "돈을 돌려받으려면?" vs 문서의 "환불 절차" | 키워드 검색이 일치시키지 못함 |
| 잡음 | "안녕하세요, 팀장님이 물어보라 하셔서, 일 년에 휴가가 며칠이죠?" | 검색에 필요 없는 단어가 대부분 |
| 여러 질문의 결합 | "폰 A와 폰 B의 배터리와 가격을 비교해 줘" | 여러 곳의 정보가 필요 |
모든 경우에 리트리버는 부실한 청크를 가져옵니다. 고객 챗봇 로그에서 실패 질문을 모아 이 다섯 유형 중 어디에 속하는지 분류하면, 개선 수단을 재작성으로 갈지 멀티 쿼리로 갈지 정할 수 있습니다.
5.9.2 쿼리 재작성의 유형
쿼리 재작성(Query Rewriting)은 검색 전에 LLM이 사용자 질문을 명확하고 완전한 검색용 쿼리로 다시 쓰는 단계입니다. 도서관 사서에게 "그 소년 마법사 책 주세요"라고 하면 사서가 "해리 포터"로 검색하는 것과 같습니다. 사서가 쿼리를 다시 쓴 셈입니다. 답은 여전히 사용자의 원래 질문으로 쓰고, 검색에만 재작성된 쿼리를 씁니다.
동작을 원문 예시로 따라가면 다음과 같습니다.
- 지원 봇과 대화 중입니다. 사용자 "Pro 요금제 환불 정책은?", 봇 "30일 이내 전액 환불이 가능합니다.", 사용자 "Basic은요?"
- 검색 전에 대화 기록과 최신 질문을 LLM에 보내 "최신 질문을 필요한 세부 사항을 모두 담은 독립적인 검색어로 다시 쓰고 검색어만 반환하라"고 지시합니다.
- LLM이 "Refund policy of the Basic plan"을 반환합니다.
- 이 검색어로 검색하면 Basic 요금제 환불 청크가 나옵니다.
- 그 청크와 사용자 질문을 LLM에 주면 정확히 답합니다.
재작성은 한 가지 발상이지만 목적에 따라 네 가지로 쓰입니다.
| 유형 | 하는 일 | 예 |
|---|---|---|
| 독립형 재작성(standalone) | 대화 기록으로 후속 질문을 완전한 질문으로 바꿈. 채팅 애플리케이션에서 가장 흔함 | "Basic은요?" → "Basic 요금제 환불 정책" |
| 정리·정제(clarifying and cleaning) | 잡음 제거, 철자 교정, 핵심 단어만 남김 | "안녕하세요, 일 년에 휴가가 며칠이죠?" → "연차 휴가 일수 정책" |
| 확장(expanding) | 문서에 나올 법한 단어를 보탬 | "돈을 돌려받으려면?" → "환불 절차, 반품, 환불 받기" |
| 한 단계 물러서기(step-back) | 지나치게 구체적인 질문을 더 일반적인 질문으로 바꿔 배경 정보를 찾음 | "뭄바이에서 주문 4521이 왜 지연됐나요?" → "주문 배송 지연 사유" |
네 유형 모두 LLM이 쿼리를 바꾼 뒤 검색한다는 같은 패턴입니다. 가까운 사촌이 HyDE로, 쿼리 대신 가상의 답을 쓰고 그것으로 검색합니다(5.8 참조).
코드의 핵심은 rewrite_query와 answer 두 함수입니다. rewrite_query는 chat_history와 question을 넣은 프롬프트로 call_llm을 불러 .strip()한 검색어 하나를 얻습니다. answer는 그 검색어로 retriever.search(search_query, top_k=5)를 실행하고, 찾은 청크와 원래 질문을 LLM에 줍니다. 사용자는 재작성된 쿼리를 보지 못하며 검색에만 쓰입니다. 챗봇처럼 후속 질문이 많은 고객 서비스에서 가장 먼저 도입할 대상입니다.
5.9.3 재작성이 풀지 못하는 문제
쿼리 재작성은 더 나은 쿼리 하나를 줍니다. 그러나 쿼리 하나는 아무리 좋아도 질문을 한 각도에서만 봅니다. 사용자가 "새 폰이 게임에 좋은가요?"라고 묻는다고 가정합니다. 유용한 정보는 프로세서 청크, 화면 주사율 청크, 장시간 사용 시 발열과 배터리 청크에 흩어져 있습니다. "new phone gaming performance" 같은 쿼리 하나는 첫 번째 청크는 찾아도 나머지는 단어가 달라서 놓칩니다.
또 LLM이 쿼리를 조금 잘못 다시 쓰면 대비책이 없습니다. 나쁜 재작성 한 번이 곧 나쁜 검색입니다. 이 두 가지가 재작성의 한계이며, 여러 각도에서 동시에 찾는 방법이 멀티 쿼리 검색입니다. 고객 질문이 여러 측면을 한꺼번에 요구하는 유형이라면 재작성만으로 끝내지 않습니다.
5.9.4 멀티 쿼리 검색
멀티 쿼리 검색(Multi-Query Retrieval)은 LLM이 사용자 질문의 서로 다른 버전을 여러 개 만들고, 각각으로 따로 검색한 뒤 결과를 하나의 목록으로 합치는 방법입니다. 집에서 열쇠를 찾을 때 침실만 보면 놓칠 수 있지만 가족 셋이 침실, 부엌, 차를 동시에 찾으면 찾을 확률이 훨씬 높아지는 것과 같습니다.
게임용 폰 예시의 동작은 다섯 단계입니다.
- 사용자가 "새 폰이 게임에 좋은가요?"라고 묻습니다.
- LLM에게 같은 질문의 검색어 3개를 만들게 합니다. 쿼리 1은 프로세서·그래픽 성능, 쿼리 2는 화면 주사율·터치 반응, 쿼리 3은 고부하 시 발열·배터리 수명입니다.
- 쿼리마다 따로 검색해 각자 상위 청크를 받습니다. 쿼리 1은 프로세서 청크와 벤치마크 청크, 쿼리 2는 디스플레이와 터치 청크, 쿼리 3은 배터리와 발열 청크가 나옵니다.
- 모든 결과를 한 목록으로 합치고 중복을 제거합니다. 같은 청크가 여러 쿼리에서 나올 수 있기 때문입니다.
- 합쳐진 청크와 원래 질문을 LLM에 줘 속도, 화면, 배터리를 아우르는 답을 쓰게 합니다.
flowchart LR
    Q[사용자 질문] --> L[LLM이 쿼리 여러 개 생성]
    L --> Q1[쿼리 1] --> R1[검색 결과 1]
    L --> Q2[쿼리 2] --> R2[검색 결과 2]
    L --> Q3[쿼리 3] --> R3[검색 결과 3]
    R1 --> M[병합]
    R2 --> M
    R3 --> M
    M --> A[LLM 답변]
그림 5.9 — 쿼리 하나가 놓친 정보를 다른 각도의 쿼리가 대신 찾습니다.
많은 시스템은 일반 검색이 찾았을 결과를 잃지 않도록 사용자의 원래 질문도 쿼리 중 하나로 남겨 둡니다. 멀티 쿼리는 "여러 질문이 하나로 묶인" 문제도 풉니다. "폰 A와 폰 B의 배터리와 가격을 비교해 줘"를 "폰 A 배터리", "폰 A 가격", "폰 B 배터리", "폰 B 가격"으로 쪼갤 수 있으며, 큰 질문을 작은 질문으로 나누는 이 일을 쿼리 분해(query decomposition)라 부릅니다.
두 방법의 차이는 아래와 같습니다.
| 항목 | 쿼리 재작성 | 멀티 쿼리 검색 |
|---|---|---|
| LLM 단계의 출력 | 더 나은 쿼리 하나 | 서로 다른 쿼리 여러 개 |
| 검색 횟수 | 1회 | 쿼리마다 1회 |
| 주된 강점 | 후속·모호·잡음 질문 수정 | 여러 곳에 흩어진 정보 탐색 |
| 나쁜 재작성에 대한 안전망 | 없음 | 다른 쿼리가 대비책 |
| 병합 단계 | 불필요 | 필요 (합집합 또는 RRF) |
| 속도와 비용 | 빠름, LLM 호출 1회 추가 | 느림, LLM 호출 1회 추가에 다수 검색 |
| 적합한 용도 | 후속 질문이 있는 채팅 | 폭넓거나 여러 부분으로 된 질문 |
표 5.9 — 재작성은 한 쿼리의 품질을, 멀티 쿼리는 탐색의 폭을 높입니다.
두 방법은 함께 쓸 수 있습니다. 먼저 후속 질문을 독립된 질문으로 재작성하고, 그 깨끗한 질문에서 여러 쿼리를 만듭니다. 에이전틱 RAG에서는 에이전트가 한 걸음 더 나아가 언제 쿼리를 다시 쓰고 언제 다시 검색할지 스스로 정합니다(5.14 참조). 고객이 폭넓은 조사형 질문을 많이 받는 서비스라면 멀티 쿼리를 우선 검토하되, 지연 예산이 빠듯한 채팅이라면 재작성부터 시작합니다.
5.9.5 RRF로 결과 병합
여러 목록을 합치는 가장 단순한 방법은 모든 목록의 청크를 모아 중복만 제거하는 합집합(union)입니다. 동작은 하지만 어떤 청크가 더 중요한지는 알려 주지 않습니다. 더 나은 방법이 RRF(Reciprocal Rank Fusion)이며, 멀티 쿼리 검색에 RRF를 결합한 것을 흔히 RAG-Fusion이라 부릅니다. RRF는 각 목록에서 청크의 순위로 점수를 매기고 모든 목록에 걸쳐 더하는 방식입니다.
RRF 점수 = 모든 목록에 대한 합 1 / (k + rank)
rank는 해당 목록에서의 순위(맨 위가 1)이고 k는 상수로 흔히 60입니다. Reciprocal은 "1을 나눈 값"이라는 뜻이라, 목록 위쪽 청크가 아래쪽 청크보다 큰 점수를 받고 여러 목록에 나온 청크는 각 목록에서 점수를 모읍니다. 원문 예시는 쿼리 3개가 각각 상위 3개를 내놓은 경우입니다.
| 쿼리 | 결과 순서 |
|---|---|
| 쿼리 1 | D2, D5, D1 |
| 쿼리 2 | D5, D3, D2 |
| 쿼리 3 | D5, D2, D4 |
k = 60으로 계산한 결과(재계산해 원문과 일치를 확인)입니다.
| 청크 | 계산 | 점수 | 순위 |
|---|---|---|---|
| D5 | 1/62 + 1/61 + 1/61 | 0.0489 | 1 |
| D2 | 1/61 + 1/63 + 1/62 | 0.0484 | 2 |
| D3 | 1/62 | 0.0161 | 3 |
| D1 | 1/63 | 0.0159 | 공동 4 |
| D4 | 1/63 | 0.0159 | 공동 4 |
D5는 세 목록 모두에서 위쪽이라 1위이고, D2가 근소하게 2위입니다. D3, D1, D4는 목록 한 곳에만 나와 뒤로 밀립니다. RRF는 순위만 쓰고 원점수는 쓰지 않으므로 서로 다른 종류의 검색에서 나온 목록도 합칠 수 있습니다. 그래서 키워드 검색과 시맨틱 검색을 합치는 하이브리드 검색에서도 RRF가 가장 흔한 병합 방식입니다(5.4 참조).
코드 rrf_merge는 각 목록을 enumerate(results, start=1)로 돌며 scores[chunk_id]에 1 / (k + rank)를 더하고 점수 순으로 정렬합니다. 같은 chunk_id는 점수만 더 모으므로 중복 처리가 자동입니다. generate_queries는 LLM에게 서로 다른 각도의 쿼리를 한 줄에 하나씩 쓰게 하고 원래 질문도 목록 앞에 둡니다. multi_query_search가 이를 이어 상위 top_k 청크를 돌려줍니다.
두 방법의 장단점은 함께 봐야 합니다.
- 장점: 문서나 리트리버를 바꾸지 않고 검색을 개선합니다. 재작성은 채팅의 후속 질문을 바로잡고, 멀티 쿼리는 유용한 청크를 더 많이 찾아 재현율(recall)을 높입니다. 키워드 검색, 벡터 검색, 둘의 조합 어느 리트리버와도 함께 씁니다.
- 단점: 둘 다 검색 전에 LLM 호출이 한 번 늘어 시간과 비용이 듭니다. LLM이 다시 쓰다가 버전 번호 같은 중요한 세부 사항을 빼는 식으로 의미를 바꿀 수 있으므로 재작성 프롬프트를 신중히 시험해야 합니다. 멀티 쿼리는 느슨하게 관련된 청크까지 가져와 프롬프트에 잡음을 더할 수 있으며, 병합 뒤에 리랭커를 두면 진짜 관련도 순으로 다시 정렬해 최고만 LLM에 보낼 수 있습니다(5.5 참조). 단순하고 명확한 질문에는 이득 없이 비용만 더합니다.
두 기법은 검색의 질문 쪽을 개선하며, 청크 쪽 개선은 청크마다 출처 설명을 붙이는 컨텍스추얼 리트리벌의 몫입니다(5.7 참조). 고객 현장에서는 재작성 결과에서 버전 번호나 제품명 같은 식별자가 사라지지 않았는지 샘플로 확인하고, 멀티 쿼리 뒤에는 리랭커로 잡음을 거르는 구성을 기본안으로 제시합니다.
5.10 ColBERT: 후기 상호작용(Late Interaction) 검색
원문: What is ColBERT? Late Interaction Retrieval Explained
ColBERT는 느린 BERT 리랭커의 단어 단위 정밀 매칭을 유지하면서도 수백만 개의 문단을 검색할 만큼 빠르게 만든 검색 방식입니다. 이 절은 2026년 8월 글을 기준으로 2020년 논문의 핵심 아이디어, MaxSim 계산, 학습, 인덱스 비용을 수치 예제로 따라갑니다. 논문명은 "ColBERT: Efficient and Effective Passage Search via Contextualized Late Interaction over BERT"이며 Stanford의 Omar Khattab과 Matei Zaharia가 썼습니다. 이름은 Contextualized Late Interaction over BERT의 약자입니다.
5.10.1 bi-encoder와 cross-encoder 두 극단
BERT는 텍스트를 양방향으로 읽어 모든 토큰에 대한 깊은 이해를 만드는 인코더 전용 트랜스포머입니다. ColBERT 이전의 BERT 기반 검색은 두 방식으로 나뉘었고 각각 결함이 있었습니다.
- cross-encoder(정확하지만 느림): 쿼리와 문서를 함께 BERT에 넣어 모든 쿼리 단어가 모든 문서 단어를 참조합니다. 정확도는 높지만 쿼리-문서 쌍마다 BERT를 처음부터 돌려야 하므로 미리 계산해 둘 것이 없습니다. 수백만 문단에서는 현실적으로 불가능하며, 논문은 BERT 리랭커 하나가 쿼리당 10초를 넘는다고 측정했습니다.
- 단일 벡터 이중 인코더(빠르지만 둔함): 쿼리 전체를 벡터 하나로, 문서 전체를 벡터 하나로 만들어 내적 한 번으로 점수를 냅니다. DPR 방식으로, 빠르고 미리 계산할 수 있지만 문단 전체를 벡터 하나에 압축하면서 단어 수준의 세부가 사라져 품질이 떨어집니다. 오늘날 벡터 검색 대부분이 이 방식입니다(5.3 참조).
| 방식 | 입력 구조 | 점수 계산 | 문서 사전 계산 | 단점 |
|---|---|---|---|---|
| cross-encoder | 쿼리와 문서를 함께 BERT에 입력 | BERT가 쌍마다 실행 | 불가 | 느림 |
| 단일 벡터 이중 인코더 | 각각 BERT에 넣어 벡터 1개씩 | 내적 1회 | 가능 | 단어 수준 세부 손실 |
| 후기 상호작용(ColBERT) | 각각 BERT에 넣어 토큰별 벡터 묶음 | MaxSim | 가능 | 인덱스가 큼 |
표 5.10 — 세 번째 줄이 첫 줄의 단어 수준 정밀도와 둘째 줄의 사전 계산을 함께 얻는 자리입니다.
질문은 cross-encoder의 단어 수준 세부를 유지하면서 이중 인코더처럼 문서를 미리 계산할 수 있느냐였고, 세 번째 줄이 그 답입니다. 고객이 "리랭커가 정확하지만 너무 느리다"고 하면 이 세 번째 길이 대안입니다(5.5 참조).
5.10.2 후기 상호작용의 핵심 아이디어
ColBERT의 답이 후기 상호작용(late interaction)입니다. 쿼리와 문서를 각각 따로 토큰별 벡터 묶음으로 인코딩합니다. 문서 인코더는 쿼리를 보지 않으므로 모든 문서의 벡터를 오프라인에서 한 번 계산해 저장할 수 있습니다. 단어 수준의 상호작용은 여전히 일어나지만 늦게, 즉 양쪽을 인코딩한 뒤 BERT 안이 아닌 값싼 연산으로 일어납니다. 단일 벡터 모델에는 토큰 수준 상호작용이 거의 없다는 점이 차이입니다. "쿼리의 모든 단어가 문서에서 짝을 찾는다"는 성질을 유지하되 싸게 처리하는 것입니다.
인코딩 세부는 다음과 같습니다.
- 쿼리와 문서가 하나의 BERT를 공유하며 표지 토큰으로 구분합니다.
- 쿼리에는
[Q]표지를 붙이고, 짧은 쿼리는[MASK]토큰으로 고정 길이까지 채웁니다. BERT가 이 자리를 유용한 추가 용어로 채우므로 학습된 쿼리 확장에 해당합니다. - 문서에는
[D]표지를 붙이고 공간 절약을 위해 구두점 토큰을 버립니다. - 각 토큰 벡터는 작은 크기(128개 숫자)로 투영하고 길이를 1로 맞춥니다(단위 길이). 그래서 문서는 벡터 하나가 아니라 토큰 벡터의 행렬이 됩니다.
단위 길이로 맞추면 코사인 유사도가 곧 내적이 됩니다(2.7 참조). 예를 들어 q1 = [0.6, 0.8, 0.0], d1 = [0.8, 0.6, 0.0]은 둘 다 길이가 √(0.36 + 0.64) = 1이고, 내적은 0.6×0.8 + 0.8×0.6 + 0.0×0.0 = 0.48 + 0.48 = 0.96이며 이 0.96이 곧 코사인 유사도입니다. 요컨대 문서 쪽 계산을 전부 오프라인으로 밀어내는 것이 구조의 요점이며, 고객 시스템에서 색인 시점에 할 일과 쿼리 시점에 할 일을 나누는 기준이 됩니다.
5.10.3 MaxSim 연산: 평균이 아니라 max인 이유
논문의 유일한 수식은 MaxSim입니다.
S(q, d) = Σ_i max_j ( Eq_i · Ed_j )
S(q, d): 쿼리q에 대한 문서d의 관련도 점수Eq_i: 쿼리의 i번째 토큰 벡터,Ed_j: 문서의 j번째 토큰 벡터·: 내적(여기서는 코사인 유사도)max_j: 쿼리 토큰 하나에 대해 모든 문서 토큰 중 가장 잘 맞는 것을 취함Σ_i: 그 최고 점수들을 모든 쿼리 토큰에 걸쳐 더함
말로 풀면 쿼리 토큰마다 가장 잘 맞는 문서 토큰을 찾고 그 점수를 합산합니다. 쿼리 토큰 2개, 문서 토큰 3개의 단위 벡터로 계산합니다.
| 토큰 | 벡터 |
|---|---|
| q1 | [0.6, 0.8, 0.0] |
| q2 | [0.0, 0.6, 0.8] |
| d1 | [0.8, 0.6, 0.0] |
| d2 | [0.0, 0.0, 1.0] |
| d3 | [1.0, 0.0, 0.0] |
1단계로 모든 쿼리 토큰과 문서 토큰의 내적을 구하면 다음과 같습니다(재계산 일치).
| d1 | d2 | d3 | 행의 max | |
|---|---|---|---|---|
| q1 | 0.96 | 0.00 | 0.60 | 0.96 (d1) |
| q2 | 0.36 | 0.80 | 0.00 | 0.80 (d2) |
2단계로 각 행의 최댓값을 잡고, 3단계로 합산해 점수 0.96 + 0.80 = 1.76을 얻습니다. 쿼리 단어마다 문서 안에서 가장 잘 맞는 자리를 찾았고(q1은 d1, q2는 d2), 얼마나 잘 맞았는지를 더한 것입니다. 실제 ColBERT에서는 벡터가 128개 숫자이고 쿼리는 32토큰으로 채우며 문단은 수백 토큰이라 표가 32×300 격자가 되지만 단계는 같습니다.
평균이 아니라 max인 이유는 문서에 쿼리 단어와 잘 맞는 토큰이 하나라도 있으면 나머지가 무관해도 관련 문서이기 때문입니다. 위 q1 행으로 비교합니다.
| 방식 | 계산 | 값 |
|---|---|---|
| MaxSim(max) | max(0.96, 0.00, 0.60) | 0.96 |
| 평균 | (0.96 + 0.00 + 0.60) / 3 = 1.56 / 3 | 0.52 |
평균은 max의 절반 남짓이며 이를 끌어내린 것은 쿼리와 무관한 토큰 d2입니다. 같은 문단에 무관한 토큰이 200개 더 있으면 평균은 0으로 수렴하는 반면 max는 0.96을 유지합니다. 평균은 강한 0.96 일치를 무관한 토큰 속에 묻어 버리므로 max가 맞는 선택입니다.
순위는 후보마다 MaxSim을 계산해 정렬하면 됩니다. 앞의 문서 A는 1.76입니다. 토큰 b1 = [1.0, 0.0, 0.0], b2 = [0.8, 0.0, 0.6]을 가진 문서 B는 q1에 대해 max(0.60, 0.48) = 0.60, q2에 대해 max(0.00, 0.48) = 0.48이므로 점수가 1.08입니다. 1.76 > 1.08이므로 A가 B보다 위입니다. B가 진 이유는 q2에 잘 맞는 토큰이 없어 최선이 0.48인데, A에는 0.80의 d2가 있었기 때문입니다. 긴 문서에 키워드가 한 번만 나와도 강한 점수를 받는다는 점이 MaxSim의 성격이며, 짧은 쿼리가 중요한 용어 하나로 갈리는 고객 도메인에서 이 성질이 유리합니다.
5.10.4 긍정·부정 샘플 학습
점수 계산은 알았지만 BERT가 쿼리 토큰과 문서 토큰이 같은 방향을 가리키도록 스스로 알지는 못합니다. 예시로 가르쳐야 하며 학습 단위는 트리플입니다.
| 구성 | 뜻 |
|---|---|
q |
쿼리 |
d+ |
쿼리에 답하는 문단 (긍정) |
d- |
답하지 않는 문단 (부정) |
트리플 하나마다 d+와 d-에 대해 MaxSim을 두 번 계산해 점수 두 개를 얻고, 목표는 긍정의 점수를 부정보다 높게 만드는 것입니다. 개별 벡터가 어떠해야 한다고 가르치지 않고 두 문서 중 어느 쪽이 이겨야 하는지만 알려 주며, 수백만 트리플을 거치면서 쿼리 토큰과 그에 답하는 문서 토큰이 같은 방향에 놓이게 됩니다. 긍정은 끌어당기고 부정은 밀어내는 이 방식이 대조 학습의 핵심 발상입니다.
손실은 두 점수에 대한 쌍별 Softmax 교차 엔트로피 손실입니다(1.4.3, 1.10 참조). 문서 A(1.76)를 d+, 문서 B(1.08)를 d-라고 하면 다음과 같습니다.
- 각 점수에
e의 거듭제곱을 취합니다. e^1.76 = 5.812, e^1.08 = 2.945. - 합을 구합니다. 5.812 + 2.945 = 8.757.
- 긍정의 값을 합으로 나눕니다. p = 5.812 / 8.757 = 0.664, 곧 올바른 문서를 고를 Softmax 확률입니다.
- 손실은 그 확률의 음의 자연로그입니다. -ln(0.664) = 0.41.
학습으로 두 점수가 벌어져 긍정이 2.5, 부정이 0.5가 되면 e^2.5 = 12.182, e^0.5 = 1.649이므로 p = 12.182 / 13.831 = 0.881이고 손실은 -ln(0.881) = 0.13입니다. 손실이 0.41에서 0.13으로 내려갔고, 손실은 긍정과 부정의 점수 격차가 클 때만 줄어듭니다. 이 단일한 압력이 수백만 트리플에 걸쳐 모든 토큰 벡터가 가리킬 방향을 가르칩니다. 이 학습은 도메인 데이터로 다시 할 수 있으므로, 고객이 자체 쿼리와 정답 문단 쌍을 가지고 있는지는 도입 가능성을 가르는 질문입니다.
5.10.5 대규모 인덱스 크기 비용
MaxSim은 값쌀 뿐 아니라 가지치기에 친화적입니다. 쿼리 토큰마다 벡터 인덱스에서 가까운 문서 토큰을 독립적으로 찾을 수 있어 모든 문서를 채점하지 않아도 됩니다(5.1, 5.2 참조). 그래서 두 모드로 쓸 수 있습니다.
- 리랭킹: 값싼 1단계가 낸 상위 후보를 다시 채점합니다.
- 종단 간 검색: 모든 문서 토큰 벡터를 인덱싱해 수백만 문단에서 곧바로 검색합니다. 근사 최근접 이웃(ANN) 필터가 먼저 후보를 거르고, 남은 것에 정확한 MaxSim을 적용하는 두 단계입니다.
쿼리에 따라 문서 표현이 달라지는 cross-encoder는 이를 할 수 없습니다.
대가는 크기입니다. 문단당 벡터 하나가 아니라 토큰마다 하나씩 저장하므로 인덱스가 훨씬 커집니다. 100토큰 문단 하나를 계산하면 단일 벡터 모델은 1 × 128 = 128개 숫자이고 ColBERT는 100 × 128 = 12,800개 숫자로, 같은 문단에 저장량이 100배입니다. 880만 문단의 MS MARCO에서는 인덱스가 약 154GB가 되며, 단일 벡터 인덱스는 같은 문단에 수 GB면 됩니다. ColBERT는 정확도를 디스크 공간으로 삽니다.
성능은 MS MARCO 문단 벤치마크에서 BERT 리랭커에 근접하면서 비용은 아주 작았습니다.
| 방법 | 품질(MRR@10) | 리랭킹 지연 |
|---|---|---|
| BERT 리랭커 | 34.7 | 약 10,700ms |
| ColBERT(리랭킹) | 34.9 | 약 61ms |
10,700 / 61 ≈ 175배이며 원문은 "약 170배 빠르고 품질은 거의 같다"고 씁니다. 880만 문단 전체에 종단 간으로 돌려도 1초 안에 높은 재현율로 검색했고, 값싼 키워드·단일 벡터 방식보다 품질이 훨씬 좋았다고 합니다. 이 수치는 2020년 논문과 2026년 8월 글 기준의 값이므로 현재 환경에서는 재측정이 필요합니다.
그 뒤의 계보는 크기와 속도를 줄이는 방향으로 이어졌습니다.
| 이름 | 기여 | 원문 수치 |
|---|---|---|
| ColBERTv2 | 잔차 압축: 각 벡터를 가까운 중심점과 작은 보정값으로 저장 | MS MARCO 인덱스 약 154GB를 약 16~25GB로, 6~10배 감소, 원본보다 품질도 좋음 |
| PLAID | 전체 벡터를 만지기 전에 중심점으로 후보를 가지치기 | 지연을 수십 ms 수준으로 |
| ColPali | 문서 이미지(쪽 스크린샷)의 패치에 대해 쿼리 토큰과 MaxSim | 텍스트를 읽지 않고 차트, 표, 스캔 문서 검색 |
재계산하면 154 / 16 = 9.6배, 154 / 25 = 6.2배로 "6~10배"와 일치합니다. 후기 상호작용(다중 벡터)은 이제 단일 벡터 밀집(DPR), 학습된 희소(SPLADE), 키워드 검색과 나란히 주요 검색 방식의 하나이며, RAG의 1단계 리트리버로도 흔히 쓰입니다. 고객에게 ColBERT 계열을 제안할 때는 문서 수 × 평균 토큰 수 × 128개 숫자로 인덱스 크기를 먼저 어림하고, 압축본(ColBERTv2 계열)과 단일 벡터 + 리랭커 구성을 같은 질문 세트로 비교합니다.
5.11 이미지 임베딩(Image Embedding)
원문: How do Image Embeddings work?
텍스트 임베딩이 문장의 의미를 숫자로 바꾼다면, 이미지 임베딩은 사진의 의미를 숫자로 바꿔 라벨 없는 사진도 의미로 검색하게 합니다. 이 절은 2026년 6월 글 기준으로 이미지가 숫자가 되는 과정, 작은 수치 예제, 코드와 활용처를 다룹니다.
5.11.1 이미지 임베딩이 만들어지는 과정
임베딩은 어떤 대상의 의미를 담은 숫자 목록이며, 고정된 크기의 숫자 목록이라는 점에서 벡터라고도 부릅니다(2.6 참조). 컴퓨터는 단어, 문장, 이미지를 직접 이해하지 못하고 숫자만 이해하므로 대상을 숫자 목록으로 바꿉니다. 이미지 임베딩은 이미지의 의미를 나타내는 숫자 목록입니다. 고양이 사진을 특수한 모델에 통과시키면 [0.91, 0.12, 0.77, 0.03, ...] 같은 목록이 나오고 이것이 그 사진의 임베딩입니다. 핵심 성질은 의미가 비슷한 이미지는 임베딩이 서로 가깝다는 것입니다. 고양이 사진 두 장의 임베딩은 가깝고, 고양이 사진과 자동차 사진의 임베딩은 멉니다.
컴퓨터가 이미지를 어떻게 읽는지부터 알아야 합니다. 이미지는 픽셀(pixel)이라는 작은 점들로 이루어지고, 컬러 이미지의 픽셀은 빨강·초록·파랑 세 숫자로 저장되며 각 숫자는 보통 0~255입니다. 100×100 픽셀 이미지는 100 × 100 = 10,000픽셀이고 픽셀마다 숫자가 3개이므로 10,000 × 3 = 30,000개의 숫자입니다. 한 픽셀은 예컨대 (빨강 210, 초록 180, 파랑 90)으로 저장됩니다.
문제는 이 원본 숫자가 각 점의 색만 알려 줄 뿐 의미를 알려 주지 않는다는 점입니다. "이것은 고양이"라는 정보가 없고, 같은 고양이 사진도 조명, 각도, 배경이 다르면 원본 숫자가 전혀 달라집니다. 원본 픽셀은 이미지가 어떻게 보이는지를, 임베딩은 이미지가 무엇을 뜻하는지를 말해 줍니다. 그래서 색 숫자를 의미 있는 숫자로 바꿔야 합니다.
이 변환은 신경망이 맡습니다. 신경망은 사람이 규칙을 쓰는 대신 많은 예시에서 스스로 패턴을 학습하는 모델입니다(1.9 참조). 이미지에는 CNN(Convolutional Neural Network)이나 더 새로운 Vision Transformer를 쓰며, 이름 세부는 몰라도 두 방식의 발상은 같습니다. 아이에게 고양이 사진 수천 장을 보여 주면 뾰족한 귀, 수염, 털, 꼬리라는 패턴을 익혀 처음 보는 사진에서도 고양이를 알아보는 것과 같습니다. 신경망은 이렇게 동작합니다.
- 원본 이미지, 곧 색 숫자 목록이 신경망에 들어갑니다.
- 초반 층이 가장자리와 모서리 같은 단순한 패턴을 찾습니다.
- 중간 층이 이를 눈, 귀, 바퀴 같은 더 큰 패턴으로 결합합니다.
- 깊은 층이 이를 고양이 얼굴 전체나 자동차 같은 객체로 결합합니다.
- 끝부분에서 발견한 모든 것을 요약한 짧은 숫자 목록을 내놓고, 이것이 이미지 임베딩입니다.
| 신경망 | 아이의 비유 |
|---|---|
| 원본 이미지(색 숫자) | 눈으로 사진을 봄 |
| 초반 층: 가장자리 | 단순한 선과 모서리를 알아챔 |
| 중간 층: 부분 | 귀, 눈, 수염을 알아챔 |
| 깊은 층: 객체 | 고양이 전체를 알아봄 |
| 최종 임베딩 | "이것은 고양이"라는 이해 |
표 5.11 — 층이 깊어질수록 이해가 한 단계씩 커지고, 마지막 층의 요약이 임베딩입니다.
수백만 장으로 학습하면 네트워크는 비슷한 이미지를 숫자 공간에서 가깝게 놓도록 스스로 배우며, 그 규칙을 사람이 쓰지 않아도 됩니다. 고객이 "이미지를 어떻게 검색에 쓰느냐"고 물으면 원본 픽셀을 비교하는 것이 아니라 신경망의 최종 요약을 비교한다고 설명합니다.
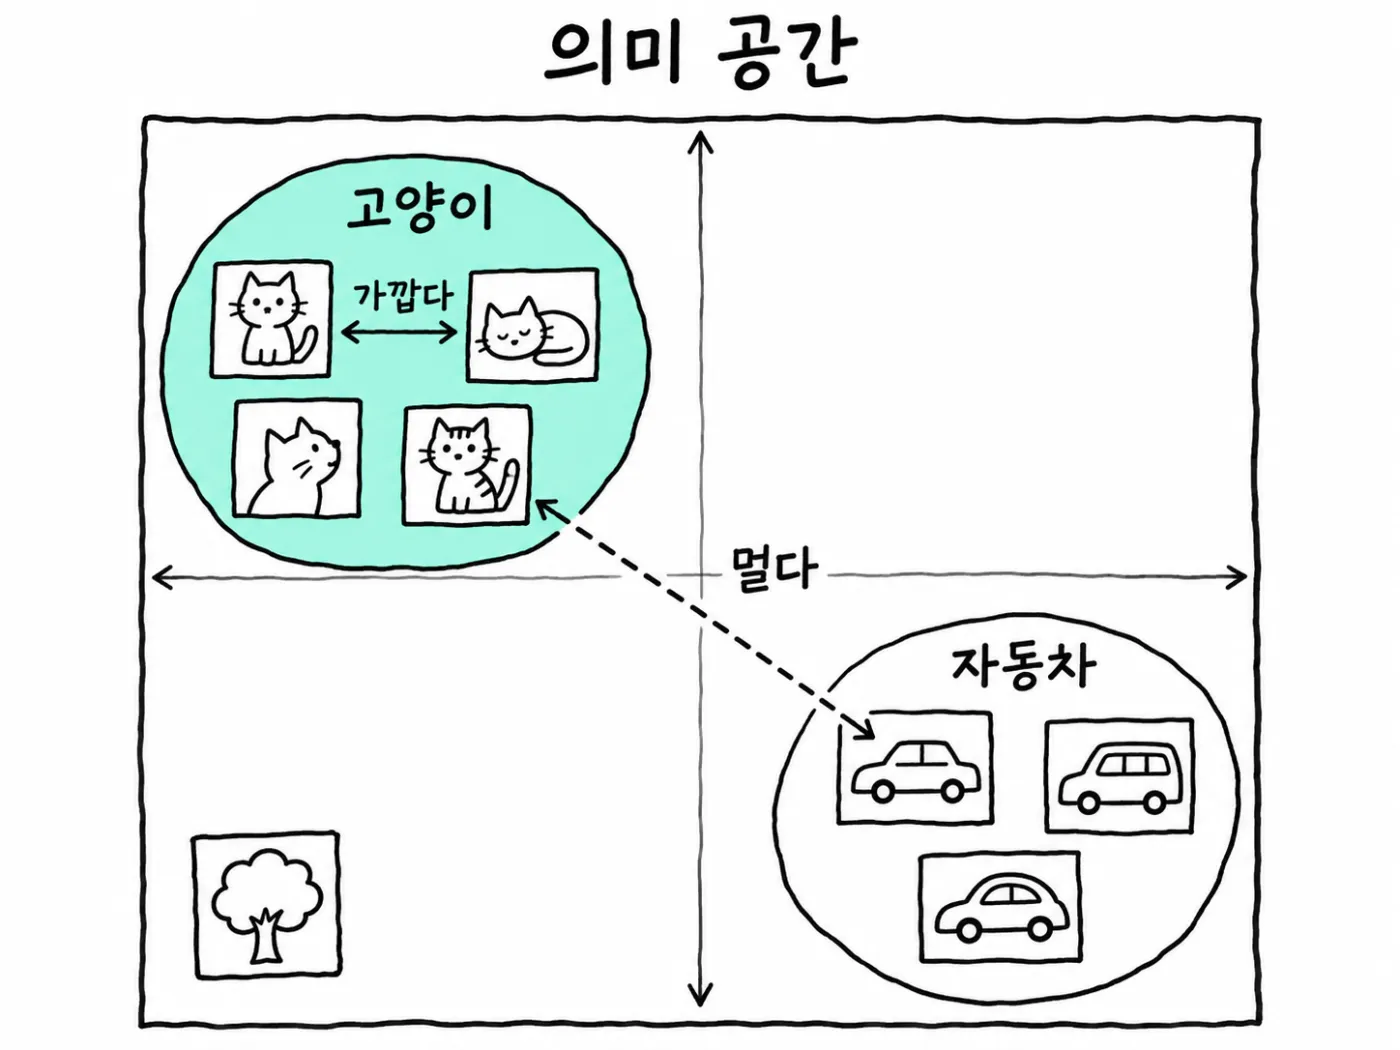
5.11.2 수치 예제로 보는 유사도
설명을 위해 임베딩이 숫자 3개뿐이라고 가정합니다. 실제 임베딩은 수백에서 수천 개이지만 3개로 원리를 볼 수 있습니다. 사진 세 장을 신경망에 통과시켜 다음 임베딩을 얻었습니다.
| 사진 | 임베딩 |
|---|---|
| 고양이 A | [0.90, 0.10, 0.05] |
| 고양이 B | [0.88, 0.12, 0.07] |
| 자동차 C | [0.10, 0.95, 0.85] |
고양이 A와 B는 숫자가 거의 같고 자동차 C는 완전히 다릅니다. 숫자 공간에서 A와 B는 서로 가까이 모이고 C는 멀리 떨어집니다. "고양이 A와 가장 비슷한 사진은?"이라고 물으면 컴퓨터는 숫자를 비교해 고양이 B를 답하며, 숫자가 먼 자동차 C는 고르지 않습니다.
두 숫자 목록이 가까운지 먼지는 거리를 재서 판단하며, 가장 흔한 방법이 코사인 유사도입니다. 두 목록이 같은 방향을 가리키는지 확인하는 값이고 범위는 -1에서 1입니다(2.7 참조).
| 값 | 의미 |
|---|---|
| 1에 가까움 | 거의 같은 이미지 |
| 0에 가까움 | 관련 없음 |
| -1에 가까움 | 반대 |
위 예제를 직접 계산하면 다음과 같습니다.
| 쌍 | 코사인 유사도 |
|---|---|
| 고양이 A - 고양이 B | 약 0.999 |
| 고양이 A - 자동차 C | 약 0.196 |
| 고양이 B - 자동차 C | 약 0.230 |
원문은 A와 B의 값이 "1에 아주 가깝다"고만 서술하며, 계산하면 0.999로 확인됩니다. 같은 종류의 사진 쌍은 1에 붙고 다른 종류는 0.2 안팎으로 벌어집니다. 이 값은 3차원 가정 예제이므로 실제 서비스에서 몇 이상을 비슷하다고 볼지는 쓰는 모델과 데이터에서 측정한 분포로 정합니다. 고객이 "유사도 몇 점부터 같은 이미지로 봅니까"라고 물으면 고정된 숫자가 아니라 라벨이 있는 샘플 쌍에서 구한 경계라고 답합니다.
5.11.3 활용처
이미지 임베딩이 필요한 이유는 사진에 라벨이 없을 때 드러납니다. 구글 포토 같은 앱에 사진 100만 장이 있고 사용자가 "beach"를 검색한다고 가정합니다. 사진 밑에 "beach"라고 적어 둔 사람이 없습니다. 원본 픽셀을 하나씩 비교하는 방법은 느리고 의미를 모릅니다. 각도가 다른 두 해변 사진은 픽셀 수준에서 완전히 달라 보이지만 같은 뜻입니다. 그래서 모든 사진을 임베딩으로 바꾸고 "beach"라는 단어도 임베딩으로 바꾼 뒤, 단어 임베딩에 가장 가까운 사진 임베딩을 찾습니다(5.2, 5.3 참조). 수백만 장에서 가장 가까운 임베딩을 빠르게 찾는 것이 벡터 DB가 존재하는 이유입니다(5.1 참조).
코드로는 sentence_transformers의 사전학습 모델을 불러와 몇 줄이면 됩니다.
from sentence_transformers import SentenceTransformer, util
from PIL import Image

model = SentenceTransformer("clip-ViT-B-32")   # 이미지 임베딩을 만드는 기성 모델
cat_embedding = model.encode(Image.open("cat.jpg"))
dog_embedding = model.encode(Image.open("dog.jpg"))
print(cat_embedding.shape)                     # (512,)
print(util.cos_sim(cat_embedding, dog_embedding))clip-ViT-B-32는 이미 이미지를 임베딩으로 바꿀 줄 아는 모델이라 직접 학습할 필요가 없습니다.model.encode()가 임베딩을 돌려주며 출력(512,)는 이미지 한 장이 의미 있는 숫자 512개로 요약된다는 뜻입니다.util.cos_sim이 두 임베딩의 코사인 유사도를 계산합니다. 고양이와 개는 둘 다 동물이라 값이 어느 정도 높고, 고양이와 자동차라면 훨씬 낮습니다.
같은 clip-ViT-B-32 모델은 "beach" 같은 단어도 임베딩으로 만들 수 있어 단어 임베딩과 이미지 임베딩을 직접 비교할 수 있고, 단어를 입력해 사진을 검색하는 기능이 이렇게 작동합니다. 텍스트와 이미지를 같은 임베딩 공간에 놓는 모델을 멀티모달 모델이라 부릅니다(3.4 참조). 모델 이름과 차원 수(512)는 2026년 6월 글의 예시 값이며, 모델마다 다릅니다.
활용처는 다음과 같습니다.
| 활용 | 동작 |
|---|---|
| 이미지 검색 | "beach", "birthday" 같은 단어를 입력하면 임베딩 비교로 일치하는 사진을 찾음 |
| 유사 상품 검색 | 쇼핑 앱에서 신발 사진을 올리면 비슷한 신발을 보여 줌 |
| 중복 사진 탐지 | 휴대폰 갤러리가 비슷하거나 중복된 사진을 묶음 |
| 얼굴 그룹화 | 같은 사람의 사진을 임베딩으로 묶음 |
| 추천 시스템 | 좋아한 이미지·영상과 비슷한 것을 추천 |
사진마다 라벨을 달 필요가 없다는 점이 도입 비용을 크게 낮춥니다. 고객이 라벨 없는 이미지 자산(상품 사진, 현장 사진, 스캔 문서)을 쌓아 두었다면, 라벨링 프로젝트 대신 기성 멀티모달 임베딩 모델과 벡터 DB로 검색부터 시험해 볼 수 있는지 판단합니다. 그 판단은 검색 쿼리가 단어인지 이미지인지, 그리고 비슷하다고 보는 경계를 샘플로 측정할 수 있는지에 달려 있습니다.
5.12 임베딩 캐시(Embedding Cache)
원문: How does an Embedding Cache work?
임베딩을 계산하는 일은 돈과 시간이 드는 호출입니다. 같은 텍스트를 반복해서 계산하면 같은 비용을 반복해서 내므로, 한 번 계산한 결과를 저장해 두고 다시 쓰는 장치가 필요합니다. 이 절은 2026년 6월 글 기준으로 임베딩 캐시의 키 설계, 요청 흐름, 퇴출 정책, 저장 위치를 설명합니다.
5.12.1 캐시 키: 텍스트와 모델의 해시
임베딩 캐시는 이미 계산한 임베딩을 저장해 두었다가, 같은 텍스트가 다시 오면 임베딩 모델을 부르지 않고 저장본을 돌려주는 저장소입니다. 임베딩은 텍스트의 의미를 나타내는 숫자 목록이고(2.6 참조), 이를 얻으려면 임베딩 모델에 텍스트를 보내야 합니다. 호스팅 모델이면 보낸 텍스트 양만큼 요금을 내고 네트워크 지연도 기다리며, 자체 서버에서 돌려도 연산 자원과 시간이 듭니다. 같은 텍스트를 여러 번 계산하는 것은 같은 일에 반복해서 값을 치르는 일입니다.
캐시에 물건을 넣고 꺼내려면 키(key)가 필요합니다. 키는 보관 항목에 붙이는 이름표이며, 서류 캐비닛의 폴더 이름과 같습니다. 가장 단순한 선택은 텍스트 자체를 키로 쓰는 것이지만 두 가지 문제가 있습니다.
- 문단 하나가 통째로 키가 되면 키가 길고 다루기 불편합니다.
- 같은 텍스트라도 임베딩 모델이 다르면 결과 벡터가 다릅니다. 모델 버전만 올려도 값이 달라집니다.
두 번째 문제가 치명적입니다. 구형 모델과 신형 모델에 return policy를 각각 보내면 서로 다른 숫자 목록이 나오는데, 키가 텍스트뿐이라면 두 모델이 같은 칸을 쓰게 됩니다. 신형 모델이 구형 모델의 임베딩을 읽어 가는 이런 사고를 충돌(collision)이라 하며, 서로 다른 것이 우연히 같은 키에 놓이는 현상을 뜻합니다. 충돌은 오류 메시지 없이 검색 품질만 조용히 떨어뜨리므로 발견이 어렵습니다.
규칙은 하나입니다. 키는 텍스트에 모델 이름과 버전을 합쳐서 만듭니다. 이 합친 값을 해시(hash)에 넣어 짧고 고정된 길이의 문자열로 줄입니다. 해시는 같은 입력이면 항상 같은 결과를 내고, 입력이 한 글자만 달라도 전혀 다른 결과를 내는 함수입니다.
text  = "return policy"
model = "text-embedding-v3"   (이름과 버전)
key   = hash(model + text)    → "d1abc1cd0579..." (짧고, 모델별로 유일)
위 d1abc1cd0579는 SHA-256으로 text-embedding-v3와 return policy를 줄바꿈 문자로 이어 붙여 계산한 앞 12자리이며, 텍스트 끝에 공백 하나만 더해도 44fc9e5d0dac로 바뀝니다. 이 성질 때문에 해시 키는 정확히 같은 텍스트와 같은 모델 조합에서만 히트합니다. 의미가 비슷한 문장은 다른 키가 되므로 히트하지 않으며, 그런 재사용은 시맨틱 캐싱의 몫입니다(5.13 참조).
고객 환경에서는 "임베딩 모델 버전을 올렸을 때 캐시가 오염되지 않는가"를 먼저 묻습니다. 키에 모델명과 버전이 들어 있는지가 그 답입니다.
5.12.2 히트·미스 요청 흐름
캐시 조회 결과는 둘 중 하나입니다. 캐시 히트(cache hit)는 찾는 임베딩이 이미 캐시에 있는 경우이고, 캐시 미스(cache miss)는 아직 없어서 계산해야 하는 경우입니다.
flowchart TD
    A["임베딩이 필요한 텍스트"] --> B["모델명 + 텍스트를 해시해 키 생성"]
    B --> C{"캐시에 키가 있는가"}
    C -->|"히트"| D["저장된 임베딩 반환"]
    C -->|"미스"| E["임베딩 모델 호출"]
    E --> F["키로 캐시에 저장"]
    F --> G["임베딩 반환"]
그림 5.12.2 — 미스에서만 모델을 호출하고, 결과를 저장하므로 같은 텍스트의 두 번째 요청부터는 히트가 됩니다.
return policy를 예로 들면 다음과 같습니다.
- 첫 번째 사용자가 검색하면 캐시에 없으므로 임베딩 모델을 호출하고, 결과를 저장한 뒤 검색에 씁니다.
- 그날 늦게 두 번째 사용자가 같은 검색을 하면 저장본이 있으므로 모델을 건드리지 않고 바로 씁니다.
- 하루에 1,000번 검색되는 인기 쿼리라면 계산은 1번, 재사용은 999번이며 절감률은 99.9%입니다.
수집(ingestion) 단계에서도 같은 구조가 작동합니다. 문서를 청크로 나눠 청크마다 임베딩을 계산하는 작업에서, 문서 한 단락만 고쳐 다시 수집하면 청크 5개 중 편집된 3번만 미스이고 나머지 4개는 히트입니다. 캐시가 없으면 5개를 모두 다시 계산하므로 80%가 낭비입니다. 청킹 방식이 청크 경계를 자주 바꾸면 변경 없는 청크도 미스가 되므로, 청크 경계가 안정적인지가 캐시 히트율을 좌우합니다(5.6 참조).
이 흐름의 결론은 어떤 텍스트든 같은 모델 기준으로 최대 한 번만 계산된다는 점입니다. 고객의 문서가 자주 갱신된다면 재수집 때 임베딩 호출이 문서 전체 크기가 아니라 변경분에 비례하는지 확인합니다.
5.12.3 퇴출 정책: LRU와 TTL
캐시를 무한히 키울 수는 없으므로 공간이 모자라면 오래된 항목을 내보내야 하며, 이를 퇴출(eviction)이라 합니다. 퇴출 기준은 두 가지가 대표적입니다.
LRU(Least Recently Used, 가장 오래 쓰이지 않은 것)는 캐시가 가득 찼을 때 마지막 사용 시점이 가장 오래된 항목을 내보냅니다. 오랫동안 필요하지 않았던 임베딩은 앞으로도 필요하지 않을 가능성이 높다는 가정입니다. 항목 A가 1분 전, B가 2분 전, C가 30분 전에 마지막으로 쓰였다면 C가 퇴출 대상입니다.
TTL(time to live)은 항목이 저장된 뒤 얼마나 오래 머물 수 있는지를 정하는 수명입니다. TTL을 1시간으로 잡으면 저장 후 1시간이 지난 임베딩은 사용 빈도와 상관없이 제거됩니다. 텍스트나 모델이 시간이 지나며 바뀌는 환경에서 오래되어 신선하지 않은(stale) 값이 남지 않게 막는 장치입니다.
| 정책 | 퇴출 기준 | 주로 막는 문제 |
|---|---|---|
| LRU | 마지막 사용이 가장 오래된 항목 | 공간 부족 |
| TTL | 저장 후 정해진 시간 경과 | 낡은 값이 영원히 남는 문제 |
두 정책은 함께 쓸 수 있습니다. LRU로 자주 쓰는 항목을 붙들고, TTL로 모든 항목이 언젠가는 만료되게 만드는 구성입니다. 선택 기준은 사용 사례이며, 고객의 모델 교체 주기와 문서 변경 빈도를 들으면 TTL 길이를 정할 근거가 나옵니다.
5.12.4 메모리 vs 디스크 저장
캐시를 어디에 두느냐에 따라 속도, 용량, 지속성이 달라집니다.
인메모리는 컴퓨터의 작업 공간인 메모리에 두는 방식이며, Redis가 대표 도구입니다. 조회가 빨라 1초의 극히 일부로 끝나므로 실시간 서비스에서 반복되는 쿼리에 적합합니다. 디스크는 하드 드라이브의 파일에 두는 방식으로, 느리지만 훨씬 많은 데이터를 담고 프로그램이 재시작해도 남습니다. 수백만 개 청크의 임베딩을 오래 보관해야 하는 수집 작업에 맞습니다.
| 축 | 인메모리(Redis 등) | 디스크 |
|---|---|---|
| 조회 속도 | 빠름 | 느림 |
| 용량 | 제한적 | 큼 |
| 재시작 후 | 사라짐 | 유지됨 |
| 적합한 용도 | 실시간 쿼리 | 대규모 수집 작업 |
실제 시스템은 둘을 겹쳐 쓰는 경우가 많습니다. 앞단에 빠른 인메모리 캐시를 두고 뒤에 큰 디스크 캐시를 두는 구성입니다. 고객 시스템에서는 쿼리 지연 목표와 재시작 빈도, 보관할 벡터 규모를 보고 두 계층 중 무엇이 필요한지 판단합니다.
5.12.5 이점
임베딩 캐시의 이점은 비용과 지연 두 가지입니다.
- 비용 절감: 임베딩 비용은 어떤 텍스트든 처음 한 번만 내고, 반복은 캐시에서 공짜로 받습니다. 인기 쿼리와 거의 변하지 않는 문서의 재수집에서 절감 폭이 큽니다.
- 지연 감소: 캐시 조회는 임베딩 모델 호출보다 훨씬 빠릅니다. 모델이 원격 서버에 있으면 네트워크 대기도 건너뜁니다.
결과 품질은 변하지 않습니다. 캐시에 있는 임베딩은 다시 계산했을 때 나올 숫자와 같습니다. 낮아지는 것은 비용과 지연뿐입니다.
활용처는 두 곳입니다. RAG에서는 수집 때 모든 청크의 임베딩을, 쿼리 때 사용자 질문의 임베딩을 계산하는데 캐시가 두 지점을 모두 줄입니다(5.14 참조). 시맨틱 검색에서도 같은 문서와 같은 인기 쿼리가 반복되므로 효과가 같습니다(5.3, 5.2 참조). 반면 비슷한 의미의 다른 문장은 이 캐시로 히트하지 않습니다. 임베딩 캐시는 임베딩 모델 호출을 건너뛰는 장치이고, 시맨틱 캐시는 이전 답변을 재사용해 답을 쓰는 LLM 호출을 건너뛰는 장치이므로 서로 다른 일을 아낍니다(5.13 참조).
고객이 "임베딩 비용이 너무 높다"고 말하면 먼저 같은 텍스트가 얼마나 반복해서 임베딩되는지, 곧 캐시 히트율을 측정합니다. 히트율이 낮은데 비용이 높다면 키 설계나 청크 경계가 불안정한지부터 의심합니다.
5.13 시맨틱 캐싱(Semantic Caching)
원문: How does Semantic Caching work?
LLM 호출은 비싸고 느리며, 사용자는 같은 질문을 서로 다른 말로 반복합니다. 단어가 아니라 의미로 질문을 맞춰 보는 캐시가 있으면 이미 만든 답을 다시 쓸 수 있습니다. 이 절은 2026년 7월 글 기준의 시맨틱 캐싱 동작 방식을 설명합니다.
5.13.1 전통 캐시가 AI 앱에서 실패하는 이유
캐시(cache)는 과거 질문의 답을 저장해 두었다가 같은 질문이 오면 즉시 돌려주는 과거 답변의 기억입니다. 친구가 "프랑스의 수도는?"이라고 물어 "파리"라고 답했다면, 같은 질문이 다시 와도 다시 생각하지 않고 기억에서 꺼내 답하는 것과 같습니다. 소프트웨어에서도 처음에는 어렵게 계산하고 저장하며, 다음부터는 저장본을 반환합니다.
AI 앱에서는 질문이 올 때마다 LLM에 보내고, 이 호출에는 비용과 대기 시간이 듭니다. 1,000명이 같은 것을 물으면 1,000번 값을 내고 사용자마다 기다립니다. 그래서 질문과 답을 저장하는 정확 일치 캐시(exact-match caching)를 떠올리지만, 이 방식은 질문을 글자 하나하나까지 맞춰 봅니다.
- 사용자 1: "What is the capital of France?"
- 사용자 2: "Tell me the capital city of France."
사람에게는 같은 질문이고 답은 둘 다 "Paris"입니다. 그러나 정확 일치 캐시에서는 단어와 순서가 다르므로 별개의 질문입니다. 두 번째 질문은 다시 모델로 가서 값을 한 번 더 냅니다. 정확 일치 캐시는 글자만 이해하고 의미는 이해하지 못하며, 사람들은 같은 것을 여러 방식으로 묻기 때문에 히트가 거의 일어나지 않습니다.
이 한계를 푸는 것이 시맨틱 캐싱입니다. 프롬프트 캐싱은 반복되는 프롬프트 접두부에 대한 모델 내부 계산을 재사용하는 정확 접두 일치 방식이어서 모델 호출 자체는 일어납니다(4.6 참조). 시맨틱 캐싱은 의미가 같은 질문의 최종 답을 재사용해 모델을 아예 호출하지 않으며, 둘 다 LLM 호출 비용을 줄이는 수단입니다.
고객이 "챗봇 비용이 높다"고 하면 질문 로그에서 표현만 다르고 뜻이 같은 질문이 얼마나 되는지부터 확인합니다. 그 비중이 크면 시맨틱 캐싱의 후보가 됩니다.
5.13.2 단계별 동작과 수치 예제
시맨틱 캐싱(Semantic Caching)은 질문을 정확한 단어가 아니라 의미로 맞춰 보는 캐시입니다. 새 질문이 이전 질문과 같은 뜻이면, 단어가 달라도 저장된 답을 돌려줍니다. 컴퓨터는 숫자만 이해하므로 의미 비교에는 임베딩과 유사도가 쓰입니다.
- 임베딩: 문장의 의미를 나타내는 숫자 목록입니다(2.6 참조). 의미 지도 위에서 문장 하나가 점 하나이고, 임베딩은 그 점의 주소입니다. 비슷한 뜻은 가까이, 다른 뜻은 멀리 놓입니다.
- 유사도: 두 임베딩이 의미상 얼마나 가까운지를 나타내는 점수이며, 대표적으로 코사인 유사도를 씁니다(2.7 참조). 여기서는 0에서 1 사이로 보며, 1에 가까울수록 같은 뜻이고 0에 가까울수록 다른 뜻입니다.
원문은 이해를 위해 2차원으로 줄인 값을 보여 줍니다. 실제 임베딩은 수백 차원입니다.
| 문장 | 가상의 2차원 임베딩 |
|---|---|
| What is the capital of France? | [0.91, 0.10] |
| Tell me the capital city of France. | [0.89, 0.12] |
| How do I bake a chocolate cake? | [0.05, 0.95] |
첫 두 벡터는 가깝고 세 번째는 멉니다. 이 장난감 값의 코사인 유사도를 python3 -I로 계산하면 첫째와 둘째가 0.9997, 첫째와 셋째가 0.16입니다. 아래 수치 예제의 0.93, 0.40, 0.05는 이 2차원 값에서 나온 것이 아니라 원문이 가정한 점수이므로, 흐름을 이해하는 용도로만 읽습니다.
각 부품의 역할은 다음과 같이 대응됩니다.
| 구성 요소 | 실생활 역할 |
|---|---|
| 임베딩 모델 | 문장을 숫자로 바꾸는 번역가 |
| 임베딩 | 의미 지도 위 문장의 주소 |
| 유사도 점수 | 두 의미가 얼마나 가까운지 판정하는 심판 |
| 임계값 | "충분히 가깝다/아니다"를 가르는 규칙 |
| 캐시 | 과거 질문과 답을 적어 둔 공책 |
전체 흐름은 여섯 단계입니다.
flowchart TD
    A["사용자 질문"] --> B["임베딩 모델로 질문을 벡터로 변환"]
    B --> C["캐시에 저장된 임베딩과 비교, 최고 점수 탐색"]
    C --> D{"최고 점수 가 임계값 이상인가"}
    D -->|"예: 캐시 히트"| E["저장된 답 반환 (모델 호출 없음)"]
    D -->|"아니오: 캐시 미스"| F["모델에 질문해 새 답 생성"]
    F --> G["새 질문 + 임베딩 + 답을 캐시에 저장"]
    G --> H["답 반환"]
그림 5.13.2 — 점수가 임계값을 넘으면 히트로 저장된 답을 돌려주고, 넘지 못하면 모델을 호출하고 결과를 저장합니다.
- 사용자가 질문을 보냅니다.
- 임베딩 모델로 질문을 숫자 목록으로 바꿉니다.
- 캐시에 저장된 모든 질문의 임베딩과 비교해 유사도 점수를 구합니다.
- 점수가 가장 높은 저장 질문을 고릅니다.
- 최고 점수가 정한 한계 이상이면 캐시 히트이며, 모델을 부르지 않고 저장된 답을 바로 돌려줍니다.
- 어떤 저장 질문도 한계를 넘지 못하면 캐시 미스이며, 모델에서 새 답을 받고 새 질문, 임베딩, 답을 캐시에 저장합니다.
실제 시스템에서는 저장된 임베딩이 벡터 DB에 있고, 가장 가까운 항목은 ANN 탐색으로 빠르게 찾습니다(5.1, 5.2 참조). 코드의 요점은 아래 한 덩어리입니다.
def get_answer(question):
    new_embedding = embed(question)                  # 2단계
    best_match, score = search_cache(new_embedding)  # 3~4단계
    if score >= 0.85:                                # 5단계: 히트
        return best_match.answer
    answer = ask_model(question)                     # 6단계: 미스
    store_in_cache(question, new_embedding, answer)
    return answer
캐시에 "What is the capital of France?" → "Paris"가 하나 저장되어 있고 임계값이 0.85라고 가정한 수치 예제는 다음과 같습니다.
| 새 질문 | 유사도 | 0.85와 비교 | 결과 |
|---|---|---|---|
| Tell me the capital city of France. | 0.93 | 0.93 > 0.85 | 히트, "Paris"를 즉시 반환 |
| What is the population of France? | 0.40 | 0.40 < 0.85 | 미스, 모델 호출 후 저장 |
| How do I bake a chocolate cake? | 0.05 | 0.05 < 0.85 | 미스, 모델 호출 후 저장 |
같은 뜻이면 점수가 높아 히트가 되고, 뜻이 다르면 낮아 미스가 됩니다. 두 번째 행처럼 주제(프랑스)가 같아도 묻는 대상이 다르면 점수가 낮아야 하며, 그렇게 만드는 것이 임계값의 일입니다.
임베딩 캐시와 비교하면 차이가 분명합니다. 임베딩 캐시는 같은 텍스트의 임베딩 계산을 건너뛰고(5.12 참조), 시맨틱 캐시는 유사한 질문의 답 생성을 건너뜁니다. 시맨틱 캐시도 질문마다 임베딩을 계산해야 하므로 두 캐시를 겹쳐 쓸 수 있습니다.
5.13.3 유사도 임계값 설정
유사도 임계값(similarity threshold)은 새 질문이 저장된 질문과 충분히 가까운지를 판정하는 한계값이며, 시맨틱 캐싱에서 가장 중요한 숫자 하나입니다.
- 너무 높게(0.99) 잡으면 거의 아무것도 맞지 않습니다. 사실상 복사본만 통과하므로 시맨틱 캐싱의 이점이 사라집니다.
- 너무 낮게(0.50) 잡으면 전혀 다른 질문이 맞기 시작합니다. "프랑스의 수도"가 "독일의 수도"와 맞아 잘못된 도시를 돌려주는 식의 오답이 나옵니다.
- 많은 앱에서 0.85에서 0.95 사이가 쓸 만하지만, 맞는 값은 사용 사례마다 다릅니다. 실제 사용자 질문으로 시험하고 조정해야 합니다.
| 임계값 | 일치 빈도 | 오답 위험 |
|---|---|---|
| 높음 | 적음 | 낮음 |
| 낮음 | 많음 | 높음 |
"프랑스의 수도"와 "독일의 수도"처럼 구조는 같고 개체만 다른 질문은 의미 벡터가 가까워 점수가 높게 나올 수 있어서, 이런 쌍이 임계값을 넘는지 직접 시험하는 것이 안전합니다.
고객 현장에서는 임계값을 숫자 하나로만 승인받지 않고, 실제 질문 로그에서 뽑은 유사 질문 쌍으로 히트와 오답을 눈으로 확인한 뒤 정합니다. 오답의 비용이 큰 도메인이면 임계값을 높게 시작합니다.
5.13.4 장점과 주의점
장점은 네 가지입니다.
- 비싼 모델 호출 횟수가 줄어 비용이 절감됩니다.
- 저장된 답을 돌려주는 것이 모델에 묻는 것보다 훨씬 빨라 응답이 빨라집니다.
- 모델 부하가 줄어 같은 인프라로 더 많은 사용자를 받을 수 있습니다.
- 같은 내용을 다르게 표현해도 의미로 맞추므로 정확 일치 캐시보다 히트하는 범위가 넓습니다.
주의점도 세 가지입니다.
- 답이 쉽게 변하지 않는 질문에 적합합니다. "프랑스의 수도는?"은 답이 그대로이므로 적합하지만, "지금 날씨는?"은 정답이 시간마다 바뀌므로 맞지 않습니다.
- 임계값을 잘 골라야 합니다. 잘못 고르면 이점이 사라지거나 오답이 나옵니다. 낮은 임계값에서는 의미가 비슷해 보이는 다른 질문이 잘못 히트합니다.
- 캐시를 주기적으로 비우거나 갱신해야 합니다. 실제 정답이 바뀌었는데 옛 답이 영원히 남지 않게 합니다.
고객 도입 판단은 이 세 가지로 닫을 수 있습니다. 질문의 정답이 안정적인가, 오답 한 건의 비용이 얼마인가, 캐시 갱신 주기를 누가 소유하는가를 묻습니다. 개인화되었거나 실시간 데이터에 의존하는 질문은 캐시 대상에서 먼저 제외합니다.
5.14 에이전틱 RAG(Agentic RAG)
원문: What is Agentic RAG? How It Works and When to Use It
영상: Agentic RAG Explained
어려운 질문은 검색 한 번으로 풀리지 않습니다. 어떤 검색은 서로 다른 출처가 필요하고, 어떤 검색은 앞선 검색 결과에 따라 달라집니다. 이 절은 2026년 5월 글 기준으로, 검색 단계를 AI 에이전트가 직접 결정하는 에이전틱 RAG를 표준 RAG와 대비해 설명합니다.
5.14.1 표준 RAG의 한계
표준 RAG는 질문을 임베딩하고, 벡터 DB에서 상위 청크를 뽑고, 질문과 함께 LLM에 넘겨 답을 생성합니다(5.1, 5.6 참조). 이 흐름은 일직선이며 중간에 판단이 없습니다. 한 번 검색하고 한 번 생성하고 끝납니다. 프로덕션에서는 검색과 LLM 사이에 리랭커를 넣어 상위 청크를 다시 정렬하기도 하지만(5.5 참조), 그래도 고정된 파이프라인입니다.
원문은 이를 도서관 사서에 비유합니다. 표준 RAG는 책 한 권을 가져다 주는 사서입니다. 질문의 단어와 가장 잘 맞는 책을 골라 건네면 LLM이 읽고 답을 씁니다. 빠르지만 질문에 맞춰 적응하지 못합니다. 질문이 어려워지면 다음 네 가지 문제가 생깁니다.
| 문제 | 예시 | 표준 RAG가 실패하는 이유 |
|---|---|---|
| 멀티홉 질문 | "2023년에 Acme를 인수한 회사의 4분기 매출은?" | 먼저 인수 회사를 찾고 나서 그 회사의 매출을 찾아야 하는데, 긴 질문 전체와 맞는 문서는 없음 |
| 모호한 질문 | "새 정책은 어떻게 되나요?" | 어떤 정책인지 모름. 휴가 정책인지 환불 정책인지 되묻지 않고 엉뚱한 청크를 가져옴 |
| 여러 데이터 소스 | 답이 SQL DB, 웹, 관계 그래프에 있음 | 한 소스만 조회하며 맞는 소스를 고르지 못함 |
| 나쁜 검색 품질 | 상위 청크가 질문과 무관함 | 품질을 점검하지 않고 가져온 것을 그대로 LLM에 넘겨 LLM이 답을 지어냄 |
마지막 문제는 영상이 보탠 설명으로 더 분명해집니다. 벡터 DB는 요청한 만큼의 상위 k개(3개, 5개, 10개)를 항상 돌려줍니다. DB 안에 질문과 가까운 내용이 없어도 상대적으로 가장 가까운 청크를 내놓으므로, 가져왔다는 사실이 관련 있다는 보증이 되지 않습니다.
이 네 가지에서 공통으로 드러나는 것은 표준 RAG의 경직성입니다. 이 한계는 사서를 연구자로 바꾸는 방식으로 풀립니다. 고객 질문 유형을 샘플링해서 멀티홉, 모호, 다중 소스에 해당하는 비율을 세어 보면 표준 RAG로 충분한지 가늠할 수 있습니다.
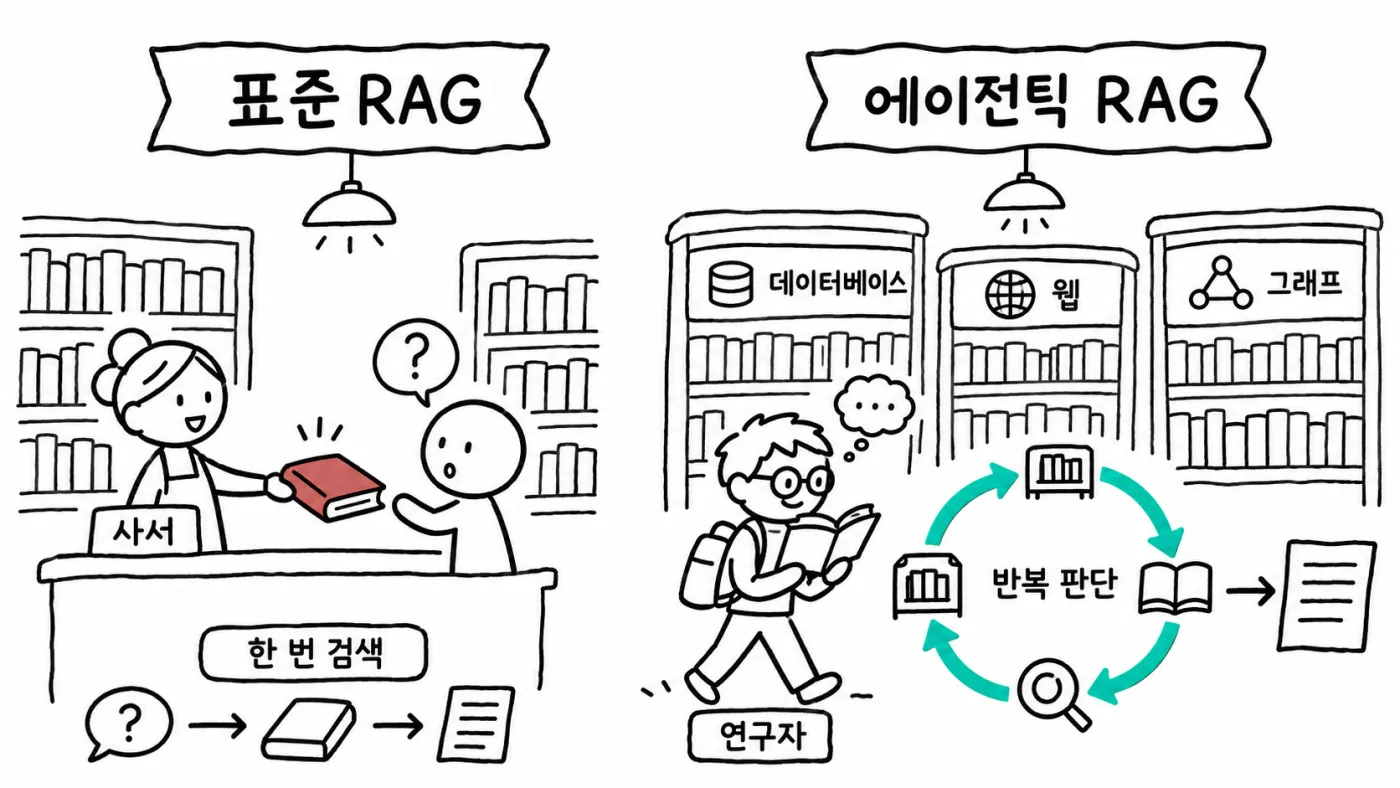
5.14.2 에이전틱 RAG 루프
에이전틱 RAG(Agentic RAG)는 AI 에이전트가 검색 과정을 이끄는 시스템입니다. 고정된 "검색 후 생성" 한 단계가 아니라, 에이전트가 루프 안에서 매 단계를 결정합니다. 비유하면 연구자입니다. 연구자는 질문을 읽고 어디를 볼지 생각하고, 한 섹션을 골라 읽고, 거기에 답이 있는지 판단합니다. 없으면 다른 서가로 가서 후속 검색을 하며 답을 찾을 때까지 계속합니다. 간단히 쓰면 에이전틱 RAG = RAG + 검색 단계를 제어하는 AI 에이전트입니다.
에이전트가 결정하는 일곱 가지는 다음과 같습니다.
- 이 질문에 검색이 필요한가
- 어느 도구 또는 데이터 소스를 쓸 것인가
- 검색어를 어떻게 구성할 것인가
- 가져온 청크가 답하기에 충분한가
- 더 나은 검색어로 다시 검색할 것인가
- 여러 소스의 결과를 합칠 것인가
- 언제 멈추고 최종 답을 쓸 것인가
첫 번째 항목은 인사나 잡담처럼 검색이 필요 없는 입력에는 바로 답하는 판단입니다. 이는 항상 검색하는 고정 파이프라인과 다른 점입니다.
flowchart TD
    Q["사용자 질문"] --> A["AI 에이전트(LLM): 검색 필요? 어느 도구? 어떤 검색어?"]
    A --> T["검색 도구: 벡터 / SQL / 웹 / 그래프"]
    T -->|"청크 반환"| E["AI 에이전트가 평가: 충분한가"]
    E -->|"아니오"| A
    E -->|"예"| G["최종 답 생성"]
그림 5.14.2 — 에이전트가 충분하다고 판단할 때까지 검색-평가를 반복하는 루프입니다.
루프를 무한히 돌릴 수는 없으므로 영상이 강조한 대로 최대 단계 수 같은 한계를 둡니다(5.14.5 참조). 한계가 없으면 에이전트는 실패해도 재시도만 반복합니다. 고객 시스템을 검토할 때는 "이 루프는 어떤 조건에서 멈추는가"를 가장 먼저 묻습니다.
5.14.3 세 가지 구성 요소
에이전틱 RAG는 에이전트, 도구, 루프 세 가지로 구성되며, 원문은 각각 두뇌, 손, 작업 흐름으로 부릅니다.
- 에이전트(두뇌): 사고를 맡은 LLM입니다. 질문을 읽고 다음 단계를 계획하고, 쓸 도구를 추천하고, 결과를 평가합니다.
- 도구(손): 에이전트가 손을 뻗을 수 있는 자원입니다. 연구자가 질문마다 다른 자료를 쓰듯 에이전트도 고릅니다.
- 루프(작업 흐름): 에이전트와 도구를 묶는 런타임입니다. 에이전트를 호출하고, 에이전트가 추천한 도구를 실행하고, 결과를 에이전트에게 돌려주기를 반복합니다.
도구의 종류는 다섯 가지입니다.
| 도구 | 용도 |
|---|---|
| 벡터 검색 | 문서에서 의미 기반으로 텍스트를 찾음(5.2 참조) |
| 키워드 검색 | 정확한 용어 일치 |
| SQL 쿼리 | DB의 정형 데이터 |
| 웹 검색 | 최신 정보 |
| 지식 그래프 쿼리 | 개체 사이의 관계(5.15 참조) |
루프는 지난 모든 단계, 곧 에이전트가 취한 행동과 본 결과를 계속 기록합니다. 이 누적 기록을 스크래치패드(scratchpad) 또는 에이전트 메모리라 부르며, 에이전트는 매 단계마다 이를 읽고 이미 무엇을 시도했고 무엇을 알았는지 확인합니다.
한 가지를 정확히 구분해야 합니다. 에이전트 안의 LLM은 도구를 직접 호출하지 않습니다. LLM은 쓸 도구의 이름과 인자를 텍스트로 출력할 뿐이고, LLM을 둘러싼 런타임이 실제로 도구를 호출해 결과를 돌려줍니다. 이 구분은 권한과 감사 설계에서 의미가 있으며, 도구 호출(6.2 참조)을 허용하거나 막는 통제 지점이 런타임에 있다는 뜻입니다. 고객이 "에이전트가 DB에 쓰기를 하면 어떡하나"를 물으면, 런타임에서 어떤 도구를 어떤 권한으로 노출하는지로 답합니다.
5.14.4 일반적 패턴
에이전틱 RAG는 일반적인 아이디어이며, 그 위에 몇 가지 구체 패턴이 자리 잡았습니다. 셋은 모두 "매 단계를 에이전트가 정한다"는 핵심을 공유하고, 초점만 다릅니다.
| 패턴 | 초점 | 동작 |
|---|---|---|
| ReAct식 RAG(6.4 참조) | 추론 방식 | "생각, 행동, 관찰" 루프. 무엇을 할지 생각하고, 검색 같은 행동을 하고, 결과를 관찰하고 반복함 |
| Self-RAG | 품질 관리 | (원 논문에서는 모델이 반성 토큰을 내도록 학습시키는 방식입니다.) 에이전트가 자신의 검색 결과를 관련성(청크가 질문에 관한 것인가)과 뒷받침(청크가 답을 실제로 지지하는가)으로 채점하고, 부족하면 건너뛰거나 덜 신뢰함 |
| Corrective RAG(CRAG) | 견고성 | 주 검색이 나쁠 때 대체 소스로 전환함. 예를 들어 벡터 검색이 쓸모없으면 실시간 웹 검색으로 넘어감 |
다음은 이 구조를 실제 질문에 적용한 예입니다. 질문은 "2023년에 Acme를 인수한 회사의 4분기 매출은 얼마였나?"입니다.
- 에이전트가 질문을 읽고 멀티홉 질문이므로 먼저 2023년의 Acme 인수 회사를 찾아야 한다고 판단합니다.
- 웹 검색 도구를 추천하며 검색어는
company that acquired Acme in 2023입니다. - 웹 검색이 "Globex가 2023년에 Acme를 인수했다"를 돌려줍니다.
- 에이전트가 계획을 갱신합니다. 이제 Globex의 2023년 4분기 매출이 필요합니다.
- 사내 재무 보고서에 대한 벡터 검색 도구를 추천하며 검색어는
Globex Q4 2023 revenue입니다. - 벡터 검색이 Globex 4분기 재무 보고서의 청크를 돌려줍니다.
- 에이전트가 청크에 매출 수치가 있어 충분하다고 평가합니다.
- 수집한 정보로 최종 답을 생성합니다.
실제 웹 검색은 잡음 섞인 여러 조각을 돌려주고 에이전트가 읽고 추출하므로, 위 3단계의 깔끔한 문장은 이해를 위한 단순화입니다. 한 단계에서 두 소스를 함께 쓰기도 합니다. 정의는 벡터 저장소에서, 최신 뉴스는 웹 검색에서 가져와 합치는 식입니다. 표준 RAG는 원래 질문으로 한 번만 검색해 실패했을 질문을, 에이전틱 RAG는 두 단계로 나누고 서로 다른 도구 두 개를 써서 맞게 답했습니다. 같은 사고방식은 벡터 검색 자체를 대체하는 데에도 쓰이며(5.16 참조), 영상의 설명처럼 요점은 한 번에 답할 수 없는 질문을 여러 단계로 나누는 일을 LLM이 한다는 점입니다.
패턴 선택은 실패 양상으로 정합니다. 가져온 근거가 부실해서 오답이 나온다면 Self-RAG식 채점이, 주 소스가 비어 있는 경우가 잦다면 CRAG식 대체 경로가 먼저입니다.
5.14.5 사용 시점과 한계
표준 RAG와 에이전틱 RAG를 나란히 놓으면 다음과 같습니다.
| 축 | 표준 RAG | 에이전틱 RAG |
|---|---|---|
| 흐름 | 고정 파이프라인 | 동적 루프 |
| 검색 횟수 | 1회 | 필요한 만큼 여러 번 |
| 사용 도구 | 하나(대개 벡터 검색) | 여러 개(벡터, SQL, 웹 등) |
| 쿼리 재작성 | 없음 | 있음(5.9 참조) |
| 검색 청크 품질 점검 | 없음 | 있음 |
| 멀티홉 질문 | 처리 못 함 | 처리 가능 |
| 지연 | 낮음 | 높음 |
| 비용 | 낮음 | 높음 |
| 구축 복잡도 | 단순 | 복잡 |
에이전틱 RAG를 쓰는 경우는 다음과 같습니다.
- 사용자가 한 번의 검색으로 모자란 멀티홉 질문을 합니다.
- 데이터가 벡터 DB, SQL, 웹, 파일 등 여러 소스에 흩어져 있습니다.
- 질문이 모호해서 검색 전에 재작성이 필요합니다.
- 연구, 법률, 의료처럼 지연보다 검색 품질이 더 중요합니다.
- 검색이 필요한지부터 시스템이 판단해야 합니다. 인사나 잡담에는 검색이 필요 없습니다.
표준 RAG를 쓰는 경우는 질문이 단순하고 직접적이며, 데이터가 한 곳에 있고, 깊이보다 지연과 비용이 중요할 때입니다. 연구자는 사서보다 시간이 오래 걸리고 비용도 더 듭니다. 에이전틱 RAG는 항상 더 나은 선택이 아닙니다.
한계는 다섯 가지입니다.
- 지연 증가: 루프의 한 단계가 LLM 호출 하나 이상이어서 사용자가 더 오래 기다립니다.
- 비용 증가: 단계마다 LLM을 호출하고 도구 결과가 다음 프롬프트로 다시 들어가므로, 단계가 많을수록 토큰과 API 요금이 늘어납니다.
- 디버깅 난이도: 에이전트의 결정이 고정되어 있지 않아 같은 질문이 실행마다 다른 경로를 탈 수 있습니다.
- 과도한 루프: 멈춤 규칙이 없으면 재시도를 끝없이 반복합니다. 대표적인 멈춤 규칙은 LLM이 끝났다고 신호하기, 답에 대한 에이전트의 확신이 충분히 높아지기, 최대 단계 수에 도달하기입니다.
- 구성 요소 증가: 도구, 프롬프트, 평가 단계, 멈춤 규칙을 설계해야 하므로 단순한 시스템이 복잡해집니다.
고객 도입을 판단할 때는 질문 유형, 소스 개수, 지연 예산 세 가지를 확인합니다. 단순한 FAQ 검색에 에이전트를 얹으면 비용과 지연만 늘고 이득이 없습니다. 여러 소스를 오가는 멀티홉 질문이 많다면 최대 단계 수와 단계당 토큰 상한을 함께 설계해 비용을 통제합니다.
5.15 GraphRAG
원문: What is GraphRAG? How Knowledge Graphs Improve RAG
회사 지식 베이스에 "우리 CEO는 과거 프로젝트를 통해 최대 고객사와 어떻게 연결되어 있는가"라고 물었을 때, 관련 없는 청크 더미가 아니라 이어진 답이 돌아오게 만드는 방식이 GraphRAG입니다. 이 절은 2026년 5월 글 기준으로 지식 그래프를 벡터 검색과 함께 쓰는 RAG의 구조와 비용을 설명합니다.
5.15.1 일반 RAG의 한계
GraphRAG = Graph + RAG입니다. Graph는 문서 속 중요한 대상을 노드로, 대상 사이의 관계를 연결로 표현한 지식 그래프(knowledge graph)이며, 자기 데이터로 만든 작은 위키백과에 비유할 수 있습니다. 모든 중요한 대상이 한 페이지이고, 두 페이지 사이의 링크가 관계를 말해 줍니다. RAG는 관련 정보를 가져와 질문과 함께 LLM에 넘기는 방식입니다. 따라서 GraphRAG는 답하기 전에 지식 그래프로 더 잘 연결된 정보를 찾는 RAG입니다. 에이전트가 무엇을 언제 가져올지 정하는 에이전틱 RAG(5.14 참조)와 같은 고급 변형 계열에 속합니다.
일반 RAG의 절차는 다섯 단계입니다.
- 문서를 작은 청크로 나눕니다(5.6 참조).
- 각 청크를 임베딩(숫자 벡터)으로 바꿉니다.
- 사용자 질문도 임베딩으로 바꿉니다.
- 질문과 임베딩이 가장 가까운 청크를 찾습니다.
- 그 청크를 문맥으로 LLM에 넘깁니다.
답이 한두 청크 안에 있는 단순한 질문에는 잘 작동합니다. 문제는 질문이 이런 경우입니다. 문서에 많은 사람, 회사, 제품, 사건이 나오고 사용자가 "A 씨는 이력을 통해 X 회사와 어떻게 연결되는가?"라고 묻습니다. 답하려면 다음을 해야 합니다.
- A 씨를 찾습니다.
- A 씨의 이전 회사들을 찾습니다.
- 그중 X 회사와 연결된 회사를 찾습니다.
- 이를 하나의 답으로 합칩니다.
일반 RAG는 질문과 비슷해 보이는 청크를 고를 뿐 사람, 회사, 사건 사이의 연결을 따라가지 않습니다. 정보가 여러 청크에 흩어져 있고 유사도 검색만으로는 이를 이을 수 없습니다. 이런 질문을 멀티홉 질문(multi-hop question)이라 하며, 정보 조각 사이를 한 번 넘는 도약이 필요하다는 뜻입니다. 정보는 거미줄처럼 연결되어 있는데 일반 RAG는 청크를 각자 외딴 섬으로 다룹니다.
고객에게서 "사람과 조직 사이의 관계를 묻는 질문이 많다"는 말이 나오면 이 한계에 해당하는지 의심합니다. 그런 질문 몇 개를 현재 RAG에 넣어 보고 답이 한 청크의 내용에 그치는지 확인하는 것이 가장 빠른 진단입니다.
5.15.2 지식 그래프 구축
GraphRAG는 두 단계로 일합니다.
- 인덱싱 단계: 모든 문서를 한 번 읽어 지식 그래프를 만듭니다. 중요한 대상(엔티티)과 대상 사이의 연결(관계)을 저장합니다.
- 쿼리 단계: 질문이 오면 그래프에서 관련 부분을 찾고, 연결을 따라가며, 알맞은 정보를 모아 LLM에 문맥으로 넘깁니다.
무거운 작업은 인덱싱에서 한 번에 끝내고, 이후 질문은 가벼운 쿼리 단계를 지납니다.
flowchart TD
    subgraph IDX["인덱싱 단계 (한 번 실행)"]
        D["문서"] --> C["청크 분할"]
        C --> X["LLM으로 엔티티 + 관계 추출"]
        X --> K["지식 그래프 구축"]
        K --> M["노드를 커뮤니티로 묶기"]
        M --> S["LLM이 커뮤니티 요약 작성"]
        S --> ST["저장: 그래프 + 임베딩 + 요약"]
    end
    subgraph QRY["쿼리 단계 (질문마다 실행)"]
        Q["사용자 질문"] --> E["시작 엔티티 찾기 (임베딩 유사도 + 질문 속 언급)"]
        E --> W["연결을 따라가며 청크와 요약 수집"]
        W --> L["LLM에 문맥으로 전달"]
        L --> A["최종 답"]
    end
    ST -.-> E
그림 5.15.2 — 인덱싱에서 그래프, 임베딩, 요약을 만들어 두고, 쿼리 단계가 이를 사용합니다.
인덱싱의 핵심은 LLM이 텍스트를 읽고 두 가지를 뽑는 일입니다. 문서에 다음 단락이 있다고 합시다. "Alice는 Acme에서 엔지니어로 일했다. Acme는 2020년에 Globex에 인수되었다. 당시 Bob은 Globex의 CEO였다."
- 엔티티: 문서에 언급된 중요한 대상(사람, 회사, 날짜, 제품)입니다. 여기서는
Alice,Acme,Globex,Bob입니다. - 관계: 엔티티 사이의 연결입니다.
Alice -> works at -> Acme,Globex -> acquired -> Acme,Bob -> CEO of -> Globex입니다.
flowchart LR
    Alice -->|"works at"| Acme
    Globex -->|"acquired"| Acme
    Bob -->|"CEO of"| Globex
그림 5.15.2b — 엔티티가 노드, 관계가 노드를 잇는 엣지가 되어 만들어진 작은 지식 그래프입니다.
일반 RAG였다면 이 단락을 청크로 나눠 임베딩만 저장했을 것입니다. GraphRAG는 모든 청크에 같은 추출을 반복하며, 다른 청크에서 나온 같은 엔티티는 하나의 노드로 합칩니다. 그래서 Globex에 관한 정보가 한곳에 모입니다.
그래프를 만든 뒤에는 서로 촘촘히 연결된 노드를 커뮤니티(community)로 묶습니다. 커뮤니티는 "Acme 인수 이야기"나 "Bob의 경력"처럼 비슷한 주제를 다루는 작은 노드 군집입니다. 각 커뮤니티마다 LLM이 평이한 문장의 커뮤니티 요약을 씁니다. 인덱싱이 끝나면 다음이 갖춰집니다.
- 엔티티와 관계의 그래프
- 엔티티, 관계, 청크, 커뮤니티 요약 각각의 임베딩
- 관련 엔티티 묶음마다의 커뮤니티 요약
주의할 점은 GraphRAG가 임베딩을 버리지 않는다는 것입니다. 임베딩을 그래프와 함께 유지하고, 쿼리 때 임베딩으로 그래프 안의 알맞은 시작점을 찾은 뒤 거기서 연결을 따라갑니다. 재인덱싱 때마다 모든 임베딩을 다시 계산하면 비용이 커지므로, 바뀌지 않은 항목을 건너뛰는 임베딩 캐시가 유효합니다(5.12 참조).
쿼리 단계의 동작은 "Alice와 Bob은 어떻게 연결되어 있는가?"라는 질문으로 볼 수 있습니다.
- 시작점 찾기: 질문을 임베딩해 그래프에서 가장 관련 있는 엔티티를 임베딩 유사도로 찾고, 질문에 직접 언급된 엔티티도 줍습니다. 여기서는
Alice와Bob입니다. - 연결 따라가기:
Alice에서Acme로,Acme에서Globex로,Globex에서Bob으로 갑니다. 경로가 생겼습니다. - 수집: 경로를 따라 관련 노드, 엣지, 원문 청크, 커뮤니티 요약을 모아 원래 질문과 함께 LLM에 문맥으로 넘깁니다.
- 생성: LLM이 이어진 답을 씁니다.
답은 "Alice는 Acme에서 일했고, Acme는 이후 Globex에 인수되었으며 Globex의 CEO가 Bob이었다. 따라서 Alice는 Acme-Globex 인수를 통해 Bob과 연결된다"처럼 나옵니다. 이 답은 원문의 세 문장에서 정보를 가져와 그래프로 엮은 것이며, 전체 사슬을 담은 청크가 하나도 없기 때문에 일반 RAG는 어려워했을 질문입니다.
고객 데이터에 GraphRAG를 제안할 때는 "엔티티와 관계가 무엇인가"를 먼저 정의합니다. 사람, 계약, 제품처럼 고객이 이미 구분해서 부르는 대상이 그래프의 노드가 되며, 추출 결과가 고객의 용어와 맞는지 샘플로 확인합니다.
5.15.3 로컬 검색 vs 글로벌 검색
GraphRAG는 질문 유형에 따라 그래프를 탐색하는 방식이 둘입니다.
로컬 검색(local search)은 질문이 특정 엔티티나 그래프의 작은 영역에 관한 경우에 씁니다. 예를 들어 "Alice의 Acme에서의 역할은?"이면 Alice와 Acme 주변만 보면 됩니다. 작은 부분 그래프와 거기 연결된 텍스트 청크를 모아 LLM에 넘깁니다.
글로벌 검색(global search)은 질문이 데이터셋 전체에 관한 상위 수준의 이해를 요구할 때 씁니다. 예를 들어 "우리 회사 문서 전체의 주요 주제는 무엇인가?"는 어느 부분 그래프 하나로도 답할 수 없습니다. 이때 인덱싱에서 만든 커뮤니티 요약을 쓰며 두 단계로 진행합니다.
- 맵(map) 단계: 각 커뮤니티 요약에 대해 LLM이 병렬로 작은 부분 답과 관련성 점수를 냅니다.
- 리듀스(reduce) 단계: 점수가 가장 높은 부분 답들을 LLM이 하나의 최종 답으로 합칩니다.
이 맵-리듀스 방식 덕분에 커뮤니티가 수천 개여도 컨텍스트 윈도우가 넘치지 않고 확장됩니다.
| 축 | 로컬 검색 | 글로벌 검색 |
|---|---|---|
| 질문 | 특정 엔티티, 좁은 영역 | 전체 데이터셋, 큰 그림 |
| 예 | "Alice의 Acme에서의 역할은?" | "문서 전체의 주요 주제는?" |
| 사용 자료 | 주변 부분 그래프와 연결된 청크 | 커뮤니티 요약 |
| 동작 | 특정 부분을 확대 | 축소해서 커뮤니티마다 묻고(맵) 합침(리듀스) |
같은 그래프 하나로 좁은 질문과 넓은 질문을 모두 처리하는 구조입니다. 고객 질문 로그를 보고 "누가/무엇이 어떻다"류가 많은지, "전체적으로 어떤 흐름이 있는가"류가 많은지에 따라 어느 검색을 우선 검증할지 정합니다. 글로벌 검색은 요약의 수만큼 LLM 호출이 일어나므로 질문당 비용이 높다는 점을 미리 알립니다.
5.15.4 사용 시점과 트레이드오프
GraphRAG가 유리한 경우는 다음과 같습니다.
- 문서에 사람, 제품, 회사, 사건처럼 연결된 엔티티가 많습니다.
- 여러 청크의 정보를 합쳐야 답이 되는 질문이 많습니다.
- 한 가지 사실이 아니라 데이터셋 전체에 관한 상위 수준 질문이 많습니다.
- 연구 논문, 법률 문서, 회사 지식 베이스, 뉴스 아카이브처럼 관계가 풍부한 데이터입니다.
원문의 예는 법무법인입니다. 수천 건의 판례, 판결, 계약이 있고 변호사가 "상위 세 고객이 관련된 지식재산권 사건에서 우리 편에 판결한 판사는 누구인가?"라고 묻습니다. 판사, 사건, 판결, 고객을 여러 문서에 걸쳐 이어야 하므로 일반 RAG로는 풀기 어렵습니다. 반대로 한 청크로 대개 답이 되는 단순한 사용 사례라면 일반 RAG가 더 빠르고 싸며 충분합니다.
지식 그래프를 반드시 LLM이 추출해야 하는 것은 아닙니다. 서로 링크하는 마크다운 파일로 사람이 직접 쓰기도 하며, 그 링크가 파일 폴더를 에이전트가 따라 걸을 수 있는 그래프로 바꿉니다.
트레이드오프는 네 가지입니다.
- 인덱싱 비용: 엔티티, 관계, 커뮤니티 요약을 추출하려면 LLM 호출이 많이 필요하여 시간과 돈이 듭니다.
- 저장 부담: 청크만이 아니라 그래프, 임베딩, 요약을 함께 저장합니다.
- 갱신 비용: 새 문서가 들어오면 임베딩 저장소만이 아니라 그래프와 요약도 갱신해야 합니다.
- 엔지니어링 복잡도: 벡터 저장소와 함께 그래프 DB 또는 그래프 구조를 유지해야 합니다.
| 축 | 일반 RAG | GraphRAG |
|---|---|---|
| 검색 방식 | 청크에 대한 유사도 검색 | 지식 그래프 탐색 + 유사도 검색 |
| 적합한 질문 | 단일 사실 | 멀티홉과 상위 수준 질문 |
| 인덱싱 비용 | 낮음 | 높음(LLM 호출 다수) |
| 저장 | 청크 벡터 저장소 | 그래프 + 벡터 + 커뮤니티 요약 |
| 엔지니어링 부담 | 단순 | 복잡 |
| 연결된 데이터에서의 답 품질 | 제한적 | 크게 향상 |
원문 저자의 의견은, 데이터에 관계가 풍부하고 사용자가 실제로 멀티홉 질문을 할 때만 GraphRAG의 비용이 값어치를 한다는 것입니다. 그 외에는 일반 RAG가 더 나은 출발점입니다. 고객 현장에서는 이 순서로 판단합니다. 먼저 일반 RAG로 시작하고, 로그에서 멀티홉 질문의 실패가 반복해서 확인될 때 GraphRAG를 도입합니다. 이때 인덱싱 비용과 문서 갱신 빈도를 곱해 운영 비용을 먼저 견적합니다.
5.16 벡터리스 RAG(Vectorless RAG)
원문: What is Vectorless RAG? RAG Without Embeddings or a Vector Database
RAG에서 "관련된 부분을 찾는다"는 일이 꼭 벡터로 해야 하는 것은 아닙니다. 문서를 숫자로 바꾸지 않고, 사람이 책을 펼쳐 목차를 보듯 LLM이 문서의 구조를 읽고 어느 부분을 열지 정하는 방식이 있습니다. 이 절은 2026년 9월 글 기준으로 벡터 RAG의 문제와 그 대안인 벡터리스 RAG를 비교합니다.
5.16.1 벡터 RAG의 문제
먼저 RAG의 목적을 짚어 둡니다. LLM은 학습 때 읽은 것만 알고 우리 사무실 문서, 보험 약관, 사내 핸드북, 지난주에 쓴 보고서는 본 적이 없습니다. RAG는 모델에게 새로운 것을 가르치지 않고 알맞은 쪽을 알맞은 때에 건네는 방식이며, 오픈북 시험에서 LLM이 학생이고 문서가 책이며 검색은 맞는 쪽을 찾는 행위입니다. 300쪽짜리 보험 약관에서 "치과 치료가 보장되는가"를 물으면 치과를 다룬 두 쪽만 골라 질문과 함께 보냅니다.
300쪽을 통째로 보내지 않는 이유는 세 가지입니다. 모델이 한 번에 읽을 수 있는 양이 제한적이고, 보내는 단어마다 비용이 들고, 필요한 두 쪽을 300쪽 안에 묻어 두면 모델이 산만해져 답이 나빠지기 때문입니다(2.17 참조). 적게 보내되 그 적은 양이 정확해야 하며, 정확한 쪽을 찾는 방법에서 두 접근이 갈립니다.
벡터 RAG는 다음 두 단계로 동작합니다(5.1, 5.3 참조).
- 문서 준비: 문서를 수백 단어 정도의 청크로 자르고, 각 청크를 임베딩 모델에 통과시켜 벡터를 얻고, 이를 벡터 DB에 저장합니다.
- 질문 답변: 질문도 같은 임베딩 모델로 벡터로 바꾸고, 벡터 DB에서 질문 벡터와 가장 가까운 상위 k개 청크(보통 5개나 10개)를 찾아, 질문과 함께 LLM에 보냅니다.
많은 제품이 이 방식으로 돌아가지만 일곱 가지 문제가 있습니다.
| 번호 | 문제 | 구체 사례 |
|---|---|---|
| 1 | 청킹이 의미를 끊음 | 문장이 반으로 잘리고, 표가 제목과 떨어지고, 규칙이 예외와 갈라짐. 약관의 "치과 치료는 보장된다"와 두 쪽 뒤의 "3장의 모든 치료는 1년 대기 기간 이후에만 적용된다"가 다른 청크에 있어 첫 청크만 뽑히면 자신 있게 틀린 답이 나옴 |
| 2 | 비슷함이 정답은 아님 | "치과 치료를 보장하지 않는 보험은?"에서 "not"은 작은 단어라 숫자를 거의 움직이지 못해, 보장하는 보험의 청크가 반환됨 |
| 3 | 검색 중 사고가 없음 | 거리만 재므로 "규칙과 예외의 질문이니 두 장을 봐야 한다"는 추론을 못 함 |
| 4 | 결과를 설명할 수 없음 | 틀린 청크가 뽑혀도 이유를 물을 수 없고 숫자만 돌아와 디버깅이 어려움 |
| 5 | 유지할 시스템이 많음 | 임베딩 모델, 벡터 DB, 청킹 전략, 문서 변경 시 재임베딩 작업이 필요하고, 더 나은 임베딩 모델로 바꾸려면 처음부터 다시 구축 |
| 6 | 특수한 단어와 숫자에 약함 | 제품 코드, 송장 번호, 의학 용어, 법률 조항 번호, 표는 임베딩에 의미가 거의 안 실림. Clause 14.2.b와 Clause 14.3.b가 거의 같게 보임 |
| 7 | 청크 수가 고정됨 | top-k를 한 번 정하면 모든 질문에 같음. 한 줄이면 되는 질문과 여섯 개 섹션이 필요한 질문이 있는데 고정값은 모자라거나 잡음을 많이 가져옴 |
6번 문제는 5.4의 하이브리드 검색이 키워드 검색을 함께 쓰는 이유와 같은 뿌리입니다(5.4 참조). 1번과 7번은 청킹 전략과 청크 크기 선택의 한계이기도 합니다(5.6 참조).
고객이 약관, 계약서, 매뉴얼처럼 규칙과 예외가 떨어져 있는 문서로 RAG를 만들고 "그럴듯하지만 틀린 답"을 호소한다면, 위 표의 1번과 2번이 원인인지 먼저 확인합니다.
5.16.2 벡터리스 RAG 동작과 예제
벡터리스 RAG는 문서를 벡터로 바꾸지 않고 벡터 DB도 쓰지 않는 검색 방식입니다. 숫자 유사도로 찾는 대신, LLM이 문서의 구조를 보고 어느 부분을 열지 정하는 사람의 방식을 따릅니다. 수학을 읽기로 바꾸고, 문서를 조각내지도 않습니다. 세탁기 설명서 200쪽에서 보증 기간을 찾을 때 우리는 유사도를 재지 않고 맨 앞 목차를 열어 "9장 보증과 서비스"를 찾아 154쪽으로 넘어가 읽습니다. LLM에게 목차를 주고 쪽을 고르게 하는 것이 이 방식의 전부입니다. "벡터리스"는 검색에 임베딩 벡터를 쓰지 않는다는 뜻일 뿐이며, 읽고 답을 쓰는 데는 여전히 LLM을 씁니다.
문서 준비 단계에서는 문서를 같은 크기로 자르는 대신 트리(tree)를 만듭니다. 트리는 목차와 같습니다. 맨 위에 책, 그 아래 장, 그 아래 절, 그 아래 소절이 놓입니다. 트리의 노드마다 세 가지를 저장합니다.
- 해당 섹션의 제목(예: "3.4 Dental Treatment")
- 그 섹션 내용의 한두 줄 요약
- 실제 본문의 위치(예: 41~43쪽)
숫자는 저장하지 않고 아무것도 자르지 않으며 원문은 온전히 남습니다. 트리 구축은 한 번만 하는 작업입니다. 문서에 이미 목차가 있으면 그대로 쓰고, 없으면 LLM이 섹션별로 읽으며 제목과 요약을 쓰게 합니다.
질문 답변 단계는 일곱 단계입니다.
- 사용자가 질문합니다.
- LLM에게 트리의 최상위, 곧 장 이름과 한 줄 요약만 보여 줍니다. 300쪽 문서라도 한 쪽 분량이라 싸고 빠릅니다.
- "이 장 이름과 요약으로 볼 때 답이 있을 만한 장은 어디인가"를 묻습니다. LLM이 하나 이상의 장을 고르고 이유도 말합니다.
- 고른 장만 열어 그 안의 섹션을 보여 주고 다시 고르게 합니다.
- 실제 섹션에 닿을 때까지 한 층씩 내려갑니다. 이 트리 타고 내려가기를 트리 탐색(tree search)이라 합니다.
- 고른 섹션의 실제 전체 본문을 가져옵니다. 섹션째로 가져오므로 중간이 잘리지 않습니다.
- 질문과 전체 본문을 LLM에 보내 최종 답을 쓰게 하며, 사용한 섹션 번호도 함께 냅니다.
flowchart TD
    Q["질문"] --> T1["LLM에 최상위 장 이름 + 한 줄 요약 제시"]
    T1 --> P1["LLM이 후보 장 선택 + 이유"]
    P1 --> T2["선택한 장의 하위 섹션 제시"]
    T2 --> P2["LLM이 섹션 선택 + 이유"]
    P2 -->|"더 내려갈 층이 있으면 반복"| T2
    P2 --> F["선택한 섹션의 전체 본문 가져오기"]
    F --> A["질문 + 본문으로 최종 답과 섹션 번호 생성"]
그림 5.16.2 — LLM이 한 층씩 읽고 고르며 내려가는 트리 탐색입니다.
모든 단계에서 생각하는 모델이 결정하고 이유를 말하므로, 답이 틀리면 기록을 열어 어느 갈림길에서 잘못 들어갔는지 볼 수 있습니다. 숫자 거리를 재는 대신 추론으로 답에 도달하므로 추론 기반 검색(reasoning-based retrieval)이라고도 부릅니다.
원문의 예제는 300쪽 보험 약관과 질문 "첫 해에 치과 치료가 보장되는가?"입니다. 트리는 다음과 같다고 가정합니다.
| 트리 위치 | 내용 |
|---|---|
| 1장 | Definitions |
| 2장 | How to Buy the Policy |
| 3장 What is Covered | 3.1 Hospital Stay, 3.2 Surgery, 3.3 Eye Care, 3.4 Dental Treatment |
| 4장 | What is Not Covered |
| 5장 | Waiting Periods |
| 6장 | How to Claim |
벡터 RAG는 "dental treatment covered first year"처럼 들리는 청크를 찾습니다. "dental"이 3장에 여러 번 나오므로 3.4 Dental Treatment에서 청크 5개가 반환되고, 모두 치과 치료가 보장된다고 말합니다. 5장의 "치과 치료의 대기 기간은 12개월"이라는 문장은 여러 대기 기간을 다룬 긴 청크 안에 묻혀 있어 질문과 충분히 가깝지 않았습니다. LLM은 "예"라는 청크만 보고 "보장된다"고 답하며, 이 답은 틀립니다.
벡터리스 RAG는 다르게 움직입니다. LLM이 여섯 개 장 이름을 보고 이렇게 생각합니다. "질문은 두 가지다. 치과 치료가 보장되는가는 3장에, 첫 해에 보장되는가는 시간에 관한 것이므로 5장에 있다." 3장과 5장을 고르고, 3장 안에서 한 층 내려가 3.4 Dental Treatment를 고릅니다. 3.4의 전문과 5장의 전문을 가져와 LLM에 보내면 두 쪽의 진실이 모두 눈앞에 있어 "치과 치료는 보장되지만 첫 해에는 아니다. 5장에 따라 12개월의 대기 기간이 있다"고 답합니다. 벡터 시스템은 비슷하게 들리는 단어를 찾았고, 벡터리스 시스템은 질문을 이해하고 규칙과 예외를 찾아갔습니다. 벡터 RAG는 수학으로 검색하고 벡터리스 RAG는 읽기로 검색합니다.
고객 평가에서는 이런 규칙-예외 쌍을 시험 질문으로 만들어 두 방식에 같이 넣어 봅니다. 답과 함께 어느 섹션을 열었는지 로그로 확인할 수 있다는 점이 감사와 디버깅에서 설득력이 큽니다.
5.16.3 다른 벡터리스 접근
트리 탐색이 가장 널리 알려져 있지만 유일한 방식은 아닙니다. 네 가지가 더 있고, 모두 벡터를 하나도 만들지 않습니다.
| 접근 | 동작 | 강점 |
|---|---|---|
| 키워드 검색 | 실제 단어를 맞춤. 파일 안에서 찾는 것과 같음 | Invoice INV-2024-8891을 정확히 그 문자열로 찾음. 임베딩은 비슷해 보이는 송장 번호 백 개를 가져올 수 있음 |
| 정형 데이터 필터링 | 날짜, 도시, 금액 같은 열이 있는 DB에서 LLM이 쿼리를 쓰고 실행하고 행을 다시 LLM에 줌 | 숫자와 날짜를 정확히 처리함 |
| 전체 문서 제공 | 문서가 LLM이 한 번에 읽을 양에 들어가면 통째로 질문과 함께 줌 | 검색 단계가 없는 가장 단순한 방식. 계약서 한 건이나 보고서 한 건에 적합함 |
| 모델이 파일을 탐색 | LLM에게 폴더 목록, 파일 열기, 파일 안 검색 같은 도구를 주고 스스로 탐색하게 함 | 개발자가 낯선 코드베이스를 탐색하는 방식. 흔히 에이전틱 검색이라 부름(5.14 참조) |
코딩 에이전트가 코드베이스에서 일하는 방식이 마지막 접근과 같고, 임베딩을 하나도 만들지 않고도 알맞은 파일을 찾습니다.
고객 문서가 계약서 한두 건 규모라면 전체 문서 제공이 가장 단순하므로, 검색 시스템을 만들기 전에 이 선택지부터 따져 봅니다. 코드, 송장 번호, 조항 번호가 핵심이면 키워드 검색을 우선 검토합니다.
5.16.4 벡터 RAG와의 비교, 선택 기준
벡터리스 RAG의 장점은 일곱 가지입니다.
- 청킹이 없습니다. 항상 섹션 전체를 읽으므로 규칙이 예외와 갈라지지 않습니다.
- 벡터 DB와 임베딩 모델이 없습니다. 만들고, 비용을 내고, 유지할 시스템이 하나 줄어듭니다.
- 갱신이 쉽습니다. 문서가 바뀌면 그 섹션의 요약만 고치고 재임베딩할 것이 없습니다.
- 추론이 보입니다. 단계마다 LLM이 특정 장을 연 이유를 말하므로 디버깅이 쉽습니다.
- 특수한 단어가 잘 처리됩니다. 조항 번호, 제품 코드, 의학 용어가 숫자 덩어리로 흐려지지 않고 실제 단어로 읽힙니다.
- 길고 구조적인 문서에서 답이 좋습니다. 보고서, 약관, 매뉴얼, 법률 문서는 이미 구조가 깔끔한데 이 방식은 그 구조를 버리지 않고 활용합니다.
- 검색 중 추론이 가능합니다. 질문이 둘 다 필요로 하면 멀리 떨어진 두 장을 보기로 결정할 수 있습니다.
단점은 다섯 가지입니다.
- 느립니다. 트리를 한 층 내려갈 때마다 LLM 호출이 한 번이어서 몇 번의 호출이 듭니다. 벡터 검색은 밀리초 단위로 끝납니다.
- 질문당 비용이 높습니다. LLM 호출마다 돈이 들지만, 벡터가 저장된 뒤의 벡터 검색은 거의 공짜입니다.
- 구조가 필요합니다. 제목도 섹션도 없는 무작위 상담 채팅 1,000만 건에는 의미 있는 트리를 만들 수 없습니다.
- 품질이 요약에 좌우됩니다. 섹션 요약이 부실하면 LLM이 그 섹션을 건너뛸 수 있습니다. 벡터가 하던 일을 요약이 대신하기 때문입니다.
- 단독으로는 수백만 문서로 확장되지 않습니다. 긴 문서 하나 안에서 찾기는 쉽지만 500만 문서 중에서 고르려면 트리 탐색 전에 값싼 1차 필터가 필요합니다.
두 방식을 나란히 놓으면 다음과 같습니다.
| 축 | 벡터 RAG | 벡터리스 RAG |
|---|---|---|
| 문서 처리 | 벡터로 변환 | 있는 그대로 유지 |
| 임베딩 모델 | 필요 | 불필요 |
| 벡터 DB | 필요 | 불필요 |
| 분할 | 고정 크기 청크 | 문서를 통째로 두고 섹션 단위로 읽음 |
| 검색 방식 | 숫자 사이의 거리 계산 | LLM이 제목과 요약을 읽고 선택 |
| 검색 중 추론 | 없음 | 단계마다 있음 |
| 속도 | 빠름(밀리초) | 느림(LLM 호출 여러 번) |
| 질문당 비용 | 아주 낮음 | 더 높음 |
| 결과 설명 | 왜 뽑혔는지 설명하기 어려움 | LLM이 이유를 말하므로 쉬움 |
| 규모 | 수백만 문서까지 잘 확장 | 길고 구조가 좋은 문서에 적합 |
| 문서 갱신 | 재임베딩 필요 | 요약 갱신만 필요 |
| 정확한 코드, 숫자, 부정어 | 약함 | 잘 처리함 |
선택 기준은 다음과 같습니다. 벡터 RAG는 문서가 아주 많고, 질문이 단순한 조회이고, 속도가 중요하고, 질문당 비용을 아주 낮게 유지해야 할 때 씁니다. 짧은 글 100만 건의 헬프 센터가 좋은 예입니다. 벡터리스 RAG는 이미 구조가 깔끔한 긴 문서를 다루고, 오답의 비용이 크고, 같은 문서의 서로 다른 부분에 걸친 추론이 필요한 질문일 때 씁니다. 보험 약관, 법률 계약, 연간 보고서, 의료 지침, 기술 매뉴얼이 예입니다.
두 방식을 함께 쓰는 시스템도 많습니다. 값싼 벡터 검색이나 키워드 검색으로 500만 문서를 20개로 좁히고, 그 20개 안에서 트리 탐색으로 정확한 섹션을 찾습니다. 한쪽의 속도와 다른 쪽의 정확성을 모두 얻는 하이브리드 접근입니다(5.4 참조).
고객 현장에서는 세 가지를 묻습니다. 문서가 얼마나 많은가, 문서에 목차나 섹션 구조가 있는가, 오답 한 건의 비용이 큰가입니다. 문서가 많고 구조가 없으면 벡터 RAG, 문서가 적고 구조가 좋으며 오답이 비싸면 벡터리스 RAG, 둘 다 해당하면 1차 필터와 트리 탐색의 조합을 제안합니다.
5.17 고객이 내일 묻는다면
각 질문에 소리 내어 답해보고, 막히면 표시된 절로 돌아가십시오. 로드맵이 제시한 통과 기준은 "내일 고객이 물어도 설명하고 결정할 수 있는가"입니다.
- "PostgreSQL을 이미 쓰고 있는데 벡터 DB를 따로 사야 하나요?" 무엇을 먼저 확인합니까? (5.1.1, 5.1.3)
- "문서가 5천 건뿐인데 인덱스 튜닝이 필요한가요?" 어떤 숫자로 판단합니까? (5.1.3, 5.2.6)
- "ANN은 근사라면서요, 정답을 놓치는 것 아닌가요?" 재현율과 속도의 거래를 어떻게 설명합니까? (5.2.1, 5.1.4)
- "벡터 10억 개를 올리면 메모리가 감당이 안 됩니다." 어떤 압축과 인덱스 조합을 제안합니까? (5.1.6, 5.2.4)
- "제품 코드
AX-4412는 검색이 안 되고 문장형 질문만 잘 됩니다." 무슨 일이고 무엇을 붙입니까? (5.3.1, 5.4.1) - "키워드 점수와 의미 점수를 어떻게 합치나요? 점수 단위가 다른데요." 두 방법과 각각의 주의점은 무엇입니까? (5.4.3, 5.4.4)
- "상위 50건을 LLM에 다 넣으면 비싸고 답도 흐려져요." 리랭커를 어디에 두고 무엇을 감수합니까? (5.5.1, 5.5.4)
- "휴가 규정이 두 청크로 갈려서 '24일'만 나오고 '7일 전 신청'이 빠집니다." 청킹을 어떻게 고칩니까? (5.6.1, 5.6.8)
- "청크에 '매출이 3% 늘었다'만 있어서 어느 회사인지 모릅니다." 어떤 기법을 쓰고 비용은 어떻게 줄입니까? (5.7.1, 5.7.5)
- "사용자가 '그건 환불돼?'처럼 짧게 물으면 엉뚱한 문서가 나옵니다." 쿼리 단계에서 무엇을 합니까? (5.9.1, 5.9.2)
- "질문은 짧고 문서는 길어서 임베딩이 안 맞는 것 같아요." HyDE는 무엇을 하고 언제 위험합니까? (5.8.2, 5.8.4)
- "임베딩 API 비용이 크고 같은 질문이 계속 들어옵니다." 임베딩 캐시와 시맨틱 캐싱은 어떻게 다르고 임계값은 어떻게 정합니까? (5.12.1, 5.13.3)
- "인수한 회사의 매출처럼 두 번 찾아야 하는 질문이 자꾸 틀립니다." 에이전틱 RAG와 GraphRAG 중 무엇을 먼저 검토합니까? (5.14.1, 5.15.4)
- "300쪽 약관을 벡터 없이 검색할 수 있다던데요?" 벡터리스 RAG는 어떤 문서에 맞고 무엇을 포기합니까? (5.16.2, 5.16.4)