1. AI·머신러닝 필수 기초
머신러닝은 데이터에서 숫자(가중치)를 찾아내는 일이며, 그 숫자가 믿을 만한지 따지는 일입니다. FDE가 고객의 데이터 팀과 대화하고 "이 모델이 쓸 만한가"를 판단하는 언어가 여기서 나옵니다.
학습 동기: 이 장을 읽으면 고객이 제시한 정확도 숫자를 의심할 수 있고, 데이터가 어떻게 모델이 되는지, LLM이 다음 토큰을 고를 때 내부에서 어떤 계산이 일어나는지 말로 설명할 수 있습니다.
선행 가정: 0장의 여섯 단어를 들어본 정도면 충분합니다. 수학은 중학교 수준의 사칙연산과 그래프 읽기만 사용하며, 미분은 1.13.2에서 처음부터 설명합니다.
1.1 머신러닝이란 무엇인가
머신러닝이 "마법"처럼 들리는 이유는 무엇을 학습하는지가 가려져 있기 때문입니다. 숫자 네 줄짜리 표 하나면 그 정체가 드러납니다.
1.1.1 규칙을 코딩하지 않고 가중치를 학습한다
머신러닝(Machine Learning)은 문제별 규칙을 직접 코딩하는 대신, 범용 알고리즘에 데이터를 주어 패턴을 찾게 하는 방법입니다. 같은 분류 알고리즘이 손글씨 숫자도 구분하고 스팸 메일도 걸러냅니다. 바뀌는 것은 코드가 아니라 학습 데이터입니다.
아래 표에서 y를 만드는 규칙을 찾아봅시다.
| x1 | x2 | y |
|---|---|---|
| 4 | 2 | 8 |
| 1 | 2 | 5 |
| 0 | 5 | 10 |
| 2 | 1 | 4 |
- 규칙은
y = x1 + 2 × x2입니다. 일반형으로 쓰면y = w1 × x1 + w2 × x2이고, 여기서w1 = 1,w2 = 2입니다. w1,w2처럼 입력과 출력을 잇는 상수가 가중치(weight)이고, 이 식 자체가 모델입니다. 입력과 출력의 관계가 직선이므로 선형 모델이라 부릅니다.- 가중치를 알면 표에 없던 입력도 예측할 수 있습니다.
x1 = 3,x2 = 4이면y = 11입니다.
이 표는 손으로 풀 수 있지만 행이 수백만 개, 입력이 수천 개가 되면 사람이 풀 수 없습니다. 그 지점부터 머신러닝이 필요합니다.
1.1.2 학습 반복: Step 1부터 Step 1000까지의 업데이트
학습은 가중치를 임의의 값에서 출발시켜 조금씩 고치는 반복입니다. 예측값을 ŷ, 실제값을 y라 하면 오차는 y − ŷ이며, 이 오차가 줄어드는 쪽으로 가중치를 움직입니다. 위 표를 학습률 0.01로 학습시키면 다음과 같이 움직입니다.
| 시점 | w1 | w2 |
|---|---|---|
| 시작 | 0 | 0 |
| 업데이트 1회 후 | 0.225 | 0.400 |
| 업데이트 2회 후 | 0.402 | 0.719 |
| 업데이트 1000회 후 | 1.000 | 2.000 |
import numpy as np

X = np.array([[4, 2], [1, 2], [0, 5], [2, 1]], dtype=float)
y = np.array([8, 5, 10, 4], dtype=float)
w = np.zeros(2)

for step in range(1000):
    error = y - X @ w                      # 오차
    gradient = -(2 / len(X)) * X.T @ error # 오차를 줄일 방향
    w -= 0.01 * gradient                   # 가중치 수정

print(w) # [1. 2.]- 예측 → 오차 측정 → 가중치 수정 → 반복, 이 네 단계가 학습(training)의 전부입니다.
- 학습률을 너무 크게 잡으면 이 반복은 수렴하지 못합니다(1.13.4 참조).
"기계가 배운다"는 말은 오차가 줄어들 때까지 숫자를 고친다는 뜻입니다. 이 반복은 대규모 LLM 학습에서도 그대로 쓰입니다.
1.1.3 가중치와 경사하강법의 역할
가중치를 어느 방향으로 얼마나 고칠지 알려주는 알고리즘이 경사하강법(Gradient Descent)이며(1.13 참조), 학습이 끝난 가중치가 모델의 지식입니다. 머신러닝 엔지니어의 일은 데이터 이해 → 모델 선택 → 학습 → 평가 → 배포로 이어집니다. 모델 선택은 관계가 단순하면 선형 모델, 경계가 복잡하면 트리 기반 모델, 패턴이 비선형적이고 데이터가 크면 딥러닝 쪽으로 진행합니다.
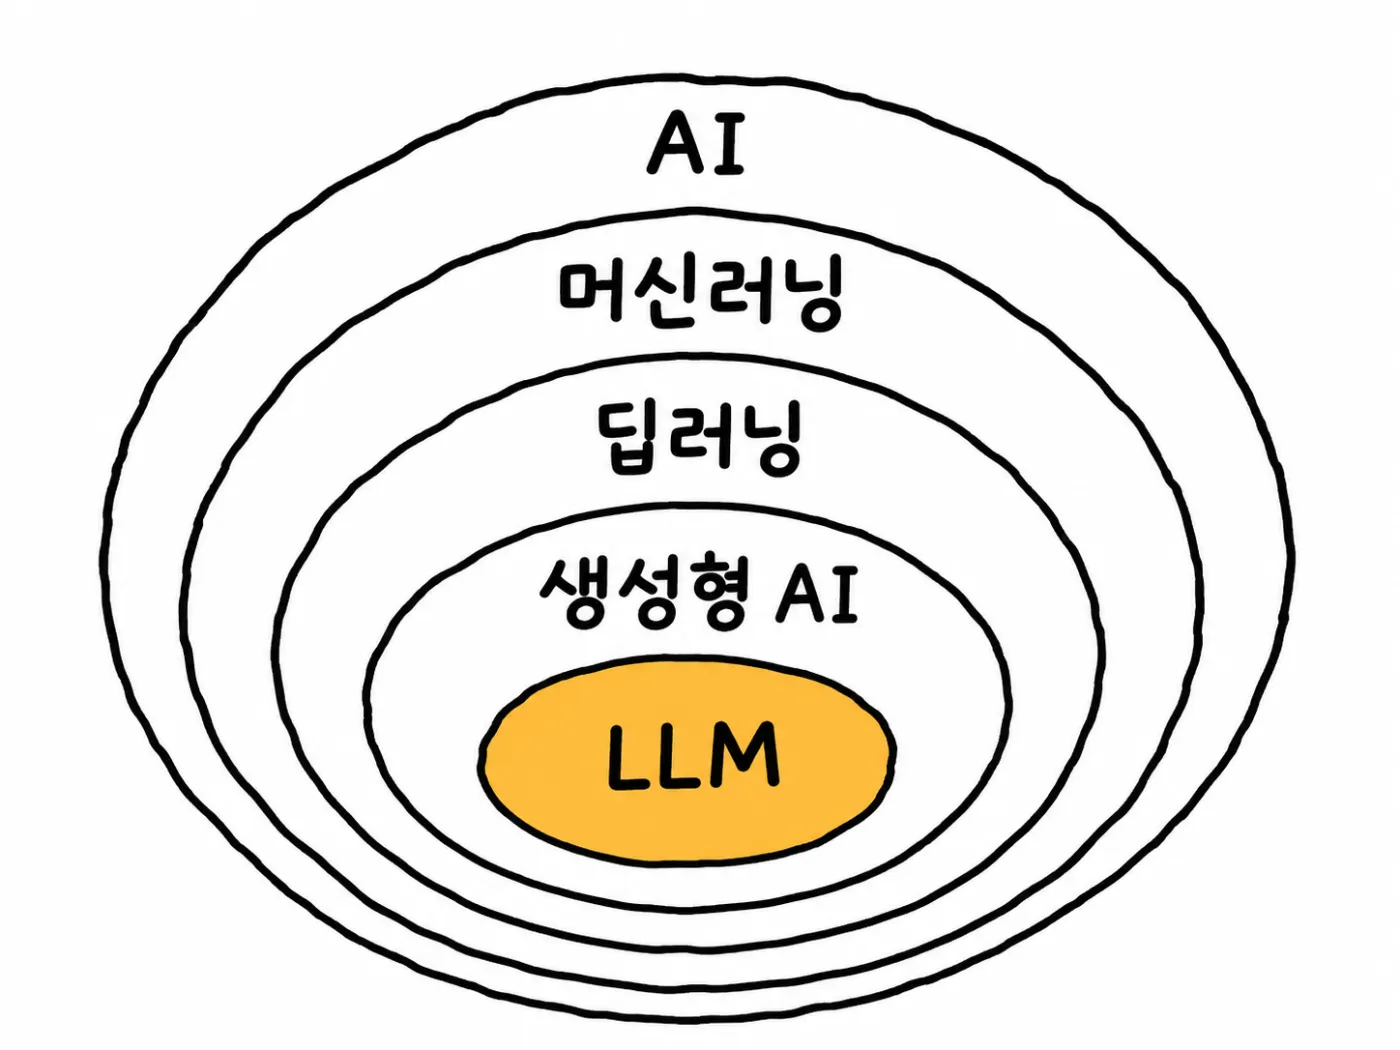
고객이 "AI"와 "LLM"을 섞어 말할 때 이 포함 관계로 대화의 범위부터 맞춥니다. 수요 예측 문제에 LLM이 답이 아닌 경우는 여기서 걸러집니다.
1.2 지도 학습과 비지도 학습
원문: Supervised vs Unsupervised Learning
고객 데이터를 처음 볼 때 가장 먼저 확인할 것은 정답 열이 있는지입니다. 그 답이 사용할 수 있는 학습 방식을 가릅니다.
1.2.1 지도 학습: 입력-정답 라벨 쌍으로 배운다
지도 학습(Supervised Learning)은 입력과 정답(라벨)을 함께 주어 둘 사이의 대응을 배우게 하는 방식입니다. 답안지를 옆에 두고 문제를 푸는 학습과 같습니다. 면적·방 수·입지 점수가 입력이고 집값이 라벨인 데이터가 전형적인 예입니다.
- 분류(Classification): 정해진 범주 중 하나를 고릅니다. 스팸 판정, 이탈 고객 예측이 여기에 속합니다.
- 회귀(Regression): 연속된 숫자를 예측합니다. 집값, 기온 예측이 여기에 속합니다.
- 흐름은 예측 → 라벨과 비교 → 가중치 수정 → 반복이며, 1.1.2의 반복과 같습니다.
약점은 라벨 비용입니다. 라벨이 없거나 사람이 달아야 하면 그 비용이 프로젝트 일정을 좌우합니다.
1.2.2 비지도 학습: 라벨 없이 군집·구조를 찾는다
비지도 학습(Unsupervised Learning)은 입력만 주고 데이터 안의 구조를 찾게 하는 방식입니다. 지도 없이 낯선 도시를 걸으며 번화가와 조용한 동네를 스스로 구분하는 일과 같습니다. 피트니스 앱 사용자의 걸음 수·운동 시간·심박 데이터에 K-Means를 적용하면 "활동적 사용자", "보통 사용자", "저활동 사용자" 같은 묶음이 나옵니다.
- 군집화(Clustering): 비슷한 것끼리 묶습니다. K-Means가 대표적입니다.
- 차원 축소(Dimensionality Reduction): 중요한 정보를 유지하며 데이터를 압축합니다. PCA가 대표적입니다.
- 생성 모델링(Generative Modeling): 데이터의 구조를 배워 새 샘플을 만듭니다.
묶음의 이름은 알고리즘이 주지 않습니다. "활동적 사용자"라는 해석은 결과를 본 사람이 붙이는 것이며, 정답이 없으므로 평가도 그만큼 어렵습니다.
1.2.3 선택 기준: 라벨 유무와 풀려는 문제
선택은 "라벨이 있는가"와 "예측인가 발견인가" 두 질문으로 정해집니다. 지도 학습은 예측하고, 비지도 학습은 발견합니다.
| 기준 | 지도 학습 | 비지도 학습 |
|---|---|---|
| 데이터 | 라벨 있음 | 라벨 없음 |
| 목적 | 출력 예측 | 숨은 구조 발견 |
| 유형 | 분류, 회귀 | 군집화, 차원 축소 |
| 예 | 스팸 판정, 가격 예측 | 고객 세분화, 이상 탐지 |
고객이 "이상 거래를 잡아달라"고 할 때 과거 사기 라벨이 충분하면 분류 문제로, 없으면 이상 탐지 문제로 정의가 달라집니다. 이 정의가 범위와 일정을 결정합니다.
1.3 피처 엔지니어링
원문: What is Feature Engineering in Machine Learning?
영상: Feature Engineering in Machine Learning
피처 엔지니어링(Feature Engineering)은 도메인 지식으로 원본 데이터를 모델이 배우기 좋은 입력(피처)으로 바꾸는 일입니다. 같은 알고리즘이라도 피처가 좋으면 성능이 달라집니다.
- 새 피처 만들기: 항공편 지연을
2018-02-14 20:40같은 일시로 예측하기는 어렵습니다. 지연이 시간대에 달려 있다면Hour_Of_Day = 20으로 뽑아낸 피처가 더 효과적입니다. - 교차 컬럼(crossed column): 위도와 경도는 따로 있으면 집값을 설명하지 못합니다. 둘을 합쳐 위치 피처 하나로 만듭니다.
- 구간화 컬럼(bucketized column): 나이에 따라 결과가 구간별로 달라지면 11~20세, 21~40세, 41~70세처럼 나누어
Age_Range로 만듭니다. - 제거: 예측과 무관한 피처는 성능을 떨어뜨리므로 빼는 것도 피처 엔지니어링입니다.
두 기법은 이어서 쓰이기도 합니다. 집값 데이터에서 위도를 Lat_1(41~45)과 Lat_2(46~50)로, 경도를 Long_1(71~75)과 Long_2(76~80)로 먼저 구간화하면 각 값은 점이 아니라 범위가 됩니다. 이 두 열을 교차해 Lat_Long_Combo를 만들면 Lat_1 × Long_2처럼 범위와 범위가 만나 하나의 구역이 정해집니다. 집값은 위도나 경도 하나보다 구역에 크게 좌우되므로, 구간화 뒤에 교차하는 순서가 모델이 배우기 쉬운 형태를 만듭니다. 나이 구간화도 같은 판단에서 나옵니다. 15세와 18세가 같은 정답을 받는다면 정확한 나이보다 Age_Range = 1(11~20세)이라는 구간 번호가 정답을 더 잘 설명합니다. 피처는 데이터를 관찰해 정답이 무엇에 좌우되는지 찾은 뒤 만들며, 이 관찰이 기법 선택을 정합니다.
절차는 후보 구상 → 생성 → 모델로 확인 → 반복입니다. Hour_Of_Day를 떠올리려면 항공 운항을 알아야 하듯 좋은 피처는 현장 지식에서 나오므로, FDE가 고객과 나란히 앉아 일하는 이유가 여기서도 드러납니다.
1.4 원-핫 인코딩
원문: What is One-hot Encoding in Machine Learning?
영상: One-hot Encoding in Machine Learning
모델은 숫자만 곱하고 더합니다. "빨강"이나 "서울" 같은 범주를 숫자로 바꾸는 방식이 틀리면 모델은 데이터에 없는 사실을 배웁니다.
1.4.1 라벨 인코딩이 만드는 순서 착각
대부분의 머신러닝 알고리즘은 행렬 곱셈과 거리 계산 같은 수학 연산을 하므로 입력이 숫자여야 하고, 문자열 열을 숫자로 바꾸는 일을 인코딩(encoding)이라 합니다. 직원 성과 데이터로 승진 여부를 예측하는 경우, Poor < Fair < Good < Very Good < Excellent처럼 등급 사이에 순서가 있어 1~5 정수로 바꿔도 순서가 유지됩니다. 이렇게 순서가 있는 범주가 순서형(ordinal) 데이터이고, 영화 장르(코미디, 드라마, 액션, 다큐멘터리)처럼 순서나 크기 관계가 없는 범주가 명목형(nominal) 데이터입니다. 명목형에 정수를 매기면 모델이 "드라마가 코미디보다 크다"고 받아들여 예측이 틀어집니다.
라벨 인코딩(label encoding)은 범주마다 번호를 매기는 방식입니다. 빨강=1, 초록=2, 파랑=3으로 두면 모델은 번호를 진짜 수로 받아들입니다.
- 파랑이 빨강보다 크고, 초록은 그 정확히 가운데이며, 빨강 + 초록 = 파랑이 됩니다.
- 색에는 이런 관계가 없으므로 모델이 가짜 순서를 학습합니다.
- 단, 소·중·대처럼 범주에 실제 순서가 있으면 라벨 인코딩이 맞습니다.
고객 데이터의 지역 코드나 상품 코드가 숫자로 저장되어 있을 때 이 함정에 걸리기 쉽습니다. 숫자처럼 보여도 크기가 없는 값이면 범주로 다룹니다.
1.4.2 원-핫 벡터 만들기와 Python 구현
원-핫 인코딩(One-hot Encoding)은 범주마다 길이가 범주 수인 벡터를 만들고 해당 위치만 1, 나머지는 0으로 두는 방식입니다. 빨강 [1,0,0], 초록 [0,1,0], 파랑 [0,0,1]이면 어떤 두 색도 똑같이 다르므로 가짜 순서가 사라집니다.
colors = ["red", "green", "blue"]

def one_hot(color):
    vector = [0] * len(colors)
    vector[colors.index(color)] = 1
    return vector

one_hot("green") # [0, 1, 0]- 절차는 고유 범주 찾기 → 위치 고정 → 0 벡터에 1 표시 → 원래 열을 새 열들로 교체입니다.
- 실무에서는 pandas의
pd.get_dummies나 scikit-learn의OneHotEncoder를 사용합니다. - 좋아하는 장르가 5종이면 열이 5개가 되고, 코미디는 코미디 열만 1이며 나머지 4열은 0입니다. 1이 정확히 하나만 켜져 있어서 "원-핫"이라 부릅니다.
색 한 열이 숫자 세 열로 바뀌는 것이 치르는 비용입니다. 범주가 적을 때는 이 비용이 문제가 되지 않습니다.
1.4.3 분류 정답 라벨과 LLM 토큰의 원-핫 표현
원-핫은 입력만이 아니라 정답에도 쓰입니다. 고양이 사진의 정답은 [1,0,0]이고 모델의 예측이 [0.7,0.2,0.1]이면, 교차 엔트로피 손실(cross-entropy loss)은 정답 위치의 확률만 남겨 −log(0.7) = 0.36이 됩니다. 정답 확률이 0.2로 낮으면 −log(0.2) = 1.61로 손실이 커집니다.
- LLM도 같습니다. 어휘가 4개면 "AI"는
[0,0,1,0]이고, 다음 토큰(2.4 참조) 학습의 정답도 어휘 전체 위의 원-핫입니다. - 실제 어휘는 수만에서 10만 개 이상이므로 이 벡터를 그대로 쓰면 문제가 생깁니다.
손실이 정답 확률 하나로 정해진다는 점이 학습을 단순하게 만듭니다. LLM 학습에서도 이 계산이 그대로 쓰입니다.
1.4.4 원-핫의 한계와 임베딩으로의 대체
어휘가 5만 개면 토큰 하나가 숫자 5만 개가 되고, 그중 49,999개가 0입니다. "고양이"와 "새끼 고양이"의 거리가 "고양이"와 "자동차"의 거리와 같아 의미도 담지 못합니다.
임베딩(embedding)은 이 두 문제를 해결합니다. 토큰을 768개처럼 짧은 숫자 목록으로 표현하고, 그 값을 학습으로 얻어 비슷한 의미가 비슷한 값을 갖게 합니다(2.6 참조). 모든 임베딩을 모은 표가 임베딩 행렬이며, 원-핫 벡터를 곱하면 1이 있는 행이 뽑힙니다. 그래서 LLM은 거대한 벡터를 만들지 않고 토큰 ID로 그 행을 바로 조회합니다.
| 범주 규모 | 권장 표현 | 이유 |
|---|---|---|
| 적음(색, 요일, 상품군) | 원-핫 | 단순하고 가짜 순서가 없음 |
| 많음(도시 수천 개) | 임베딩 | 원-핫은 열이 폭증하고 범주별 데이터가 희박함 |
| 학습 후 새 범주 등장 | 원-핫은 처리 불가 | 새 범주에 해당하는 열이 없음 |
국가 열에 200개 나라가 있으면 열이 200개가 되고 행마다 199개가 0입니다. 이런 고차원 희소 행렬은 메모리와 연산량을 크게 늘립니다.
원-핫의 약점은 폭, 희소성, 유사도 부재, 새 범주 처리 불가입니다. 범주가 많아지면 임베딩으로 넘어갑니다.
1.5 훈련·검증·테스트 데이터 분할
원문: Why do we split data into train, validation, and test sets?
시험 문제를 미리 보고 치른 시험의 100점은 아무것도 증명하지 못합니다. 모델도 같습니다. 본 데이터로 잰 점수는 암기와 이해를 구분하지 못합니다.
1.5.1 훈련 세트·검증 세트·테스트 세트의 역할 분담
학습 데이터를 그대로 외워서 새 데이터에 약해지는 현상이 과대적합(overfitting)입니다. 이를 잡아내기 위해 데이터를 세 조각으로 나눕니다.
| 세트 | 비유 | 용도 | 보는 횟수 |
|---|---|---|---|
| 훈련 세트(training set) | 문제집 | 패턴 학습 | 계속 |
| 검증 세트(validation set) | 모의고사 | 모델 비교, 설정값 튜닝 | 여러 번 |
| 테스트 세트(test set) | 수능 | 정직한 최종 점수 | 끝에 한 번 |
- 모델 크기나 학습 기간처럼 사람이 정하는 값을 하이퍼파라미터(hyperparameter)라 합니다.
- 하이퍼파라미터를 테스트 세트로 고르면 그 시험지에 맞춰 뽑은 셈이라 점수가 부풀려집니다. 검증 세트가 따로 필요한 이유입니다.
작업 순서는 훈련 → 검증 점수 기록 → 설정 변경 후 재학습 → 최선의 설정 선택 → 테스트 세트로 단 한 번 측정입니다. 이 마지막 한 번의 숫자만 고객에게 제시할 수 있습니다.
1.5.2 분할 비율 정하기
검증·테스트 세트는 믿을 만한 점수를 낼 만큼만 있으면 되고 나머지는 훈련에 배정합니다. 그래서 비율은 데이터 양에 따라 달라집니다.
| 데이터 규모 | 훈련 | 검증 | 테스트 |
|---|---|---|---|
| 수천 건 | 70% | 15% | 15% |
| 수만 건 | 80% | 10% | 10% |
| 수백만 건 | 98% | 1% | 1% |
1,000만 건의 1%는 10만 건입니다. 평가에 충분하므로 비율을 관성대로 70/15/15로 잡으면 학습 데이터를 낭비하게 됩니다.
1.5.3 데이터 누수의 전형적 실수
데이터 누수(data leakage)는 검증·테스트 세트의 정보가 학습 과정으로 새어 점수가 실제보다 좋게 나오는 현상입니다. 시험 문제 일부를 미리 본 학생과 같습니다.
- 중복 데이터: 같은 집이 두 번 있으면 한 건은 훈련, 한 건은 테스트로 갈 수 있습니다. 분할 전에 중복을 제거합니다.
- 분할 전 전처리: 전체 평균으로 정규화하면 테스트 정보가 훈련에 스며듭니다. 분할 후 훈련 세트로만 계산합니다.
- 시간 무시: 내일 매출을 예측하는데 무작위로 섞으면 미래로 학습하고 과거로 시험하게 됩니다. 시계열은 1~9월 훈련, 10월 검증, 11~12월 테스트처럼 시간순으로 자릅니다.
- 같은 사람이 양쪽에: 한 환자의 사진이 양쪽에 들어가면 모델이 병이 아니라 환자를 알아봅니다. 한 사람의 데이터는 한 세트에 모읍니다.
- 테스트 세트 반복 확인: 변경할 때마다 테스트 점수를 보면 테스트 세트가 두 번째 검증 세트가 됩니다.
고객이 "정확도 99%"를 들고 오면 이 다섯 가지부터 묻습니다. 현장에서 가장 비싼 실수는 대개 모델이 아니라 평가에 있습니다.
1.5.4 단순 분할이 부족한 경우
데이터가 500건이면 15%를 떼어도 75건뿐이라, 어떤 데이터가 뽑혔는지에 따라 점수가 크게 흔들립니다. 이때 쓰는 두 기법이 있습니다.
- 교차 검증(cross-validation): 테스트 세트를 뺀 데이터를 5등분해 다섯 번 학습하고, 매번 다른 조각을 검증에 쓴 뒤 점수를 평균합니다. 안정적이지만 학습 비용이 다섯 배입니다.
- 층화 분할(stratified split): 스팸이 2%뿐이면 무작위 분할로 테스트 세트에 스팸이 거의 남지 않을 수 있습니다.
train_test_split에stratify=y를 주면 각 세트가 전체와 같은 비율을 유지합니다.
교차 검증을 사용하더라도 최종 확인용 테스트 세트는 따로 둡니다.
1.6 편향-분산 트레이드오프
원문: How does the Bias-Variance Tradeoff work?
모델이 새 데이터에서 틀리는 이유는 크게 둘입니다. 너무 단순하거나, 너무 예민한 경우입니다. 어느 쪽인지에 따라 처방이 정반대입니다.
1.6.1 과녁 비유로 보는 편향과 분산
편향(bias)은 모델의 가정이 지나치게 단순해서 생기는 오차입니다. 곡선 관계를 직선으로만 그리는 모델은 집 100만 채를 주어도 직선입니다. 분산(variance)은 모델이 훈련 데이터에 지나치게 예민해서 생기는 오차입니다. 급매로 싸게 팔린 집 같은 노이즈까지 따라 그리므로, 훈련 데이터가 조금만 바뀌어도 전혀 다른 곡선이 나옵니다.
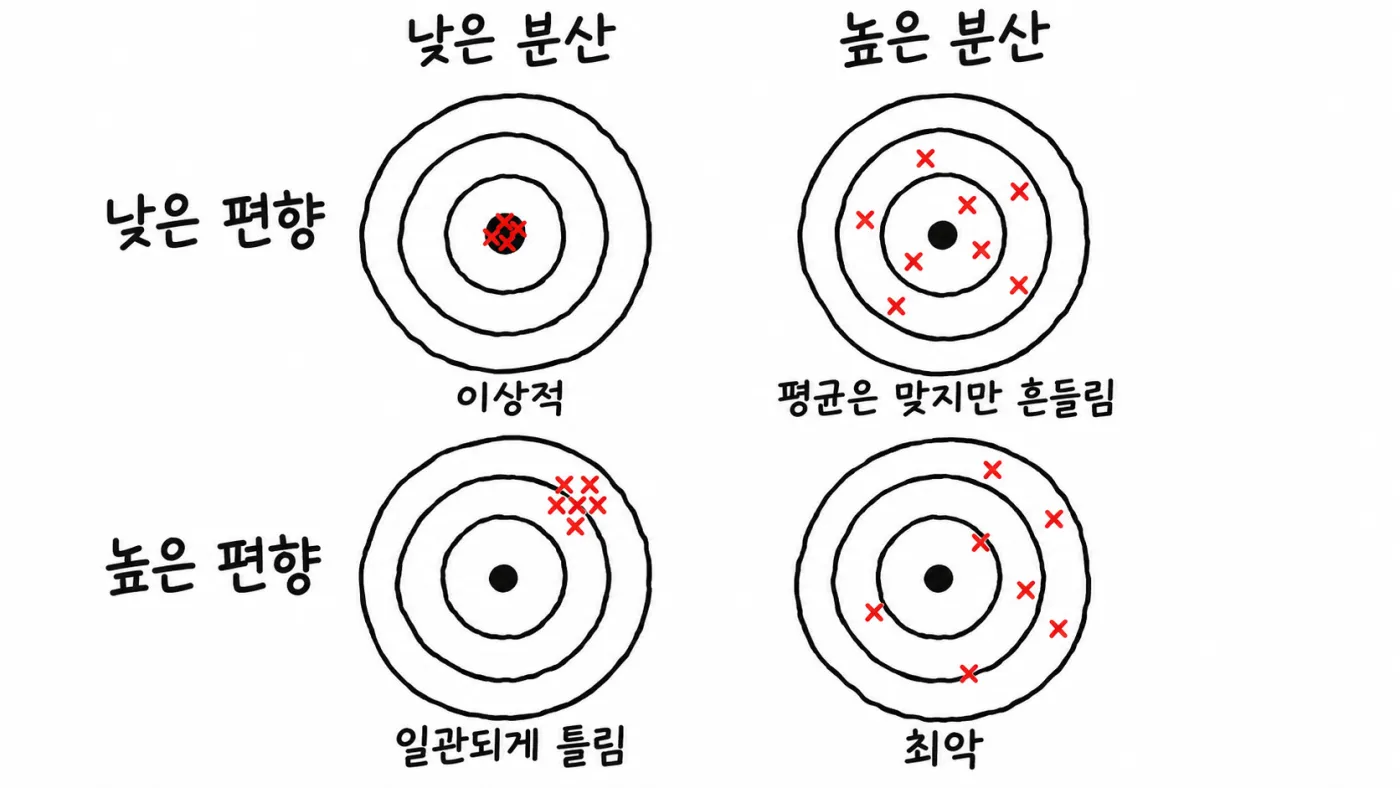
두 값을 따로 읽어야 처방이 갈립니다. 평균이 빗나갔는데 데이터를 더 모아도 소용없고, 흩어지는데 모델을 키우면 더 흩어집니다.
1.6.2 과소적합과 과대적합
과소적합(underfitting)은 고편향의 증상으로 훈련 데이터에서도 새 데이터에서도 성능이 낮습니다. 과대적합은 고분산의 증상으로 훈련 데이터에서만 성능이 좋습니다. 모델의 유연성(복잡도)을 높이면 편향은 줄고 분산은 늘어나므로 공짜로 둘 다 낮출 수는 없습니다. 이것이 트레이드오프이며, 새 데이터 오차가 가장 낮은 중간 지점을 찾는 것이 목표입니다.
사인 곡선에 노이즈를 더한 30개 점에 다항식 차수를 달리해 맞춘 결과(MSE)는 다음과 같습니다.
degree= 1  train=0.217  val=0.181   ← 고편향
degree= 4  train=0.019  val=0.036   ← 균형
degree=12 train=0.013 val=0.098 ← 고분산- 차수 12는 훈련 오차가 가장 낮은데 검증 오차는 차수 4의 2.7배입니다.
- 차수 12의 값은 환경마다 크게 달라집니다. 원문 실행 결과는
train=0.010 val=9.616이고, 이 책의 재현 실행에서는 위 값이 나왔습니다. 1차와 4차는 원문과 일치하며, 12차 다항식 적합의 수치 불안정이 원인으로 추정됩니다.
읽어야 할 것은 절대값이 아니라 패턴입니다. 훈련 오차는 가장 낮은데 검증 오차가 다시 오르면 고분산입니다.
1.6.3 총 오차의 세 구성 요소
오차를 제곱 차이로 잴 때 새 데이터의 총 오차는 세 부분으로 나뉩니다.
총 오차 = 편향² + 분산 + 줄일 수 없는 오차
- 편향²: 모델이 단순해서 생기는 몫입니다.
- 분산: 모델이 예민해서 생기는 몫입니다.
- 줄일 수 없는 오차(irreducible error): 데이터 자체의 노이즈입니다. 판 사람이 급했다는 사실은 면적만 봐서는 알 수 없습니다.
줄일 수 없는 오차가 바닥입니다. 고객 데이터에 노이즈가 많으면 어떤 모델도 그 아래로 내려갈 수 없으므로, 목표 수치를 약속하기 전에 이 바닥부터 가늠합니다.
1.6.4 고편향·고분산 진단법과 처방
진단은 훈련 오차와 검증 오차 두 숫자로 끝납니다. 훈련 오차의 수준이 편향을, 두 오차의 간격이 분산을 말해줍니다.
| 훈련 오차 | 검증 오차 | 진단 | 처방 |
|---|---|---|---|
| 높음 | 높음(비슷) | 고편향 | 복잡한 모델, 유용한 피처 추가, 규제 완화, 더 긴 학습 |
| 낮음 | 훨씬 높음 | 고분산 | 데이터 추가, 단순한 모델, 규제 강화, 앙상블, 드롭아웃, 조기 종료 |
| 낮음 | 낮음(비슷) | 균형 | 유지 |
| 높음 | 훨씬 높음 | 둘 다 | 데이터와 모델을 모두 점검 |
데이터를 더 모으는 처방은 고편향에 효과가 없습니다. 데이터를 얼마나 모아도 직선은 직선입니다. 대규모 신경망에서는 데이터를 외울 만큼 커진 뒤에도 성능이 다시 좋아지는 이중 하강(double descent)이 관찰되지만, 그때도 두 오차를 함께 보는 습관은 그대로 유효합니다.
1.7 에폭·배치·이터레이션
원문: What are Epoch, Batch, Batch Size, and Iteration in Machine Learning?
영상: Epoch, Batch, Batch Size, Iteration
학습 로그와 파인튜닝 설정(11장 참조)에 항상 나오는 네 단어입니다. 학습 한 걸음은 순전파로 예측하고, 손실(loss)로 틀린 정도를 재고, 가중치를 고치는 세 단계이며, 네 단어는 이 걸음에 데이터를 어떻게 나누어 주는지를 가리킵니다.
1.7.1 배치와 배치 크기
데이터 전체를 한 번에 넣으면 GPU 메모리에 올라가지 않고, 전부 본 뒤에야 한 번 고치므로 학습도 느립니다. 그래서 작은 묶음으로 나눕니다. 한 걸음에 함께 처리하는 묶음이 배치(batch), 그 안의 샘플 수가 배치 크기(batch size)입니다.
- 사진 1000장을 배치 크기 100으로 나누면 배치 10개가 나옵니다.
- 배치 하나는 샘플별 손실의 평균인 손실값 하나와 업데이트 한 번을 만듭니다.
배치 덕분에 모델은 첫 묶음부터 개선되기 시작합니다.
1.7.2 이터레이션 수 계산과 나누어떨어지지 않는 경우
이터레이션(iteration)은 배치 하나로 하는 학습 한 걸음이며, 도구에서는 step으로 표시됩니다. 에폭(epoch)은 훈련 데이터 전체를 한 번 도는 것입니다.
- 에폭당 이터레이션 =
ceil(샘플 수 / 배치 크기) - 1000장, 배치 100, 5에폭이면 10 × 5 = 50회 업데이트입니다.
- 1050장이면
ceil(10.5) = 11입니다. 마지막 배치는 50장이고, 3에폭이면 33회입니다. 도구에 따라 마지막 작은 배치를 버리는 옵션이 있습니다.
에폭마다 데이터를 섞는 이유는 모델이 데이터 순서를 학습하지 못하게 하기 위해서입니다.
1.7.3 배치 vs 미니배치 vs 확률적 경사하강법
배치 크기가 경사하강법의 종류를 정합니다.
| 종류 | 배치 크기 | 1000건 기준 에폭당 업데이트 | 특성 |
|---|---|---|---|
| 배치 경사하강법 | 전체 | 1회 | 정확하지만 느리고 메모리를 많이 씀 |
| 미니배치 경사하강법 | 32~128 등 | 10회(100 기준) | 균형이 좋아 사실상 표준 |
| 확률적 경사하강법(SGD) | 1 | 1000회 | 메모리는 적지만 노이즈가 크고 GPU 병렬성을 낭비 |
용어 주의: 현업에서 "SGD"는 대개 미니배치 경사하강법을 뜻합니다. PyTorch의
torch.optim.SGD도 배치 크기 1에 한정되지 않습니다.
이 책에서도 별도 언급이 없으면 학습은 미니배치 방식을 전제합니다.
1.7.4 배치 크기와 에폭 수 정하기
배치가 크면 업데이트가 정확하고 GPU 활용이 좋지만 메모리를 많이 쓰고 업데이트 횟수가 줄어듭니다. 작으면 노이즈가 늘지만, 그 노이즈가 일반화에 도움이 되기도 합니다. 32·64·128에서 시작해 메모리가 허용하는 만큼 올리고, 배치를 키우면 학습률도 함께 조정합니다.
- 한 에폭만 돌면 가중치가 충분히 다듬어지지 않아 정확도가 낮으므로, 같은 데이터를 반복해 보여 줍니다. 실무에서는 30, 40, 많게는 수만 단위의 에폭도 쓰며, 값은 여러 조건에 따라 정합니다.
- 샘플 10개, 배치 크기 2, 에폭 2인 작은 예에서는 에폭당 배치 5개이므로 이터레이션 5회, 전체로는 10회 업데이트이며 모델은 데이터 전체를 두 번 봅니다.
- 에폭이 너무 적으면 과소적합, 너무 많으면 과대적합입니다.
- 조기 종료(early stopping): 에폭을 넉넉히 잡고 검증 손실이 다시 오르기 시작할 때 멈춥니다. 적정 에폭을 미리 맞힐 필요가 없어집니다.
- 작은 모델은 50~100에폭을 돌기도 하지만, 수조 토큰으로 학습하는 대형 LLM은 데이터 대부분을 한 번쯤만 봅니다.
파인튜닝 로그에서 훈련 손실이 내려가는데 검증 손실이 오르면 바로 이 멈출 지점입니다.
1.8 정밀도와 재현율
"잘 동작한다"는 말은 숫자가 아닙니다. 예/아니오 판단의 품질은 서로 다른 두 숫자로 잽니다. 이 절의 예는 스팸 필터 하나로 통일합니다.
1.8.1 혼동 행렬의 네 가지 결과
진실 두 가지와 판단 두 가지를 곱하면 네 칸이 나옵니다. 이 표가 혼동 행렬(confusion matrix)입니다.
| 실제 스팸 | 실제 정상 | |
|---|---|---|
| 스팸으로 표시 | TP(올바른 적발) | FP(오탐) |
| 표시 안 함 | FN(놓침) | TN(올바른 통과) |
오류는 두 종류, 오탐과 놓침뿐입니다. 어느 쪽이 더 비싼지가 이 절의 핵심 질문입니다.
1.8.2 정밀도: 찍은 것 중 맞은 비율
정밀도(Precision) = TP / (TP + FP)입니다. 필터가 10통을 스팸으로 표시했고 그중 8통이 진짜 스팸이면 정밀도는 80%입니다.
- 분모는 "우리가 표시한 것 전부"입니다.
- 높으면 필터가 스팸이라고 할 때 믿을 수 있습니다.
- 낮으면 정상 메일이 스팸함으로 사라집니다.
정밀도는 경보의 신뢰도이며, 놓친 스팸이 얼마나 되는지는 전혀 말해주지 않습니다.
1.8.3 재현율: 정답 중 찾아낸 비율
재현율(Recall) = TP / (TP + FN)입니다. 같은 필터로 실제 스팸 20통 중 8통을 잡고 12통을 놓쳤다면 재현율은 40%입니다.
- 분모는 "실제로 존재하는 정답 전부"입니다.
- 높으면 스팸이 거의 빠져나가지 않습니다.
- 같은 필터가 정밀도 80%에 재현율 40%일 수 있습니다. 숫자 하나로는 품질을 말할 수 없습니다.
두 공식은 분자가 같고 분모만 다릅니다. 정밀도는 FP를 더하고 재현율은 FN을 더합니다.
1.8.4 상황별 선택 기준
필터를 엄격하게 만들면 정밀도가 오르고 재현율이 내려가며, 느슨하게 만들면 반대가 됩니다. 둘을 동시에 최대로 끌어올리기는 어려우므로, 실수의 비용으로 우선순위를 정합니다.
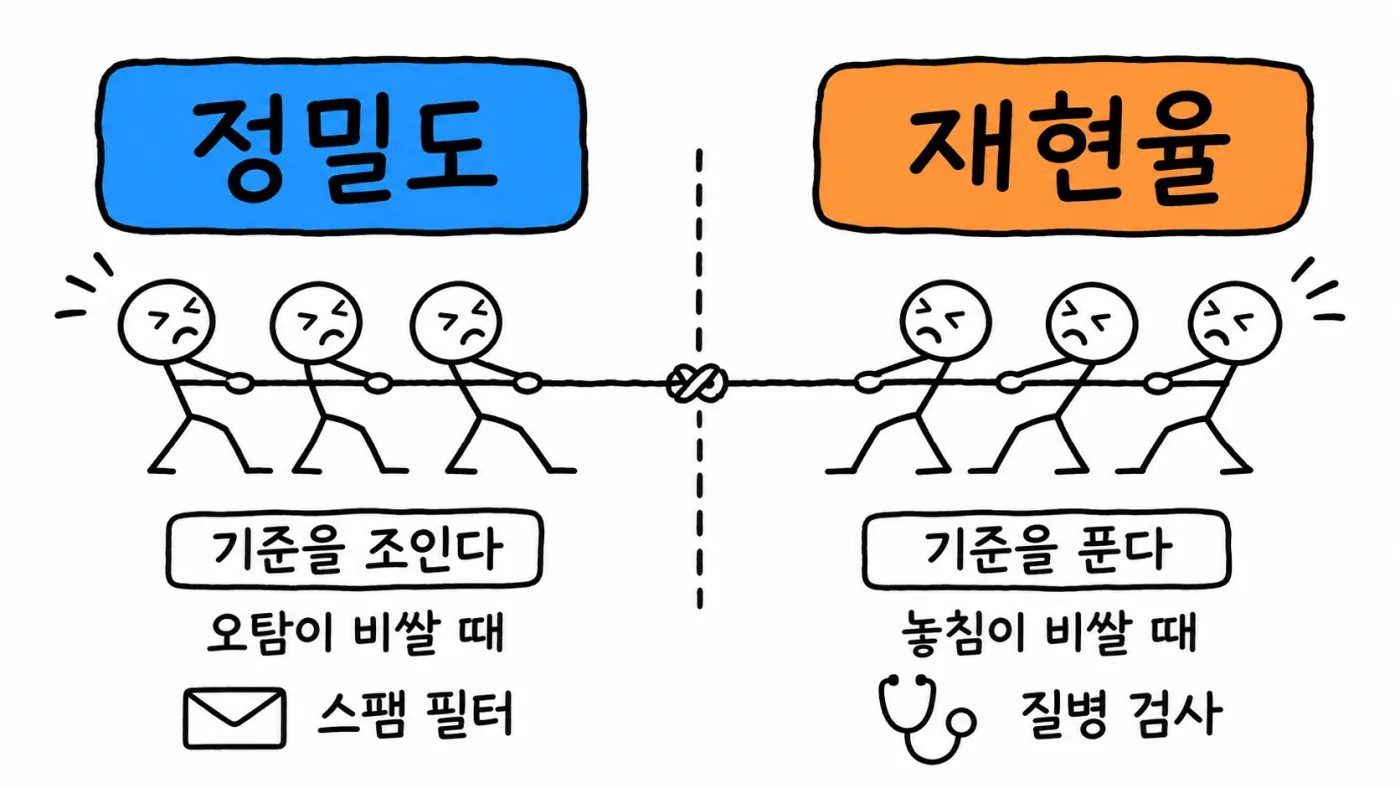
- 오탐이 비싸면 정밀도를 우선합니다. 사장님 메일이 스팸함에 들어가면 안 되는 스팸 필터가 그렇습니다.
- 놓침이 비싸면 재현율을 우선합니다. 환자를 놓치면 생명이 달린 질병 검사가 그렇습니다.
- 균형을 숫자 하나로 볼 때는 둘을 합친 F1 점수를 사용합니다.
RAG 평가의 Context Precision과 Context Recall도 같은 틀입니다(8.1 참조). 고객과 합의할 것은 "정확도 몇 %"가 아니라 어느 쪽 실수를 더 줄일지입니다.
1.9 신경망의 구조와 학습
원문: What is a Neural Network and How Does It Work?
LLM은 거대한 신경망입니다. 입력 2개, 은닉 뉴런 2개, 출력 1개인 작은 망에서 일어나는 계산을 손으로 따라가면 수십억 파라미터 모델의 원리도 같다는 것을 알 수 있습니다.
1.9.1 뉴런·가중치·편향
뉴런(neuron)은 입력마다 가중치를 곱해 더하고, 편향을 더한 뒤, 활성화 함수에 통과시켜 숫자 하나를 내는 최소 단위입니다. 공부 시간과 수면 시간으로 시험 점수를 예측한다고 가정해 봅시다.
- 가중치는 입력의 중요도입니다. 음수면 출력을 끌어내립니다.
- 신경망의 편향(bias)은 입력과 상관없이 더하는 값입니다. 공부를 0시간 해도 몇 점은 받는 상황을 표현합니다.
- 가중합:
z = 0.5×2 + 0.25×3 + 0.25 = 2.0
용어 주의: 신경망의 편향(뉴런에 더하는 상수)과 1.6의 편향(모델이 단순해서 생기는 오차)은 다른 개념입니다. 영어로도 둘 다 bias입니다.
"70억 파라미터 모델"은 이런 가중치와 편향이 70억 개라는 뜻입니다. 이 값들은 사람이 넣지 않고 학습으로 찾습니다.
1.9.2 입력·은닉·출력 층과 활성화 함수
뉴런 하나로는 단순한 패턴만 배우므로 층으로 쌓습니다. 입력층은 값을 담기만 하고, 은닉층이 패턴을 찾으며, 출력층이 예측을 냅니다. 모든 뉴런이 다음 층의 모든 뉴런과 연결된 층이 완전 연결 층이고, 은닉층이 많은 망이 심층 신경망이며 그 학습이 딥러닝(Deep Learning)입니다.
- 곱하고 더하기만 하면 아무리 쌓아도 직선 하나입니다. 활성화 함수(Activation Function)가 꺾임을 넣어 복잡한 패턴을 가능하게 합니다(1.10 참조).
- 기본값은
ReLU(z) = max(0, z)입니다. 양수는 그대로, 음수는 0입니다.
층을 쌓는 것만으로는 표현력이 늘지 않습니다. 층과 활성화 함수가 함께 있어야 깊이가 힘이 됩니다.
1.9.3 순전파 계산 예제
순전파(forward pass)는 입력을 층별로 통과시켜 예측을 얻는 계산입니다. 입력을 x1 = 2, x2 = 3으로 둡니다.
| 뉴런 | 가중치 | 편향 | 가중합 | 출력 |
|---|---|---|---|---|
| h1 | 0.5, 0.25 | 0.25 | 1.0 + 0.75 + 0.25 = 2.0 | ReLU → 2.0 |
| h2 | −1.0, 0.5 | 0 | −2.0 + 1.5 = −0.5 | ReLU → 0 |
| y | 1.5, 2.0 | 0.5 | 3.0 + 0 + 0.5 = 3.5 | 그대로 3.5 |
- h2는 가중합이 음수라 ReLU에서 0이 되어 이번 예측에 기여하지 않습니다.
- 출력 뉴런은 점수 자체가 필요하므로 활성화 함수를 쓰지 않습니다.
곱하고, 더하고, 활성화하고, 넘깁니다. 실제 망은 이 계산을 행렬로 한꺼번에 처리할 뿐입니다.
1.9.4 학습: 손실·경사하강법·역전파
실제 점수가 5인데 3.5를 예측했습니다. 세 도구가 이 실수를 고칩니다.
- 손실:
(5 − 3.5)² = 2.25. 틀린 정도를 숫자 하나로 잽니다. - 경사하강법:
새 가중치 = 옛 가중치 − 학습률 × 기울기. 안개 낀 산에서 발밑 경사만 느끼며 내려가는 일과 같습니다. - 역전파(backpropagation): 출력에서 입력 쪽으로 거슬러 가며 모든 가중치의 기울기를 구합니다. h1에서 출력으로 가는 가중치의 기울기는 −6이므로
1.5 − 0.01×(−6) = 1.56이 됩니다. h2는 0이었으므로 관련 가중치는 이번에는 바뀌지 않습니다.
flowchart LR
  A["순전파<br/>예측 3.5"] --> B["손실 계산<br/>2.25"]
  B --> C["역전파<br/>모든 기울기"]
  C --> D["경사하강법<br/>가중치 수정"]
  D --> A
그림 1.9 — 학습 반복 네 단계입니다. 같은 학생 한 명으로 예측은 3.5 → 4.63 → 4.94 → 4.99로, 손실은 2.25 → 0.13 → 0.003 → 0.00005로 줄어듭니다.
실제 학습에서는 PyTorch 같은 라이브러리가 기울기를 자동으로 계산하며, 학생 한 명이 아니라 수백만 건으로 이 반복을 수행합니다.
1.10 활성화 함수: Sigmoid·Tanh·ReLU·Softmax
원문: What are Activation Functions in Neural Networks?
활성화 함수는 뉴런 계산의 마지막 단계로, 전등 조광기가 밝기를 정하듯 뉴런의 출력 강도를 정합니다. 가중합 z를 받아 뉴런의 최종 출력으로 바꿉니다.
1.10.1 비선형성이 필요한 이유
직선 계산을 쌓아도 직선입니다. y = 2x + 1 위에 out = 3y + 4를 얹으면 out = 6x + 7이고, 100층을 쌓아도 직선 하나로 줄어듭니다. 활성화 함수가 없으면 심층 신경망의 힘은 단일 층과 같습니다.
사진 속 고양이 인식은 직선으로 풀리지 않습니다. 비선형(non-linear) 함수를 층마다 넣어야 층이 쌓일수록 표현력이 늘어납니다.
1.10.2 Sigmoid
Sigmoid는 1 / (1 + e^(−z))로 어떤 수든 0과 1 사이로 누릅니다. z가 −2면 0.119, 0이면 0.5, 2면 0.881이므로 예/아니오 확률로 읽기 좋습니다.
- 치명적 약점은 기울기 소실(vanishing gradient)입니다. Sigmoid의 기울기는 최대 0.25이므로, 역전파가 10개 층을 지나면
0.25^10 ≈ 0.00000095까지 줄어듭니다. 앞쪽 층은 학습을 거의 멈춥니다. - 출력이 항상 양수라 0 중심이 아니어서 학습이 조금 더 느립니다.
그래서 은닉층에서는 거의 쓰이지 않고, 이진 분류의 출력층에 남았습니다.
1.10.3 Tanh
Tanh는 (e^z − e^(−z)) / (e^z + e^(−z))로 −1과 1 사이로 누릅니다. 0 중심이고 z = 0의 기울기가 1로 Sigmoid의 4배입니다.
- 양 끝이 평평한 것은 그대로입니다.
z = 3이면 기울기가 이미 약 0.0099이므로 깊은 망에서는 기울기 소실이 남습니다. - RNN·LSTM 같은 옛 시퀀스 모델과 작은 망의 은닉층, −1~1 값을 내야 하는 출력층에서 쓰입니다.
Sigmoid의 중심 문제는 풀었지만 소실 문제는 풀지 못한 함수입니다.
1.10.4 ReLU
ReLU는 max(0, z)입니다. 양수 구간의 기울기가 항상 1이라 기울기가 줄지 않고, 비교 한 번으로 계산이 끝납니다. 깊은 망의 학습이 수월해진 주요 이유 중 하나입니다. 0을 내는 뉴런이 많아 희소성(sparsity)도 생깁니다.
- 약점은 죽은 ReLU(dying ReLU)입니다. 모든 입력에서
z가 음수가 되면 출력도 기울기도 0이라 가중치가 다시는 변하지 않습니다. - 해법은 Leaky ReLU(
max(0.01z, z))입니다. 음수 구간에 작은 기울기를 남겨 되살아날 길을 열어둡니다. - 현대 LLM은 GELU, SwiGLU처럼 ReLU를 부드럽게 만든 계열을 많이 사용합니다.
은닉층의 기본값은 ReLU 계열입니다.
1.10.5 Softmax
Softmax는 숫자 하나가 아니라 목록 전체를 받아 합이 1인 확률로 바꿉니다. 점수 [2.0, 1.0, 0.1]은 [0.659, 0.242, 0.099]가 됩니다. 계산 과정과 성질은 별도로 다룹니다(1.11 참조).
클래스 하나를 고르는 출력층에서 쓰이고, LLM이 어휘 전체에서 다음 토큰의 확률을 만들 때도 쓰입니다. 값끼리 경쟁하는 구조여서 은닉층에는 쓰지 않습니다.
1.10.6 층별 활성화 함수 선택표
은닉층에서는 기울기가 잘 흐르는지가, 출력층에서는 답의 형태가 기준입니다.
| 함수 | 출력 범위 | 0 중심 | 약점 | 주 사용처 |
|---|---|---|---|---|
| Sigmoid | 0~1 | 아니오 | 기울기 소실 | 출력층: 예/아니오(스팸 판정) |
| Tanh | −1~1 | 예 | 기울기 소실 | 작은 망·RNN 은닉층 |
| ReLU | 0~∞ | 아니오 | 죽은 ReLU | 은닉층 기본값 |
| Softmax | 0~1, 합 1 | 아니오 | 은닉층 부적합 | 출력층: 다중 분류(고양이/개/새) |
집값처럼 임의의 수를 내는 출력층은 활성화 함수를 쓰지 않습니다. 입력층에도 없습니다.
1.11 Softmax 함수
원문: What is the Softmax Function and How Does It Work?
영상: Softmax Activation Function in Machine Learning
LLM의 온도 설정, Transformer의 어텐션 가중치가 모두 이 함수 위에 있습니다. 1.10.5의 Softmax를 계산부터 뜯어봅니다.
1.11.1 합으로 나누기만 하면 안 되는 이유
Softmax는 다중 클래스 분류의 출력층에서 쓰입니다. 입력 하나가 셋 이상의 클래스 중 정확히 하나에 속하는 문제입니다. 예를 들어 28×28 의류 이미지를 784개 입력으로 펼쳐 은닉층(128개 뉴런)을 지나면, 출력층의 10개 뉴런이 티셔츠·바지·코트·가방·앵클부츠 등 10개 클래스의 원점수를 냅니다. 활성화 함수를 적용하기 전의 이 원점수가 로짓(logit, 사전 활성화 값)이고, Softmax를 거친 값이 확률입니다. 가장 큰 확률(예: 0.56)의 클래스가 예측이 됩니다.
확률은 0~1 사이여야 하고 합이 1이어야 합니다. 가장 단순한 방법은 합으로 나누기입니다. 2.0, 1.0, 0.1은 이 방법으로 처리됩니다.
- 점수가
3, 1, −2면 합이 2라서1.5, 0.5, −1.0이 나옵니다. 1을 넘는 확률과 음수 확률은 성립하지 않습니다. - 점수가
2, −2면 합이 0이어서 나눌 수조차 없습니다.
문제의 원인은 음수입니다. 순서를 유지하면서 모든 값을 먼저 양수로 만들어야 합니다.
1.11.2 Softmax 수식과 단계별 계산 예제
softmax(x_i) = exp(x_i) / (exp(x_1) + … + exp(x_n))입니다. exp는 결과가 항상 양수이고 입력이 크면 출력도 커서 순서를 보존합니다.
| 단계 | 고양이 2.0 | 개 1.0 | 새 0.1 |
|---|---|---|---|
1. exp |
7.389 | 2.718 | 1.105 |
| 2. 합계 | 11.212 | ||
| 3. 합계로 나누기 | 0.659 | 0.242 | 0.099 |
앞서 실패한 3, 1, −2도 0.876, 0.118, 0.006으로 정상 처리됩니다. 지수 → 합 → 나누기, 이 세 단계가 Softmax의 전부입니다.
1.11.3 Softmax의 성질과 온도
Softmax의 쓰임은 네 가지 성질에서 나옵니다.
- 출력의 합은 항상 1입니다.
- 순위를 바꾸지 않습니다. 최고점이 최고 확률을 받습니다.
- 격차를 키웁니다. 점수가 1 높으면 확률은 약 2.718배, 5 높으면 약 148배입니다. 최댓값에 100%를 주는 hard max의 부드러운 판이라 이름이 soft입니다.
- 차이만 중요합니다. 모든 점수에 같은 수를 더해도 결과가 같습니다.
온도(temperature) T는 Softmax 전에 점수를 나누는 값으로, 격차를 조절합니다.
| T | 고양이 | 개 | 새 | 효과 |
|---|---|---|---|---|
| 0.5 | 0.86 | 0.12 | 0.02 | 뾰족함, 1위 독주 |
| 1.0 | 0.66 | 0.24 | 0.10 | 원래 분포 |
| 2.0 | 0.50 | 0.30 | 0.19 | 평평함, 고른 기회 |
LLM의 temperature 설정이 바로 이 값입니다(2.11 참조). 낮으면 답이 일관되고, 높으면 다양해집니다.
1.11.4 수치 안정화 트릭: 최댓값 빼기
exp(1000)은 컴퓨터에 담기지 않아 무한대가 되고, 무한대를 무한대로 나누면 nan이 나옵니다. 점수 1002, 1001, 1000.1을 그대로 넣으면 결과는 [nan nan nan]입니다.
"차이만 중요하다"는 성질이 해법입니다. 모든 점수에서 최댓값을 빼면 0, −1, −1.9가 되고 가장 큰 지수값이 exp(0) = 1로 고정됩니다. 결과는 0.66, 0.24, 0.10으로 2.0, 1.0, 0.1의 경우와 같습니다.
def softmax(scores, temperature=1.0):
    scores = scores / temperature
    scores = scores - scores.max()   # 안정화
    exps = np.exp(scores)
    return exps / exps.sum()
PyTorch 등 주요 라이브러리의 Softmax 내부에도 같은 방식이 쓰입니다.
1.11.5 주요 사용처
Softmax는 AI 시스템의 여러 지점에 반복해서 나옵니다. 공통점은 점수가 있고 그 점수를 확률로 바꾸려 한다는 것입니다.
- 분류 모델의 출력: 고양이/개/새, 긍정/부정/중립 중 하나를 고를 때의 마지막 단계입니다.
- LLM의 다음 토큰 예측(2.3 참조): 어휘 전체(10만 개를 넘기도 함)의 점수를 확률로 바꿉니다.
- 강화학습과 추천 시스템: 행동 선호도나 후보 항목의 점수를 확률로 바꿔 고르거나 순위를 정합니다. 온도 조절(1.11.3 참조)도 이 용도에서 함께 쓰입니다.
- Transformer의 어텐션: 토큰 쌍의 점수를 합이 1인 가중치로 바꿔, 각 토큰이 어디에 집중할지 나누어 정합니다(2.9 참조).
같은 함수가 출력 계산과 내부 집중 계산에 모두 쓰이므로, 한 번 익혀두면 2장 전체가 쉬워집니다.
1.12 로짓
원문: What are Logits in Machine Learning?
API 문서와 추론 엔진 설정에서 logit이라는 단어를 만났을 때 막히지 않으려면, Softmax에 들어가기 직전의 값을 알아야 합니다.
1.12.1 로짓이 나오는 위치
로짓(logit)은 모델 마지막 층이 답안별로 내는 정규화 전 원점수입니다. 범위 제한이 없어 음수도 되고 합이 1도 아닙니다. 고양이 2.0은 "2.0만큼 확신"이 아니라 다른 점수와 비교할 수 있는 값일 뿐입니다.
- 답이 3개면 마지막 층의 출력은 3개, 예/아니오면 1개입니다.
- 마지막 층은 활성화 함수 없이 가중치 곱과 편향 합만 수행합니다.
입력 → 은닉층 → 마지막 층 → 로짓 → Softmax → 확률 순서에서, 로짓은 확률 바로 앞에 놓입니다.
1.12.2 로짓에서 Softmax 확률로
다중 선택 모델은 로짓을 Softmax로 바꿉니다. 로짓 2.0, 1.0, 0.1은 0.659, 0.242, 0.099가 됩니다(1.11.2 참조). 같은 수를 더한 12.0, 11.0, 10.1도 결과가 같습니다.
순위는 그대로이므로 1위만 필요하면 Softmax를 돌릴 이유가 없습니다. 로짓의 최댓값을 고르면 끝입니다.
1.12.3 예/아니오 질문의 Sigmoid 로짓
"이 메일이 스팸인가" 같은 이진 질문 모델은 로짓 하나를 내고 Sigmoid로 확률을 만듭니다.
- 로짓 0 → 0.5(판단 보류)
- 로짓 2.0 → 0.881
- 로짓 −1.0 → 0.269
음수 로짓은 "아니오" 쪽으로 기운다는 뜻입니다. 부호만 봐도 판단 방향을 알 수 있습니다.
1.12.4 이름의 유래: log-odds
오즈(odds)는 p / (1 − p)로, 비 올 확률이 0.8이면 오즈는 4(안 올 확률의 4배)입니다. 여기에 자연로그를 씌운 것이 로짓 함수입니다. logit(0.8) = log(4) = 1.386이고, sigmoid(1.386) = 0.8로 되돌아옵니다. Sigmoid와 로짓 함수는 서로의 역함수입니다.
- p = 0.5 → 0, p = 0.9 → 2.197, p = 0.1 → −2.197
- 다중 분류의 로짓은 엄밀히 한 클래스의 log-odds가 아니지만 이름이 함께 쓰이게 되었습니다.
이진 모델의 원점수는 말 그대로 "예"의 log-odds입니다. 이름이 곧 정의입니다.
1.12.5 확률 대신 로짓을 출력하는 이유
마지막에 확률이 필요한데도 모델이 로짓을 내는 이유는 두 가지입니다.
- 수치 안정성: 32비트 수에서는
exp(100)도 표현 범위를 넘습니다. 로짓을 그대로 두어야 최댓값 빼기를 적용할 수 있습니다. - 손실 함수의 입력: 교차 엔트로피는 확률의 로그가 필요한데, 극소 확률이 0으로 반올림되면
log(0)이 음의 무한대가 됩니다. 그래서 로짓에서 바로 안정적으로 계산합니다. PyTorch의nn.CrossEntropyLoss,nn.BCEWithLogitsLoss, TensorFlow의from_logits=True가 이런 이유로 로짓을 받습니다.
흔한 버그는 모델에서 Softmax를 적용한 값을 이런 손실 함수에 다시 넣어 Softmax가 두 번 걸리는 것입니다. 오류 없이 돌아가면서 학습만 나빠지므로 찾기 어렵습니다.
1.12.6 LLM의 로짓
LLM은 매 단계마다 어휘 크기만큼의 로짓을 냅니다. 어휘가 5만 개면 로짓도 5만 개입니다. "The sky is" 다음에 blue 2.0, clear 1.0, dark 0.1, banana −5.0 식입니다. 생성 제어는 Softmax 전에 이 로짓을 조정하는 방식으로 이루어집니다.
- 온도: 모든 로짓을 T로 나눕니다(1.11.3 참조).
- Top-k: 상위 k개만 남기고 나머지를 음의 무한대로 보냅니다. k = 2면
blue,clear만 남아 확률 0.731, 0.269가 되고,banana는 뽑힐 수 없습니다(2.12 참조). - 탐욕적 디코딩(greedy decoding): 무작위 샘플링 없이 항상 최대 로짓을 고릅니다. Softmax가 필요 없습니다.
"왜 같은 프롬프트에 답이 매번 다른가"라는 고객 질문의 답이 여기 있습니다. 로짓까지는 정해지고, 그 뒤 확률 샘플링에서 갈립니다.
1.13 경사하강법의 수학
원문: How Does Gradient Descent Work?
1.9.4에서 쓴 업데이트 식이 왜 그 모양인지 풉니다. 학습률 설정 하나가 파인튜닝의 성패를 가르는 이유도 여기서 나옵니다.
1.13.1 손실 함수
손실 함수(Loss Function)는 예측이 정답에서 얼마나 먼지 숫자로 잽니다. 실제 60, 예측 50이면 제곱 오차는 100입니다.
- 제곱하면 양수와 음수 오차가 서로 지워지지 않습니다.
- 큰 오차가 더 크게 벌점을 받습니다.
- 전체 데이터에 대해 평균 낸 값이 평균 제곱 오차(MSE)입니다.
학습의 목표는 이 숫자를 최소로 만드는 것입니다. 무엇을 손실로 정의하느냐가 곧 모델이 무엇을 잘하게 되느냐를 정합니다.
1.13.2 미분과 업데이트 규칙
미분(derivative)은 한 점에서의 기울기입니다. 위치의 변화율이 속도이듯, 가중치를 조금 바꿀 때 손실이 얼마나 변하는지를 말해줍니다. 양수면 오르막, 음수면 내리막, 0이면 평평한 곳입니다.
w_new = w_old − α × f'(w_old)
α(알파)는 학습률(learning rate)입니다. 빼는 것이 핵심입니다. 기울기가 양수면 왼쪽으로, 음수면 음수를 빼서 오른쪽으로 움직이므로, 최솟값의 어느 쪽에 있든 항상 내리막으로 갑니다. 안개 낀 산에서 발밑 경사만으로 내려가는 방식이라 전체 지형을 알 필요가 없습니다.
1.13.3 수치 예제로 따라가는 다섯 스텝
손실을 f(w) = (w − 3)²로 두면 최솟값은 w = 3이고 미분은 2(w − 3)입니다. w = 0, α = 0.1에서 출발합니다.
| 스텝 | w(이전) | 기울기 | w(이후) |
|---|---|---|---|
| 1 | 0 | −6 | 0.6 |
| 2 | 0.6 | −4.8 | 1.08 |
| 3 | 1.08 | −3.84 | 1.464 |
| 4 | 1.464 | −3.072 | 1.7712 |
| 5 | 1.7712 | −2.4576 | 2.0170 |
최솟값에 가까워질수록 기울기가 작아져 걸음도 작아집니다. 같은 조건으로 50스텝이면 w = 3.0000, 손실은 사실상 0입니다.
1.13.4 다중 파라미터와 학습률
가중치가 많으면 하나씩 따로 미분합니다. TV의 음량과 밝기 조절기를 하나씩 돌려보듯 나머지를 고정하고 한 가중치의 효과를 보는 것이 편미분(partial derivative)이며, 편미분들의 묶음이 기울기(gradient)입니다. 각 가중치는 자기 편미분으로 업데이트되므로 수십억 파라미터로도 그대로 확장됩니다.
같은 함수로 학습률만 바꾸면 결과가 다음과 같이 갈립니다.
| α | 동작 | 결과 |
|---|---|---|
| 0.01 | 20스텝 후 w ≈ 0.997 | 너무 느림 |
| 0.1 | 5스텝 후 w ≈ 2.02 | 안정적 수렴 |
| 1.5 | 0 → 9 → −9 | 발산 |
출발점으로는 0.01이나 0.001을 많이 사용하고, Transformer 같은 대형 모델은 1e-4처럼 더 작은 값을 사용합니다. 파인튜닝(11.1 참조)에서 손실이 튀거나 전혀 줄지 않으면 학습률부터 의심합니다.
1.13.5 배치·확률적·미니배치 경사하강법
실제 손실은 전체 데이터로 계산하므로 한 번 기울기를 구하는 비용이 큽니다. 그래서 기울기를 구할 때 쓰는 데이터 양으로 종류가 나뉩니다(1.7.3 참조). 전체를 쓰면 정확하지만 느리고, 1건이면 빠르지만 노이즈가 크며, 32~1024건 정도의 미니배치가 그 사이의 균형점입니다.
실무의 표준은 미니배치입니다. PyTorch와 TensorFlow는 같은 원리에 역전파로 자동 계산된 기울기를 사용합니다.
1.14 강화학습
원문: What is Reinforcement Learning?
강화학습(Reinforcement Learning, RL)은 정답 없이 시행착오와 보상으로 배우는 방식입니다. 머신러닝의 세 번째 갈래이자, LLM을 사람의 선호에 맞게 조정하는 RLHF의 바탕입니다(11.6 참조).
1.14.1 에이전트·환경·상태·행동·보상
강아지에게 "앉아"를 가르치는 상황으로 구성 요소를 대응시킬 수 있습니다. 앉으면 간식을 주고, 소파에 뛰어오르면 "안 돼"라고 합니다.
| 구성 요소 | 뜻 | 강아지 | 챗봇 |
|---|---|---|---|
| 에이전트(Agent) | 결정하고 배우는 주체 | 강아지 | LLM |
| 환경(Environment) | 에이전트 바깥 전부 | 방과 사람 | 진행 중인 대화 |
| 상태(State) | 어느 순간의 환경 | 간식을 든 손 | 대화 기록 |
| 행동(Action) | 상태에서 하는 선택 | 앉기, 뛰기 | 다음 단어 생성 |
| 보상(Reward) | 환경이 돌려주는 점수 | 간식, "안 돼" | 사람의 평가 |
여기에 상태를 행동으로 잇는 전략 정책(Policy)과, 어떤 상태에서 앞으로 받을 보상의 추정치 가치 함수(Value Function)가 더해집니다. 강화학습의 목표는 좋은 정책을 얻는 것입니다.
용어 주의: 강화학습의 에이전트(학습 주체)는 6장의 AI 에이전트(도구를 호출해 일을 하는 시스템)와 같은 단어를 쓰지만 다른 개념입니다.
1.14.2 강화학습 루프
에이전트와 환경의 상호작용은 한 고리로 돌아갑니다. 상태 관찰 → 정책에 따라 행동 → 환경이 새 상태와 보상 반환 → 정책 수정 → 반복입니다. 이 고리가 수백만 번 돌면서 정책이 나아집니다.
지도 학습에는 라벨이, 비지도 학습에는 입력 데이터가 있다면, 강화학습에는 라벨 없이 상호작용에서 나오는 보상 신호뿐입니다. 데이터를 스스로 만들어가며 배운다는 점이 앞의 두 방식과 다릅니다.
1.14.3 에피소드·리턴·할인율
에피소드(Episode)는 처음부터 끝까지 한 판이고, 리턴(Return)은 한 판의 보상 총합입니다. 할인율(Discount Factor, γ)은 0~1 사이 값으로, 미래 보상을 현재 가치로 얼마나 깎을지 정합니다. 에이전트의 인내심에 해당합니다.
보상이 t=2에 +1, t=4에 +10이고 γ = 0.9이면 리턴은 다음과 같습니다.
0.9² × 1 + 0.9⁴ × 10 = 0.81 + 6.561 = 7.371
끝의 +10은 시작 시점에 6.561의 값입니다. γ가 작으면 눈앞의 보상만 좇고, 크면 나중의 큰 보상을 기다립니다.
1.14.4 탐험 vs 활용
활용(exploitation)은 이미 좋다고 아는 행동을 고르는 것이고, 탐험(exploration)은 더 좋은 것이 있는지 새 행동을 시도하는 것입니다.
- 활용만 하면 처음 찾은 괜찮은 식당에만 가다가 더 좋은 식당을 영영 알지 못합니다.
- 탐험만 하면 좋은 식당을 찾고도 계속 새 식당만 전전합니다.
좋은 에이전트는 둘 사이의 균형을 잡습니다. 이 균형을 어떻게 잡느냐가 알고리즘 설계의 주요 문제입니다.
1.14.5 알고리즘 계열
알고리즘은 많지만 대부분 세 계열이며, 정책을 어떻게 얻느냐로 나뉩니다.
- 가치 기반(value-based): 가치 함수를 배워 가치가 가장 높은 행동을 고릅니다. Q-learning이 대표적입니다.
- 정책 기반(policy-based): 정책을 직접 배웁니다. Policy Gradient가 대표적입니다.
- 액터-크리틱(actor-critic): 정책 담당(Actor)과 가치 담당(Critic)을 함께 학습합니다. LLM 파인튜닝에 널리 쓰이는 PPO(Proximal Policy Optimization)가 이 계열입니다.
세 계열을 외울 필요는 없습니다. 모두 보상 신호로 좋은 정책을 배우는 다른 경로입니다.
1.14.6 강화학습이 어려운 이유
AlphaGo, AlphaZero, 로봇 보행, 추천 시스템, LLM의 RLHF까지 쓰임은 넓지만 실무 적용은 까다롭습니다.
- 희소한 보상: 보상이 끝에만 주어지면 어느 행동 덕분인지 알기 어렵습니다. 이를 신용 할당 문제(credit assignment problem)라 합니다.
- 변하는 데이터: 정책이 바뀌면 방문하는 상태도 바뀌어 학습이 불안정해집니다.
- 비싼 시행착오: 게임은 하루에 수백만 판을 돌리지만 로봇은 수백만 번 넘어질 수 없습니다.
- 보상 설계: 잘못 설계하면 목적은 달성하지 않고 점수만 올리는 보상 해킹(reward hacking)이 일어납니다.
고객이 "강화학습으로 최적화하자"고 하면 시뮬레이터가 있는지, 보상을 숫자로 정의할 수 있는지부터 묻습니다. 둘 중 하나라도 없으면 프로젝트의 첫 과제가 그것입니다.
1.15 고객이 내일 묻는다면
각 질문에 소리 내어 답해보고, 막히면 표시된 절로 돌아가십시오. 로드맵이 제시한 통과 기준은 "내일 고객이 물어도 설명하고 결정할 수 있는가"입니다.
- "저희 모델 정확도가 99%인데 바로 배포해도 될까요?" 무엇을 먼저 확인합니까? (1.5.3, 1.8)
- "데이터가 더 필요한가요, 모델을 키워야 하나요?" 어떤 숫자 두 개로 판단합니까? (1.6.4)
- "문의 내용을 자동으로 분류하고 싶은데 라벨이 없어요." 어떤 선택지가 있습니까? (1.2.3)
- "지점 코드를 1, 2, 3으로 넣었는데 괜찮나요?" 무엇이 문제이고 어떻게 고칩니까? (1.4.1, 1.4.4)
- "사기 거래 탐지에서 오탐과 놓침 중 무엇을 줄여야 하나요?" 무엇으로 정합니까? (1.8.4)
- "다음 달 매출 예측 모델의 테스트 점수가 너무 좋아요." 어떤 누수를 의심합니까? (1.5.3)
- "같은 질문에 왜 LLM 답이 매번 달라지나요?" 로짓과 온도로 설명해 보십시오. (1.11.3, 1.12.6)
- "파인튜닝 중 훈련 손실은 내려가는데 검증 손실이 올라갑니다." 무슨 일이고 무엇을 합니까? (1.7.4, 1.6.4)
- "학습률은 어떻게 잡아야 하나요?" 너무 작을 때와 클 때 무슨 일이 생깁니까? (1.13.4)
- "강화학습으로 재고를 최적화할 수 있나요?" 무엇부터 묻습니까? (1.14.6)