2. LLM은 어떻게 동작하는가
LLM은 문장을 토큰으로 쪼개 숫자로 바꾸고, 어텐션으로 문맥을 섞어 다음 토큰의 확률 분포를 만든 뒤 그중 하나를 뽑는 일을 반복하는 기계입니다. FDE가 고객에게 "왜 틀리는지, 왜 비싼지, 왜 느린지, 무엇을 조절할 수 있는지"를 설명하는 근거가 이 한 사이클에 모두 들어 있습니다.
학습 동기: 이 장을 읽으면 토큰화, 임베딩, 어텐션, 샘플링, 컨텍스트 윈도우가 한 번의 응답 안에서 어떻게 이어지는지 말로 설명할 수 있고, 환각·중간 소실·응답 지연·비용 같은 고객의 불만을 토큰 수준의 원인으로 되짚어 대응책을 고를 수 있습니다.
선행 가정: 1.11의 Softmax와 온도, 1.12의 로짓, 1.4.4의 토큰 ID와 임베딩 개념을 한 번 읽은 상태이면 충분합니다. LLM을 한 줄로 정의한 0.4.1을 이미 읽었다고 가정하며, 이 장은 그 안쪽의 작동을 풉니다.
2.1 생성형 AI(Generative AI)
고객이 "AI를 도입하고 싶다"고 말할 때, 그 AI가 판정하는 AI인지 새 결과물을 만드는 AI인지부터 갈라야 예산과 평가 방식이 정해집니다. 이 절은 생성형 AI의 정의, 학습 원리, 결과물의 범위, 한계를 한 번에 잡습니다. 아래 설명은 2026년 8월에 게시된 글을 기준으로 합니다.
2.1.1 생성(Generative)과 AI의 결합, 기존 AI와의 차이
생성형 AI(Generative AI)는 텍스트, 이미지, 오디오, 영상, 코드처럼 이전에 존재하지 않던 새 결과물을 만드는 인공지능입니다. 이름은 두 부분으로 나뉩니다. Generative는 "새것을 만들어 낸다"는 뜻이고, AI는 언어 이해, 이미지 인식, 의사결정처럼 사람의 지능이 필요한 일을 컴퓨터가 하게 만드는 기술입니다. 둘을 합치면 "스스로 새 내용을 만들어 내는 인공지능"이 됩니다.
여기서 "생성"의 기준은 분명합니다. 계산기에 2 + 2를 넣으면 4가 나오지만, 이것은 고정된 규칙을 따른 결과이며 매번 같고 새롭지도 않으므로 생성이 아닙니다. 반대로 "달에서 자전거를 타는 고양이를 그려 달라"는 요청에는 그런 그림이 이전에 없었으므로, AI가 픽셀 단위로 새 그림을 만들어 내는 것이 생성입니다. 비 오는 날의 짧은 시를 요청했을 때도 마찬가지입니다. 예전 컴퓨터는 누군가 이미 쓴 시를 검색해 보여 줄 수 있었지만, 지금은 아무도 쓴 적 없는 시를 몇 초 만에 씁니다. 핵심은 옛 답을 복사해 붙이지 않고 새 답을 만든다는 점입니다.
기존 AI와의 차이는 출력의 성격에 있습니다. 기존 AI는 입력을 보고 라벨이나 판정을 내는 일을 주로 했습니다. 스팸 메일인가, 사진에 고양이가 있는가, 리뷰가 긍정인가 같은 질문이며, 이미 존재하는 선택지 중에서만 고릅니다. 이를 "판정하는 AI"라 부르고, 생성형 AI를 "만드는 AI"라 부를 수 있습니다.
| 구분 | 기존 AI (판정하는 AI) | 생성형 AI (만드는 AI) |
|---|---|---|
| 입력에 대한 동작 | 입력을 보고 라벨을 고름 | 입력을 보고 새 콘텐츠를 만듦 |
| 질문 예 | "이 동물은 고양이인가 개인가" | "새 고양이를 그려 줘" |
| 선택 범위 | 고정된 선택지 중 하나 | 이전에 없던 것을 생성 |
| 출력 | 판정 | 새 텍스트, 이미지, 오디오, 영상 |
flowchart LR
  subgraph A[기존 AI]
    A1[동물 사진] --> A2[AI] --> A3["고양이입니다 (라벨)"]
  end
  subgraph B[생성형 AI]
    B1["텍스트: 달 위의 고양이"] --> B2[AI] --> B3[새로 그린 고양이 그림]
  end
그림 2.1.1 — 기존 AI는 라벨을 붙이고, 생성형 AI는 새 결과물을 만듭니다.
둘 모두 머신러닝 위에 세워져 있습니다(1.1 참조). 다만 한 가지 주의할 점이 있습니다. 두 유형은 배타적이지 않으므로, 고객 과제가 분류인지 생성인지는 "출력이 선택지 안의 값인가, 새 문장·이미지인가"로 판별합니다. 이탈 고객 예측이나 스팸 판정을 요청받았다면 생성형이 아니라 분류 문제일 수 있고, 이 구분이 모델 선택과 평가 지표를 가릅니다.
2.1.2 학습 방식과 새 결과물을 만드는 원리
생성형 AI는 방대한 예시를 보고 배웁니다. 아이에게 이야기 쓰기를 가르친다고 생각해 봅시다. 동화책 수천 권을 읽히면 아이는 어떤 단어가 함께 오는지, 문장이 어떻게 흐르는지, 이야기가 어떻게 시작하고 끝나는지 익힙니다. 텍스트 AI도 책, 기사, 웹사이트 같은 인터넷상의 글 상당 부분을 학습(training) 단계에서 읽습니다.
이때 AI는 글을 단어 그대로 외우지 않고 패턴을 배웁니다. 어떤 단어 뒤에 어떤 단어가 자주 오는지, 생각이 어떻게 이어지는지, 언어의 문체와 구조가 어떤지를 익히며, 학습이 끝나면 이 패턴으로 스스로 새 문장을 만듭니다. 이미지도 같은 원리입니다. 그림과 설명문 쌍을 대량으로 학습하면 "고양이", "자전거", "달"이 어떻게 생겼는지 알게 되고, 한 번도 본 적 없는 "달 위에서 자전거 타는 고양이"도 배운 패턴을 섞어 그립니다.
텍스트를 만드는 방법은 의외로 단순합니다. 다음 단어를 예측하는 일을 계속 반복합니다. 모델 안에서 이 쓰기 작업을 맡는 부분이 디코더입니다(2.8 참조). 시작 문구가 "The sky is"라면 AI는 학습된 지식으로 "blue"가 가장 그럴듯하다고 보고 붙입니다. 그 뒤 "The sky is blue" 다음 단어로 "and"를 붙이고, 다시 "clear"를 붙이는 식으로 문장이 완성될 때까지 반복합니다.
| 단계 | 입력 | 예측한 다음 단어 |
|---|---|---|
| 1 | The sky is | blue |
| 2 | The sky is blue | and |
| 3 | The sky is blue and | clear |
| 4 | The sky is blue and clear | (계속) |
- AI는 문단 전체를 한 번에 쓰지 않습니다. 한 단어를 쓰고, 지금까지의 전체를 다시 보고, 다음 단어를 씁니다.
- 길고 똑똑해 보이는 답도 실제로는 다음 단어 예측을 아주 빠르게 반복한 결과입니다.
- 안전한 "blue"를 고를지 의외의 단어에 모험을 걸지는 온도(Temperature)라는 조절값이 정하고, 후보를 거르는 Top-k와 Top-p가 거들어 줍니다(2.11, 2.12 참조).
- 이렇게 한 단어씩 만드는 방식을 자기회귀 생성이라 하며, 확률 관점의 설명은 2.3에 있습니다.
이미지, 오디오, 영상도 학습한 패턴을 쓴다는 정신은 같지만, 콘텐츠 종류마다 생성 방법이 다릅니다. 고객이 "사실을 정확히 답하는 시스템"을 원한다면 이 원리가 의미하는 바를 짚어야 합니다. 모델은 사실을 조회하는 것이 아니라 그럴듯한 다음 단어를 고르므로, 정확성은 별도 장치로 보강해야 합니다.
2.1.3 생성 가능한 결과물의 종류
생성형 AI는 텍스트에 한정되지 않습니다.
- 텍스트: 이메일, 이야기, 기사, 답변, 요약을 씁니다.
- 이미지: 간단한 설명으로 그림, 사진, 로고, 아트를 만듭니다.
- 오디오: 음악을 만들고, 텍스트를 읽어 주는 사람 같은 음성을 만듭니다.
- 영상: 텍스트 설명으로 짧은 영상 클립을 만듭니다.
- 코드: 프로그램을 작성하고 개발자의 소프트웨어 개발을 돕습니다.
이 결과물을 만드는 학습된 두뇌를 모델이라 부릅니다. 모델은 학습의 최종 산출물, 곧 방대한 데이터를 이미 읽고 그 안의 패턴을 익힌 두뇌에 해당하며, 우리가 생성형 AI 도구와 대화한다는 것은 이 학습된 모델과 대화한다는 뜻입니다. 모델이 주로 텍스트와 언어를 다룰 때 대규모 언어 모델(Large Language Model, LLM)이라 합니다.
- Large: 아주 많은 양의 텍스트로 학습했고, 배운 것을 저장하는 내부 설정값이 아주 많습니다.
- Language: 사람의 언어를 이해하고 만드는 일이 주된 역할입니다.
- Model: 학습한 지식을 담은 학습된 두뇌입니다.
2026년 8월 글 기준으로 ChatGPT, Claude, Gemini 뒤에 있는 모델이 모두 LLM이며, 우리가 쓰는 생성형 AI 도구를 움직입니다. 따라서 "생성형 AI"는 넓은 범주이고 "LLM"은 그 안에서 텍스트를 다루는 모델 종류입니다. 고객이 두 용어를 섞어 쓰면 이미지·음성 요구까지 LLM 하나로 해결된다고 가정하고 있는지 확인해야 합니다. 정의는 2.2에서 내부 작동으로 이어집니다.
2.1.4 알아야 할 한계
생성형 AI는 강력하지만 완전하지 않습니다. 한계를 알아야 현명하게 씁니다.
- 틀릴 수 있습니다. 소리가 맞아 보이는 것을 예측하므로 사실이 아닌 내용을 지어내기도 하며, 이를 환각(hallucination)이라 합니다(2.18 참조). 중요한 정보는 반드시 검증합니다.
- 진짜로 이해하지는 못합니다. 패턴에는 아주 능하지만 사람처럼 무언가를 "안다"고 하기는 어렵고, 실제 감정이나 삶의 경험도 없습니다.
- 사람이 만든 데이터에서 배웁니다. 사람이 쓴 글에서 배우므로 그 데이터에 있는 실수와 편견도 함께 익힐 수 있습니다.
- 좋은 프롬프트가 필요합니다. 답의 품질은 얼마나 명확하게 요청하는지에 크게 좌우됩니다. 명확한 프롬프트가 더 나은 결과를 냅니다.
학습에서 모델에 들어가는 전체 흐름은 다음과 같습니다. 데이터를 모으고, AI가 데이터를 읽어 패턴을 배우는 학습을 거치고, 그 결과 학습된 두뇌인 모델이 준비됩니다. 사용자가 평범한 말로 요청을 주면 이 요청이 프롬프트(prompt)이고, 모델은 학습한 패턴으로 새 답을 만들어 냅니다.
flowchart TD
  D["대량의 데이터 (텍스트, 이미지, 코드)"] -->|패턴을 읽고 배움| T[학습]
  T --> M[학습된 모델]
  P["프롬프트: 비에 관한 시를 써 줘"] --> M
  M --> O[새 콘텐츠: 방금 만든 시]
그림 2.1.4 — 데이터에서 학습한 모델이 프롬프트를 받아 새 결과물을 만드는 전체 흐름.
일상에서는 채팅 어시스턴트, 글쓰기 보조(이메일 작성, 문법 교정, 긴 글 요약), 이미지 생성, 코딩 보조, 고객 지원 챗봇에서 쓰입니다. 자주 나오는 오해도 짚어 둡니다.
- 학습 데이터를 복사하는가: 아닙니다. 옛 답을 복사해 붙이지 않고, 학습 중에도 글을 단어 그대로 외우지 않으며, 패턴으로 새 콘텐츠를 만듭니다.
- LLM과 생성형 AI는 같은가: 정확히는 같지 않습니다. 생성형 AI는 넓은 유형이고 LLM은 주로 텍스트를 다루는 학습된 모델입니다.
- 머신러닝 위에 있는가: 그렇습니다. 판정하는 기존 AI와 만드는 생성형 AI 모두 머신러닝 위에 있습니다.
고객 현장에서는 이 도구를 "똑똑한 조력자"로 두고 최종 진실의 원천으로 쓰지 않는다는 원칙을 먼저 합의합니다. 검증 책임이 누구에게 있는지, 틀린 답이 나갈 때의 비용이 얼마인지를 묻는 것이 도입 범위를 정하는 첫 질문입니다.
2.2 LLM은 어떻게 동작하는가: 개관
LLM은 겉으로는 대화하는 도구처럼 보이지만 안쪽에서는 "다음 단어를 예측한다"는 한 가지 일만 반복합니다. 이 절은 텍스트가 숫자로 바뀌고, 트랜스포머를 지나 예측이 나오고, 학습으로 그 예측이 좋아지는 전 과정을 한 장의 지도로 보여 줍니다. 아래 설명은 2026년 10월에 게시된 글을 기준으로 합니다.
2.2.1 다음 단어 예측
LLM(Large Language Model)은 방대한 텍스트를 읽고 사람의 언어를 이해하고 만들어 내도록 학습된 모델입니다. 이름의 세 단어는 각각 뜻이 있습니다.
- Large: 웹 페이지, 책, 기사, 코드처럼 아주 많은 텍스트로 학습했다는 뜻이며, 학습 중에 조정되는 내부 숫자인 파라미터(parameter)가 수십억 개에 이른다는 뜻이기도 합니다.
- Language: 영어, 힌디어, 스페인어 같은 사람의 언어를 읽고 씁니다.
- Model: 정확한 규칙을 받는 대신 예시에서 패턴을 배웁니다.
동화책 수천 권을 여러 해 읽은 아이를 떠올리면 됩니다. 아무도 언어 규칙집을 준 적이 없는데도 그 아이는 우리가 시작한 문장을 끝맺고, 새 이야기를 쓰고, 질문에 답합니다. LLM도 같은 방식으로 방대한 텍스트에서 언어가 작동하는 방식을 규칙 없이 배웁니다.
핵심은 LLM이 본질적으로 다음 단어 하나를 예측할 뿐이라는 점입니다. "The sky is"를 주면 가장 그럴듯한 다음 단어로 "blue"를 예측합니다. 이때 하나만 고르는 것이 아니라 가능한 여러 단어에 확률을 매긴 뒤 그중 하나를 선택합니다.
| 후보 단어 | 확률 |
|---|---|
| blue | 70% |
| clear | 15% |
| grey | 10% |
| falling | 5% |
"blue"의 확률이 가장 높아 선택될 가능성이 가장 크지만, 확률적으로 고르므로 다른 단어가 나올 수도 있습니다. 이 확률에서 어떻게 하나를 고르는지는 별도 주제입니다(2.12 참조). 단어 하나만 예측하는 모델이 긴 문단을 쓰는 이유는 이 예측을 반복하기 때문이며, 그 반복은 2.2.4의 앞부분에서 보입니다. 고객에게 설명할 때는 "LLM은 사실을 조회하지 않고 그럴듯한 다음 단어를 확률로 고른다"는 한 문장이 이후 모든 한계 논의의 출발점입니다.
2.2.2 토큰과 임베딩
LLM은 단어를 직접 다루지 못하고 숫자만 다룹니다. 첫 단계는 텍스트를 작은 조각으로 쪼개는 것이고, 이 조각이 토큰(token)입니다. 토큰은 단어 전체일 수도, 단어의 일부일 수도, 문자 하나일 수도 있습니다. "I love learning"은 "I", " love", " learn", "ing" 네 토큰으로 나뉠 수 있고, "learning"이 "learn"과 "ing"로 갈라진 것은 LLM이 자주 쓰이는 덩어리 단위로 쪼개기 때문입니다(2.5 참조).
각 토큰에는 토큰 ID라는 번호가 붙습니다. 예시로 "I"→40, " love"→1842, " learn"→4673, "ing"→278이라면 문장은 [40, 1842, 4673, 278]이 됩니다. 이 번호는 설명용이며 LLM마다 자기 토큰 목록이 있습니다. 텍스트를 토큰으로 쪼개는 과정이 토큰화(tokenization)입니다(2.4 참조). 엄밀히 LLM이 예측하는 것은 단어가 아니라 다음 토큰이며, 이해를 돕기 위해 "단어"라고 부를 뿐입니다.
그런데 1842는 이름표일 뿐 의미를 담지 않습니다. "love"의 번호가 "hate"의 번호보다 크거나 작다는 사실에는 아무 뜻이 없습니다. 이 문제를 해결하는 것이 임베딩(embedding), 곧 토큰의 의미를 나타내는 숫자 목록입니다(2.6 참조). 원-핫 벡터에서 임베딩으로 이어지는 흐름은 1.4.4에도 있습니다.
| 토큰 | 임베딩(앞 세 값만) |
|---|---|
| king | 0.8, 0.6, 0.1, ... |
| queen | 0.8, 0.6, 0.9, ... |
| apple | 0.1, 0.2, 0.7, ... |
"king"과 "queen"은 의미가 비슷해 숫자도 비슷하고, "apple"은 의미가 달라 숫자도 많이 다릅니다. 이 숫자는 사람이 정하지 않으며, 네트워크가 학습 중에 많은 텍스트를 읽고 "king"과 "queen"이 관련 있음을 스스로 파악해 비슷한 값을 줍니다. 결국 임베딩은 평범한 토큰이 컴퓨터가 다룰 수 있는 의미를 얻는 방법입니다. 고객이 한국어 문서를 넣었을 때 비용과 품질이 달라지는 이유도 이 토큰화 단계에서 시작되므로(2.4.5 참조), 토큰 수를 직접 세어 보는 습관이 필요합니다.
2.2.3 트랜스포머와 어텐션
모든 현대 LLM의 엔진이 트랜스포머(Transformer)입니다(2.8 참조). 2017년 "Attention Is All You Need"라는 논문에서 소개되었고, 그 이전의 언어 모델은 텍스트를 한 단어씩 순서대로 읽어서 느렸고 앞쪽 단어를 놓치기 쉬웠습니다(2.10.1 참조). 트랜스포머는 모든 단어를 한꺼번에 보면서 서로의 관계를 파악합니다. LLM은 트랜스포머 층을 여러 겹 쌓아 만들며, 임베딩으로 들어온 토큰이 층 1, 층 2, … 층 N을 차례로 통과하면서 층마다 텍스트에 대한 이해가 조금씩 깊어지고, 마지막에 다음 토큰의 예측이 나옵니다.
flowchart TD
  I[입력 토큰 임베딩] --> L1[트랜스포머 층 1]
  L1 --> L2[트랜스포머 층 2]
  L2 --> LD[...]
  LD --> LN[트랜스포머 층 N]
  LN --> P[다음 토큰 예측]
그림 2.2.3 — 임베딩이 여러 트랜스포머 층을 차례로 통과해 다음 토큰의 예측이 됩니다.
엔진 안에서 가장 중요한 부품이 어텐션(attention)입니다. 어텐션은 문장 속 각 단어가 다른 단어를 살펴 자기 의미에 중요한 것을 가려내는 메커니즘입니다(2.9 참조). 예문은 "The animal did not cross the street because it was too tired."입니다. "it"이 동물인지 길인지는 사람에게 즉시 보입니다. 길은 피곤할 수 없기 때문입니다. LLM이 이를 맞히려면 "it"이 "animal"에 주목해야 하며, 어텐션이 "it"과 "animal"을 연결합니다. "it"은 앞의 모든 단어를 돌아보며 "animal"에 가장 강하게 주목합니다.
- 문장의 모든 단어가 이 일을 합니다.
- LLM에서는 각 단어가 자기 자신과 앞선 단어들만 보고, 각각에 얼마나 주목할지 정합니다(2.3.3 참조).
- 이렇게 모든 단어의 관계에 대한 이해가 쌓입니다.
대명사가 가리키는 대상을 놓치는 오류는 긴 문서에서 실제로 생깁니다. 고객 문서의 문장이 지시어로 가득하다면 청킹(5.6 참조)과 요약 방식을 먼저 점검할 이유가 됩니다.
2.2.4 사전학습과 파인튜닝
LLM이 한 번에 한 단어를 예측하면서도 긴 답을 쓰는 방식부터 봅니다. 한 단어를 예측하고, 그것을 텍스트에 붙이고, 다시 다음 단어를 예측하는 루프를 답이 끝날 때까지 돌립니다. 자기 출력을 다시 입력에 되먹이는 이 방식이 자기회귀(autoregression)입니다(2.3 참조). "The capital of France is"가 "Paris"를 낳고, "…is Paris"가 "."를 낳고, "…is Paris."에서 특별한 정지 토큰이 나오면 끝입니다(2.13 참조). 각 단계에서 더 길어진 텍스트로 다음을 예측하므로 LLM이 답을 한 단어씩 타이핑하는 것처럼 보이는 것입니다.
그렇다면 처음 만들어진 LLM은 어떻게 이 예측을 배울까요? 막 만든 LLM의 파라미터는 모두 무작위라서 첫 예측은 엉터리입니다. 학습은 방대한 텍스트로 하는 다음 단어 맞히기 게임입니다.
- 실제 문장 "The sun rises in the east"에서 마지막 단어를 숨기고 "The sun rises in the"까지만 보여 줍니다.
- LLM이 예측합니다. 초기에는 "banana"처럼 무작위로 틀립니다.
- 정답 "east"와 예측의 차이를 손실(loss)로 잽니다(1.7 참조). 손실이 크면 크게 틀렸다는 뜻입니다.
- 정답 "east"가 나올 확률이 조금 높아지도록 내부 숫자를 약간 조정합니다. 이 조정이 역전파(backpropagation)와 경사하강법(Gradient Descent)입니다(1.9.4, 1.13 참조). 오류를 거슬러 추적해 모든 숫자를 오차가 줄어드는 방향으로 조금씩 움직이는 일입니다.
이 순환이 수조 개의 토큰에 대해 반복되면서 무작위 네트워크가 언어를 아주 잘 예측하는 모델로 변합니다. 이 방식의 이점은 누구도 데이터에 라벨을 달지 않는다는 점입니다. 정답인 다음 단어가 이미 텍스트 안에 있으므로 텍스트 자체가 문제와 답을 모두 줍니다(1.2 참조).
학습은 두 단계로 나뉩니다. 사전학습(pretraining)은 인터넷, 책, 코드의 방대한 텍스트로 하는 위 게임이며, 끝난 모델은 언어와 세상에 대해 많이 알지만 아직 "글 이어 쓰기 기계"일 뿐 도움이 되는 비서는 아닙니다. 파인튜닝(fine-tuning)은 지시를 따르고 유익하고 정직하고 안전하게 행동하는 법을 보여 주는 엄선된 예시로 추가 학습하는 두 번째 단계입니다(11.1 참조). 널리 쓰이는 방법이 사람이 답에 점수를 매기고 LLM이 더 나은 답을 선호하게 만드는 RLHF(인간 피드백 강화학습)입니다(11.6 참조). 사전학습은 날것의 지식을 주고, 파인튜닝은 쓸모 있게 행동하는 법을 가르칩니다.
flowchart TD
  A["대량의 인터넷 텍스트 (수조 토큰)"] --> B[사전학습]
  B --> C[언어와 사실을 아는 날것의 LLM]
  C --> D[파인튜닝]
  D --> E[지시를 따르는 유용한 어시스턴트]
그림 2.2.4 — 사전학습이 지식을 만들고 파인튜닝이 어시스턴트 행동을 입힙니다.
고객이 "우리 데이터로 학습시켜 달라"고 할 때 어느 단계를 말하는지 묻는 것이 첫 질문입니다. 사전학습은 사실상 모델 제공자의 일이고, 고객 쪽 선택지는 대개 파인튜닝이나 검색 보강입니다.
2.2.5 컨텍스트 윈도우와 환각
컨텍스트 윈도우(context window)는 LLM이 한 번에 볼 수 있는 텍스트의 최대량이며 토큰으로 잽니다(2.16 참조). LLM의 단기 기억이라 할 수 있고, 창에 들어오는 텍스트에만 주목할 수 있습니다. 창이 100,000 토큰이라면 질문과 답변을 합쳐 대략 그만큼의 토큰만 한꺼번에 고려합니다. 대화가 창보다 길어지면 애플리케이션이 가장 오래된 텍스트를 버리거나 줄이고(4.5 참조), 그 부분은 LLM이 더 볼 수 없습니다. 그래서 긴 대화에서 처음 한 말을 LLM이 잊는 일이 생깁니다. 현대 LLM은 책이나 대형 코드베이스를 한 번에 읽을 만큼 큰 창을 가지기도 하지만 한계는 항상 있습니다.
환각(hallucination)은 LLM이 틀렸거나 지어낸 정보를 확신에 찬 어조로 내놓는 현상입니다(2.18 참조). 원인은 핵심 원리에서 나옵니다. LLM은 데이터베이스에서 사실을 찾지 않고 학습한 패턴에 따라 그럴듯하게 들리는 텍스트를 만듭니다. 잘 배우지 못한 주제를 물어도 진실을 검증하는 것이 아니라 그럴듯한 단어를 예측하는 것이 일이므로 매끄럽고 자신 있는 답이 나옵니다. 어떤 저자의 책을 물었을 때 확신이 없으면 실제로 없는 책 제목을 그럴듯하게 꾸며내는 식입니다. 그래서 이름, 숫자, 날짜, 인용문은 반드시 검증합니다.
- 환각을 줄이는 대표 방법이 RAG(Retrieval-Augmented Generation)입니다. 시스템이 믿을 만한 출처에서 먼저 사실을 가져와 LLM에게 주고, LLM은 추측하는 대신 실제 정보로 답합니다(5장 참조).
- 활용처는 AI 어시스턴트, 글쓰기 보조, 코딩 보조, 번역, 요약, 고객 지원 자동 응답, 링크 목록 대신 직접 답을 주는 검색입니다.
FAQ에서 자주 나오는 질문도 같은 원리로 풀립니다. LLM이 데이터베이스를 조회하는지는 아니오이고, 정답이 틀리는 이유와 같습니다. 단어를 예측하는지 토큰을 예측하는지는 토큰이 맞습니다. 사전학습 데이터는 아무도 손으로 라벨링하지 않으며, 긴 대화의 앞부분을 잊는 것은 컨텍스트 윈도우 때문입니다. 현장에서는 "이 답의 근거가 모델의 기억인가, 우리가 넣은 문서인가"를 구분해 묻는 습관이 환각 대응의 시작입니다.
2.3 자기회귀 모델(Autoregressive Model)
원문: What are Autoregressive Models?
LLM이 답을 한 단어씩 "타이핑"하는 이유, 긴 답이 더 오래 걸리는 이유, 앞쪽의 틀린 토큰이 뒤를 망치는 이유가 모두 하나의 구조에서 나옵니다. 이 절은 2.2의 단어 단위 생성을 확률과 수치로 풀어 그 구조를 해부합니다. 아래 설명은 2026년 5월에 게시된 글을 기준으로 합니다.
2.3.1 확률의 연쇄 법칙(Chain Rule)
자기회귀 모델(Autoregressive Model)은 지금까지 만든 모든 조각으로 다음 조각을 예측하며 한 번에 하나씩 생성하는 모델입니다. 이름은 Auto(스스로)와 Regressive(과거 값으로 값을 예측함)가 합쳐진 것입니다. 모델이 자기 이전 출력을 다음 입력으로 쓴다는 뜻이며, 과거 7일의 기온으로 내일 기온을 예측하는 것이 "과거로 다음 값을 예측한다"의 간단한 예입니다. 여기서 조각은 토큰이며, 모델이 읽고 쓰는 작은 텍스트 단위입니다(2.4 참조). 예를 들어 "I love AI"는 "I", "love", "AI" 세 토큰으로 나뉩니다.
언어 모델의 동작은 이렇습니다. "I"를 보고 "love"를 예측하고, "I love"를 보고 "AI"를 예측하고, "I love AI"를 보고 다음 토큰(흔히 문장 끝 표지)을 예측합니다. 매 단계에서 지금까지의 전체 이력으로 다음 토큰을 추측한다는 점이 핵심입니다. ChatGPT가 문장을 쓰는 방식, WaveNet이 오디오 샘플을 만드는 방식, PixelCNN이 이미지를 픽셀 단위로 그리는 방식이 모두 이 구조입니다.
이 아이디어의 수학적 형태가 확률의 연쇄 법칙(chain rule of probability)입니다. 전체 시퀀스의 결합 확률(모든 토큰이 이 순서로 함께 나올 확률)은 각 토큰의 조건부 확률(조건이 주어졌을 때의 확률)의 곱으로 쓸 수 있습니다.
P(x_1, x_2, ..., x_n) = P(x_1) * P(x_2 | x_1) * P(x_3 | x_1, x_2) * ... * P(x_n | x_1, ..., x_{n-1})x_1 ... x_n은 시퀀스의 토큰들입니다.P(x_i | x_1, ..., x_{i-1})는 앞선 모든 토큰이 주어졌을 때i번째 토큰의 조건부 확률입니다.|는 "주어졌을 때(given)"로 읽으므로P(B | A)는 "A가 주어졌을 때 B의 확률"입니다.
"I love AI"에 적용하면 P("I love AI") = P("I") * P("love" | "I") * P("AI" | "I", "love")입니다. 오른쪽의 모든 항이 같은 질문을 던집니다. 지금까지 본 것을 전제로 다음 단어의 확률은 얼마인가. 자기회귀 모델은 바로 이 질문에 답하도록 학습됩니다. 즉 문장 전체의 확률을 한 번에 계산하지 않고 한 토큰씩 쌓아 만든다는 것이 이 모델의 본질입니다.
2.3.2 생성 루프와 수치 예제
자기회귀 생성은 같은 단계를 반복하는 루프이며 매번 과거가 토큰 하나씩 늘어납니다. 한 번의 생성 단계는 네 동작으로 이뤄집니다.
- 지금까지의 토큰(과거)을 모델에 넣습니다.
- 모델이 어휘 안의 모든 토큰에 대해 다음 토큰의 확률을 냅니다.
- 그 확률에서 토큰 하나를 고릅니다. 이 선택이 샘플링(sampling)입니다(2.12 참조).
- 고른 토큰을 과거에 덧붙이고 1로 돌아갑니다.
루프는 문장 끝 표지가 나오거나 설정한 최대 길이에 닿을 때까지 돕니다. 의사코드로 쓰면 past = [start_token]에서 시작해 probs = model(past), next_token = sample(probs), past = past + [next_token]을 end_token이 나올 때까지 반복합니다. 한 번 도는 데 토큰이 정확히 하나 나오므로 100 토큰을 만들려면 모델이 100번 실행됩니다. 이 방식의 대가는 속도입니다. 새 토큰마다 전체 과거를 조건으로 삼으므로 품질은 높지만, 토큰 사이를 병렬화할 수 없어 느립니다. 한 토큰씩 나오는 성질 덕분에 토큰이 만들어지는 즉시 사용자에게 흘려보내는 스트리밍이 가능해집니다(2.15 참조).
이제 실제 숫자로 돌려 봅니다. 어휘가 5개인 작은 모델 vocab = ["I", "love", "AI", "code", "<end>"]을 가정하고, 첫 토큰 "I"로 시작합니다. 아래 숫자는 이해를 위한 둥근 값이며, 실제 모델의 어휘는 5만 개 이상이지만 원리는 같습니다.
| 단계 | 과거 | I | love | AI | code | <end> |
고른 토큰 |
|---|---|---|---|---|---|---|---|
| 1 | ["I"] |
0.05 | 0.60 | 0.15 | 0.15 | 0.05 | love |
| 2 | ["I","love"] |
0.05 | 0.05 | 0.70 | 0.15 | 0.05 | AI |
| 3 | ["I","love","AI"] |
0.05 | 0.05 | 0.05 | 0.05 | 0.80 | <end> |
- 각 행의 확률 합은
1.0(100%)입니다. 재계산하면 1단계 0.05+0.60+0.15+0.15+0.05, 2단계 0.05+0.05+0.70+0.15+0.05, 3단계 0.05×4+0.80 모두 1.0입니다. - 1단계에서 모델은
P("love" | "I") = 0.60으로 "love"를 가장 그럴듯하게 봅니다. 2단계에서는 "love"까지 보았고"I love AI"가 흔한 문장이므로"AI"의 확률이 0.70으로 뜁니다. 3단계에서는 문장이 끝났다고 보아<end>가 0.80입니다. - 이 예제는 매번 최고 확률 토큰을 고르는 탐욕적 디코딩(greedy decoding)을 썼습니다. 더 무작위로 고르는 방식이 온도 샘플링입니다(2.11 참조).
전체 문장의 확률은 단계별 확률의 곱입니다. 첫 토큰 P("I") = 0.20이라 가정하면 P("I love AI <end>") = 0.20 × 0.60 × 0.70 × 0.80 = 0.0672입니다(python3 -I로 재계산하여 일치함을 확인했습니다). 이 값이 곧 연쇄 법칙이 말한 결과이며, 모델은 결합 확률을 한 번에 계산하지 않고 한 토큰씩 쌓습니다. 현장에서 "모델이 이 답에 얼마나 확신했는가"를 묻는다면 이 단계별 확률이 로그 확률로 노출됩니다(2.14 참조).
GPT 계열이 자기회귀인 이유도 같은 구조입니다. GPT(Generative Pre-trained Transformer)는 첫 단어 Generative가 가리키듯 설계부터 자기회귀이며, 학습 과제는 "과거 토큰이 주어지면 다음 토큰을 예측하라" 하나뿐입니다. 2026년 5월 글 기준으로 Gemini, LLaMA 같은 언어 모델도 자기회귀이며 디코더 전용(decoder-only) 트랜스포머로 설명됩니다(2.8 참조). Gemini와 LLaMA는 기술 보고서가 이를 밝히고 있고, Claude는 아키텍처가 공개되지 않아 같은 구조일 것이라는 추정입니다. 자기회귀 방식으로 한 토큰씩 생성하는 것은 Claude도 마찬가지입니다. 프롬프트가 처음의 과거가 되고, 모델이 예측하고, 새 토큰이 붙고, 모델이 멈추기로 할 때까지 반복됩니다. 그래서 GPT 계열은 허용하는 한 계속 쓸 수 있습니다. 항상 볼 과거가 있고 거기서 토큰 하나를 더 예측할 줄 알기 때문입니다.
2.3.3 인과 마스킹(Causal Masking)이 필요한 이유
학습 중에는 모델이 문장 전체를 한 번에 보지만, 각 토큰을 예측할 때는 앞선 토큰만 써야 합니다. 미래 토큰을 엿보면 모델이 정답을 예측하는 법을 배우는 대신 베끼게 되어 학습이 무의미해집니다. 이를 막는 간단한 장치가 인과 마스킹(causal masking)이며, 어텐션 층 안에서 각 위치에서 미래 토큰을 가립니다.
"I love AI"로 보면 위치 1("love")을 예측할 때는 위치 0("I")만, 위치 2("AI")를 예측할 때는 위치 0과 1만 볼 수 있습니다. 구현은 미래 위치의 어텐션 점수를 음의 무한대로 두는 것입니다. 그러면 Softmax를 거친 뒤 그 위치의 가중치가 0이 되어 완전히 무시됩니다. Softmax는 원점수 목록을 합이 1.0인 확률로 바꾸는 함수입니다(1.11 참조). 3토큰 문장의 마스크는 다음과 같습니다.
| 보는 쪽 \ 보이는 쪽 | I | love | AI |
|---|---|---|---|
| I | 1 | 0 | 0 |
| love | 1 | 1 | 0 |
| AI | 1 | 1 | 1 |
1은 볼 수 있음, 0은 차단입니다. 윗삼각형이 모두 0이어서 삼각 마스크(triangular mask)라 부릅니다. 첫 행의 "I"는 자기 자신만, 둘째 행의 "love"는 "I"와 자신, 셋째 행의 "AI"는 셋 모두를 봅니다. 학습 때 문장 전체를 한 번에 넣어도 모델은 자기회귀로 행동하도록 강제됩니다. 추론 때는 토큰을 하나씩 만들므로 엿볼 미래 토큰이 아예 없어 규칙이 자연스럽게 지켜집니다. 같은 모델이 두 가지로 조금 다르게 움직이는 것입니다. 이 마스크가 놓이는 어텐션 계산은 2.9 참조입니다.
2.3.4 비자기회귀 생성과의 비교
자기회귀 생성은 순차적이어서 토큰 하나, 다음 하나, 다음 하나를 차례로 만들며 각 토큰이 앞선 모든 토큰에 의존합니다. 비자기회귀(non-autoregressive) 생성은 병렬로, 앞 토큰을 기다리지 않고 여러 토큰을 한꺼번에 만들려 합니다.
| 항목 | 자기회귀 | 비자기회귀 |
|---|---|---|
| 생성 순서 | 왼쪽에서 오른쪽으로 한 번에 한 토큰 | 여러 토큰을 병렬로 동시에 |
| 각 토큰의 의존 | 앞선 모든 토큰 | 다른 생성 토큰에 대한 의존이 제한적이거나 없음 |
| 속도 | 느림(토큰당 모델 1회 실행) | 빠름(여러 토큰에 모델 1회 실행) |
| 품질 | 대체로 높고 유창 | 대체로 낮고 반복·주제 이탈 토큰 가능 |
| 학습 | 단순(다음 토큰 예측) | 더 복잡한 목적 함수 |
| 예 | GPT, WaveNet, PixelCNN | 일부 번역 모델, 병렬 디코더 |
- VAE(Variational Autoencoder)는 매끄러운 잠재 공간에서 샘플링해 출력 전체를 한 번에 만드는 비자기회귀 생성 모델의 고전적 예입니다.
- GAN(Generative Adversarial Network)은 두 네트워크가 경쟁하며 이미지 전체를 한 번에 만드는 또 다른 비자기회귀 예입니다.
- 텍스트에서 대표적인 비자기회귀 접근은 확산 언어 모델(Diffusion Language Model)이며, 문장 전체를 병렬로 채우고 다듬습니다.
적용 범위는 텍스트에 그치지 않습니다. 데이터를 시퀀스로 늘어놓을 수 있다면 자기회귀를 적용할 수 있습니다. 언어 모델(GPT 계열)은 프롬프트와 지금까지의 생성 결과를 조건으로 토큰을 만들고, PixelCNN은 위와 왼쪽의 픽셀로 다음 픽셀을 예측하며 이미지를 시퀀스로 봅니다. WaveNet은 오디오를 샘플 단위로 만드는데 초당 16,000 샘플이면 1초 오디오에 모델이 16,000번 돌아 느리지만 품질이 아주 높습니다. 음악 모델은 앞선 음들을 조건으로 음을 하나씩 만듭니다. 고객이 지연 시간을 요구하면 "자기회귀이므로 출력이 길수록 선형으로 느려진다"는 사실이 설계의 제약이 됩니다.
2.3.5 장단점
자기회귀의 장점은 네 가지입니다. 매 단계에서 전체 과거를 쓰므로 출력이 일관되고 유창하며, 학습 목표가 다음 토큰 예측 하나로 가장 단순하고, 길이가 유연해서 원하는 만큼 계속 만들고 멈출 시점을 통제할 수 있습니다. 그리고 하나의 자기회귀 언어 모델이 번역, 요약, 질의응답, 코드 생성 등 많은 일을 합니다.
단점도 뚜렷합니다.
- 느린 생성: 토큰을 하나씩 만들어야 하므로 100 토큰은 모델 100회 실행입니다. 대기 시간이 출력 길이에 따라 늘어나며, 1,000 토큰 답은 100 토큰 답보다 대략 10배 오래 걸립니다. 토큰
t+1은 토큰t가 정해지기 전에는 계산할 수 없습니다. - 오류 누적(error compounding): 이른 시점의 나쁜 토큰이 출력 전체를 해칠 수 있습니다. 이후 모든 토큰이 그 토큰을 조건으로 삼기 때문이며, 5번 토큰이 틀리면 6, 7, 8번 토큰도 틀린 과거 위에서 만들어집니다(2.18.4 참조).
- 병렬화 불가: 생성 단계는 순차적이어서 토큰 사이에 병렬성이 없습니다.
이 문제를 누그러뜨리는 기법이 KV 캐시(10.3 참조), 투기적 디코딩(10.6 참조), 더 나은 샘플링 전략입니다. Medusa와 EAGLE은 모델이 자기 다음 토큰 여러 개를 한 번에 짐작하게 하는 계열입니다. 단, 느리지만 품질이 높다는 핵심 교환은 자기회귀 아이디어에 내재해 있습니다.
KV 캐시가 필요해지는 이유도 이 구조에서 나옵니다. 매 단계에서 모델은 전체 과거를 보는데, 과거가 999 토큰이면 어텐션 층은 그 999개와 새 토큰의 Key와 Value를 계산해야 합니다. 이전 단계에서 이미 계산한 값을 반복하는 낭비입니다. 해결은 이전 단계의 Key와 Value를 저장해 재사용하고 새 토큰의 것만 계산하는 것으로, 저장된 메모리가 KV 캐시(K는 Key, V는 Value)입니다(10.3 참조). 1,000 토큰을 생성한다면 캐시가 없을 때 단계 t마다 과거 t개를 다시 계산해 1 + 2 + 3 + ... + 1000 = 500,500 단위의 작업이 되고, 캐시가 있으면 매 단계 새 토큰 하나만 계산하므로 약 1,000 단위입니다(python3 -I로 500,500 확인). 과거는 단계 사이에 변하지 않고 토큰 하나만 추가되는 모양이므로 과거를 캐시할 수 있습니다.
FAQ의 질문도 이 구조로 답이 됩니다. 모델은 문장 끝 표지가 나오거나 설정한 최대 길이에 닿으면 멈춥니다(2.13 참조). 긴 답이 오래 걸리는 것은 토큰마다 모델이 한 번씩 돌기 때문입니다. 한 토큰이 전체를 망칠 수 있는가에는 예, 오류 누적이 그 이유입니다. 현장에서는 응답 지연이 문제라고 하면 출력 길이와 캐시 활용부터 점검하고, 품질 문제는 앞 토큰 오류가 뒤로 번졌는지 본다는 판단 기준을 세웁니다.
2.4 토큰화(Tokenization)
원문: Tokenization in LLMs
영상: Tokenization in Large Language Models (LLMs)
모델은 글자도 단어도 보지 못하고 숫자만 받습니다. 토큰화는 그 숫자를 만드는 첫 단계이며, 비용 청구, 컨텍스트 한도, 글자 세기 실수, 한국어 비용 차이가 모두 여기서 결정됩니다. 아래 설명은 2026년 10월에 게시된 글을 기준으로 합니다.
2.4.1 문자·단어·서브워드 세 가지 방식
토큰화(tokenization)는 텍스트를 토큰이라는 작은 조각으로 쪼갠 뒤 각 토큰을 숫자로 바꾸는 과정입니다. "I love learning"을 입력하면 사람은 세 단어를 보지만 모델은 글자도 단어도 이해하지 못하고 숫자만 이해합니다. 그래서 문장은 "I" | " love" | " learning"으로 쪼개지고 40 | 3021 | 6975처럼 숫자가 되어, 텍스트가 아닌 숫자만 모델에 도달합니다. 이 숫자는 설명용이며 실제 값은 쓰는 토크나이저(tokenizer)에 따라 달라집니다. 이 일을 하는 프로그램이 토크나이저이고 LLM마다 자기 것을 가집니다.
토크나이저가 필요한 이유는 두 가지입니다. 첫째, LLM은 곱하고 더하고 비교하는 수학을 하는 모델이므로 숫자가 필요합니다. 둘째, 모델은 자기가 아는 조각의 고정된 목록을 가져야 합니다. 답을 만들 때 이 목록에서 한 번에 하나씩 고르기 때문입니다(2.3 참조). 목록이 너무 크면 모델이 느리고 무거워지고, 너무 작으면 모든 문장이 아주 긴 잔 조각의 사슬이 됩니다. 그래서 조각의 적절한 크기가 쟁점이고, 세 가지 접근이 있습니다.
토큰은 모델이 다루는 최소 텍스트 단위이며 단어 전체, 단어의 일부, 문자 하나, 문장부호, 앞 공백이 붙은 단어가 될 수 있습니다. "cat"은 토큰 1개, "unbelievable"은 "un", "believ", "able" 3개, "!"는 1개, 앞에 공백이 붙은 " love"도 1개입니다. 대부분의 현대 토크나이저는 공백을 뒤따르는 토큰에 붙여서 모델이 새 단어의 시작을 알게 합니다. 영어의 어림법칙은 토큰 하나가 약 4글자, 단어의 약 4분의 3이라서 100 토큰이 약 75 단어입니다.
접근 1, 문자 단위. 모든 문자가 토큰입니다. "learning"은 l,e,a,r,n,i,n,g 8개가 됩니다. 장점은 알아야 할 조각이 아주 적다는 것(영어라면 글자, 숫자, 몇 개의 문장부호)이고, 모든 단어가 문자로 이뤄져서 모르는 단어를 만날 일이 없다는 것입니다. 단점은 문장이 아주 길어진다는 점입니다. 100 단어짜리 짧은 문단이 약 500 토큰이 되고 모델은 그 모두를 처리해야 합니다. 또 문자 하나는 의미가 거의 없어서 l,e,a,r,n이 모여 learn이 된다는 것을 모델이 힘들게 배워야 합니다.
접근 2, 단어 단위. 공백으로 자른 단어가 토큰입니다. "I love learning"은 "I", "love", "learning" 3개입니다. 장점은 토큰마다 의미가 온전하고 시퀀스가 짧다는 것입니다. 단점은 알려진 단어 목록이 거대해진다는 것입니다. 영어만 해도 수십만 단어이고, 사람 이름, 지명, 다른 언어, 코드, 매일 생기는 신조어가 더해지면 끝이 없습니다. 목록에 없는 단어, 예컨대 "tokenization"이 없다면 토크나이저는 선택지 없이 그 단어를 미지(unknown) 토큰(보통 <UNK>)으로 바꾸고 모델은 사용자가 무엇을 말했는지 알 수 없습니다. "learn", "learning", "learned", "learner"가 모두 별개 토큰이라 관련성도 모르고 각각 처음부터 배워야 합니다.
접근 3, 서브워드 단위. 중간 길입니다. 흔한 단어는 하나의 토큰으로 두고, 드문 단어는 흔한 작은 조각으로 쪼갭니다. "the"와 "learning"은 흔해서 그대로 두고, "tokenization"은 "token", "ization", "unbelievable"은 "un", "believ", "able"로 쪼갭니다. 조각이 의미를 가지므로 모델은 "ization"이 대체로 어떤 행위를 한다는 뜻임을 배워 "organization", "civilization" 등에 재사용합니다.
| 항목 | 문자 단위 | 단어 단위 | 서브워드 단위 |
|---|---|---|---|
| 알려진 목록의 크기 | 아주 작음 | 아주 큼 | 중간 |
| 문장당 토큰 수 | 아주 많음 | 적음 | 적음 |
| 미지 단어 문제 | 없음 | 자주 | 없음 |
| 토큰당 의미 | 아주 적음 | 온전함 | 양호 |
| 현대 LLM 사용 | 아니오 | 아니오 | 예 |
서브워드의 목록은 보통 50,000~200,000개로 관리할 수 있고, 어떤 드문 단어도 아는 조각이 나올 때까지(최악이면 한 글자까지) 쪼개므로 미지 단어가 없으며, 관련 단어가 조각을 공유합니다. 단점은 단어가 사람에게 부자연스러운 지점에서 쪼개질 수 있다는 것입니다. 거의 모든 현대 LLM이 서브워드를 씁니다. 고객과 대화할 때는 "토큰은 단어와 1대1이 아니며 어림으로 영어 100 토큰이 75 단어"라는 환산으로 비용과 한도를 가늠합니다.
2.4.2 BPE 개요
서브워드 목록은 누가 정할까요? BPE(Byte Pair Encoding)는 단일 문자에서 출발해 가장 자주 이웃해 나오는 쌍을 반복해서 합치며 토큰 목록을 만드는 알고리즘입니다. 방대한 텍스트에서 가장 자주 붙어 나오는 두 조각을 찾아 한 조각으로 붙이는 일을 되풀이합니다. 단계별 상세는 2.5에서 다루며, 여기서는 작은 예제로 감을 잡습니다. 학습 텍스트가 "hug" 10번, "pug" 5번, "hugs" 5번뿐이라고 가정합니다.
- Step 0: 문자로 쪼갭니다.
h u g(10),p u g(5),h u g s(5). 시작 목록은h,u,g,p,s5개입니다. - Step 1: 쌍을 셉니다. h+u는 10+5=15, u+g는 10+5+5=20, p+u는 5, g+s는 5입니다. 최다 쌍 u+g를
ug로 합쳐 목록이 6개가 됩니다. - Step 2: 다시 셉니다. h+ug는 10+5=15, p+ug는 5, ug+s는 5입니다. h+ug를
hug로 합쳐 7개가 됩니다. - Step 3: p+ug와 hug+s가 5로 같습니다. 이럴 때 토크나이저는 정해진 규칙으로 하나를 고르며, 여기서는 p+ug를
pug로 합쳐 8개가 됩니다.
실제 토크나이저는 목록이 미리 정한 크기(예: 100,000)에 이를 때까지 반복합니다(위 단계의 쌍 개수는 python3 -I 시뮬레이션으로 재확인했습니다). 합친 순서대로 저장한 것이 규칙입니다. Rule 1은 u + g → ug, Rule 2는 h + ug → hug, Rule 3은 p + ug → pug입니다.
새 텍스트가 오면 토크나이저는 세지 않고 문자로 쪼갠 뒤 이 규칙을 같은 순서로 적용합니다. 학습 텍스트에 없던 "pugs"는 p u g s에서 시작해 Rule 1로 p ug s, Rule 2는 h가 없어 해당 없음, Rule 3으로 pug s가 되어 최종 pug, s입니다. 처음 본 단어인데도 의미 있는 토큰이 나옵니다.
- GPT 계열이 쓰는 현대 토크나이저는 시작 목록을 글자가 아니라 256가지 바이트 값 전체로 잡습니다. 모든 언어의 모든 문자, 이모지, 기호가 바이트로 저장되어 미지의 것을 만날 수 없으며, 이 변형을 바이트 수준 BPE(byte-level BPE)라 합니다.
- 토크나이저는 LLM을 학습하기 전에 따로 학습하며, 목록이 완성되면 고정됩니다. LLM은 그 고정된 목록으로 학습하고 토크나이저를 바꾸지 않습니다.
이 때문에 모델 A에서 센 토큰 수를 모델 B에 그대로 적용할 수 없습니다. 고객이 모델을 교체하면 같은 문서의 토큰 수와 비용이 달라진다는 점을 먼저 알려 둡니다.
2.4.3 어휘 사전과 토큰 ID, 디코딩
어휘 사전(vocabulary)은 토크나이저가 아는 모든 토큰의 전체 목록이고, 각 토큰은 고유 번호인 토큰 ID를 받습니다. 일련번호가 붙은 사전을 떠올리면 됩니다. 앞의 작은 예제에서는 h=0, u=1, g=2, p=3, s=4, ug=5, hug=6, pug=7입니다. 따라서 "pugs"는 토큰 pug, s를 거쳐 토큰 ID [7, 4]가 되고, 이것이 LLM에 들어갑니다. 흐름은 텍스트 → 토큰 → 토큰 ID입니다.
어휘 크기는 모델에 영향을 줍니다. LLM은 매 단계 이 어휘에서 토큰 하나를 고르므로(2.12 참조) 어휘가 100,000개면 매 단계 10만 개 선택지가 있습니다. 어휘가 크면 문장당 토큰은 줄지만 모델이 무거워지고, 작으면 모델은 가벼워지지만 시퀀스가 길어집니다. 실제 모델은 용도에 따라 중간 어딘가를 고릅니다. 모델 안에서는 각 토큰 ID가 긴 숫자 목록인 임베딩을 찾는 데 쓰이며(2.6 참조), 진짜 이해는 거기서 시작되고 토큰화는 그 앞 단계입니다.
디코딩(decoding)은 반대 방향입니다. LLM은 텍스트가 아니라 토큰 ID를 한 번에 하나씩 냅니다. 모델이 6, 4를 내면 토크나이저가 어휘를 역으로 찾아 hug, s를 얻고 이어 붙여 "hugs"를 만듭니다. 흐름은 토큰 ID → 토큰 → 텍스트입니다. 답이 화면에 타이핑될 때 가끔 단어의 절반이 먼저 나타나고 나머지가 뒤에 나타나는 이유가 토큰 경계입니다. 모델이 토큰 하나를 만들고, 토크나이저가 디코딩해서, 화면에 보여 주기 때문입니다(2.15 참조).
영상 강의는 같은 흐름을 "Kim teaches" 같은 짧은 예문으로 보여 주며 몇 가지를 덧붙입니다.
- 문장을 서브워드로 쪼갠 뒤 각 조각에 고유 번호를 붙이며,
tiktoken같은 토크나이저 라이브러리가 데이터셋을 훑어 어휘를 만들고 텍스트→ID, ID→텍스트 매핑 파일을 함께 둡니다. 번호는 설명용이고 한 번 정해지면 같은 조각은 늘 같은 번호입니다. - 모델에 넣는 것도 숫자이고 모델이 내는 것도 숫자(예: 26)입니다. 그 숫자를 같은 라이브러리에 되물어 텍스트(예: "AI")를 얻고, 그 결과 "Kim teaches AI" 같은 문장이 완성됩니다.
- 라이브러리 추상화 없이 직접 구현하는 예에서는 문장 끝 마침표를 먼저 단어와 분리하는 보조 함수를 둡니다. 데이터셋의 고유 단어를 모아 어휘를 만들고(영상 예제는 70개 단어와 ID의 매핑), 텍스트→토큰 ID 함수와 토큰 ID→텍스트 함수 두 개로 문장을 왕복시킵니다. 원리를 보기 위한 단순화입니다.
코드로 확인하면 다음과 같습니다. OpenAI의 라이브러리 tiktoken에서 약 10만 토큰의 어휘를 가진 cl100k_base 토크나이저를 불러옵니다.
import tiktoken
encoding = tiktoken.get_encoding("cl100k_base")
token_ids = encoding.encode("I love learning")   # [40, 3021, 6975]
text = encoding.decode(token_ids) # "I love learning"encode는 텍스트를 토큰 ID로, decode는 토큰 ID를 텍스트로 바꾸며, 같은 문장이 그대로 돌아옵니다. 각 ID를 개별 디코딩하면 [I], [ love], [ learning]이 나와 공백이 단어에 붙어 있음이 확인됩니다. 정확한 ID는 토크나이저마다 다르므로, 고객 데이터의 비용을 추정할 때는 실제 쓸 모델의 토크나이저로 직접 세어 봅니다.
2.4.4 특수 토큰(Special Tokens)
어휘에는 텍스트에서 나온 토큰 말고도 특수 토큰(special tokens)이 있습니다. 단어가 아니라 신호입니다.
| 특수 토큰 | 역할 | 표기 예 |
|---|---|---|
| 텍스트 끝 | 텍스트가 끝났음을 알림. 모델이 이 토큰을 내면 생성을 멈춤(2.13 참조) | <|endoftext|>, <eos> |
| 텍스트 시작 | 텍스트가 시작되는 지점 표시 | <bos> |
| 패딩 | 여러 입력을 함께 처리할 때 길이를 맞추는 채움 토큰 | (모델별) |
| 챗 표지 | 사용자 메시지의 시작·끝과 어시스턴트 답의 시작을 표시. 챗 모델이 누가 말했는지 아는 방법 | (모델별) |
특수 토큰은 일반 텍스트를 쪼개서는 나오지 않고, 토크나이저나 모델을 감싼 시스템이 일부러 넣습니다. 따라서 사용자 입력이 특수 토큰과 같은 문자열을 포함할 때 시스템이 어떻게 처리하는지는 구현 주의 사항입니다. 모델이 정지 토큰을 내지 않아 계속 쓰는 현상은 2.13에 따로 있는 주제입니다. 현장에서는 챗 표지가 모델마다 다르다는 점 때문에 프롬프트 템플릿을 다른 모델로 옮길 때 형식을 맞추는지 확인합니다.
2.4.5 토큰화가 LLM에 미치는 실무 영향
토큰화는 모델 앞에서 일어나고 모델은 토큰 내부를 들여다볼 수 없습니다. 이 한 가지 사실이 LLM의 여러 기이한 행동을 설명합니다.
- 글자 세기: "strawberry"에 "r"이 몇 번 나오느냐고 물으면 토크나이저가
"str","aw","berry"처럼 쪼개고, 모델은 토큰 ID 3개만 보고 개별 글자를 보지 못합니다. 조각 안의 "r" 개수를 기억으로 추측해야 해서 가끔 틀립니다. - 숫자 계산: "12345"는
"123","45"처럼 쪼개져 모델은 다섯 자리가 아니라 토큰 2개를 봅니다. 이런 조각으로 하는 덧셈은 자릿수별 덧셈보다 훨씬 어렵습니다. - 비용과 한도: LLM이 한 번에 읽을 수 있는 토큰 수에는 한도가 있고 이것이 컨텍스트 윈도우입니다(2.16 참조). 가격도 토큰당으로 매겨지므로 토큰 수가 무엇이 들어가는지와 얼마가 드는지를 모두 정합니다.
- 다른 언어: 대부분의 토크나이저는 영어 중심 텍스트로 학습되어 영어 단어는 조각이 크고 간결합니다. 힌디어, 타밀어, 일본어 문장은 훨씬 많은 잔 조각으로 쪼개져 같은 문장이 몇 배의 토큰을 쓸 수 있고, 그만큼 비용이 늘고 컨텍스트 윈도우가 빨리 찹니다. 한국어 문서도 이 기준으로 가늠합니다.
- 코드: 공백과 들여쓰기도 토큰입니다. 네 칸 들여쓰기가 토크나이저에 따라 토큰 1개 또는 4개가 될 수 있어, 모델이 코드를 읽고 쓰는 능력에 영향을 줍니다.
잘 되는 곳은 이렇습니다. 미지 단어 문제 없이 모든 입력을 처리하고, 흔한 텍스트에서 시퀀스를 짧게 유지하며, 관련 단어가 의미 있는 조각을 공유해 학습이 빠르고, 하나의 어휘로 텍스트, 코드, 여러 언어를 다룹니다. 실패하는 곳은 다음과 같습니다.
- 글자 세기나 단어 뒤집기처럼 개별 글자가 필요한 과제
- 숫자가 부자연스럽게 묶이는 긴 숫자 연산
- 학습 텍스트에서 비중이 낮은 언어, 곧 토큰이 더 많아 비용이 높고 컨텍스트 여유가 줄어드는 경우
- 이상한 지점에서 쪼개진 단어, 곧 조각이 기대한 의미를 담지 못해 모델이 혼동하는 경우
FAQ도 같은 사실로 정리됩니다. 모든 LLM이 같은 토크나이저를 쓰지는 않고, 학습 중에 토크나이저가 바뀌지도 않으며, 영어 100 토큰은 약 75 단어입니다. 고객이 한국어 중심 서비스를 설계한다면 영어 예산표를 그대로 쓰지 말고 실제 문서 샘플로 토큰 수를 세어 비용과 윈도우 여유를 먼저 계산하자고 제안합니다.
2.5 바이트 쌍 인코딩(BPE)
원문: What is Byte Pair Encoding (BPE) in LLMs?
2.4가 서브워드 방식의 필요성과 BPE의 윤곽을 보였다면, 이 절은 BPE 알고리즘 하나를 병합 규칙의 순서까지 단계별로 따라갑니다. 토크나이저가 같은 텍스트를 매번 같은 조각으로 자르는 이유가 이 규칙 순서에 있습니다. 아래 설명은 2026년 3월에 게시된 글을 기준으로 합니다.
2.5.1 가장 빈번한 쌍 찾기와 병합 반복
BPE(Byte Pair Encoding)는 문자와 단어 사이 어딘가의 크기로 텍스트를 쪼개는 토큰화 알고리즘이며, 인접한 토큰 쌍(pair) 중 가장 흔한 것을 찾아 하나로 합치는 일을 반복합니다. 개별 문자에서 출발해 흔한 쌍을 계속 합쳐 흔한 조각의 어휘를 쌓고, 그 조각을 서브워드라 합니다. 서브워드는 "the" 같은 완전한 단어, "ing", "un", "tion" 같은 단어의 일부, 또는 한 글자일 수 있습니다. 속기를 배우는 일에 비유할 수 있습니다. 처음에는 글자를 전부 쓰지만 "ing"나 "tion"이 자주 나오는 것을 알아채면 줄임 표기를 만들게 되고, BPE는 이 일을 자동으로 합니다.
두 극단이 왜 부족한지부터 확인합니다. 텍스트를 초콜릿 바에 비유하면 전체 문장이 바이고 떼어낸 한 조각이 토큰입니다. 어디서 얼마나 큰 조각으로 자를지가 쟁점입니다.
- 단어 단위: "I love teaching"이
"I","love","teaching"이 됩니다. 쉬워 보이지만 모델이 언어의 모든 단어를 알아야 합니다. 영어만 수십만 단어에 이름, 전문 용어, 다른 언어 단어, 오타, 매일 생기는 신조어가 있습니다. "ChatGPT"나 "tokenization" 같은 처음 보는 단어는 통째로 하나의 "미지" 토큰이 되어 의미를 잃습니다. - 문자 단위: "I love"는
"I"," ","l","o","v","e"입니다. 모든 단어가 문자로 이뤄지고 고유 문자 수가 단어 수보다 훨씬 적어 미지 단어가 없습니다(영어는 알파벳 26자, 숫자·문장부호·공백을 더해도 작음). 하지만 토큰이 너무 작아서 10 단어 문장이 50 토큰 이상이 될 수 있고, 학습이 아주 느려지며, 문자l하나는 의미가 거의 없어 모델이 의미를 파악하기 어렵습니다.
BPE는 이 둘의 중간입니다. 아래 예제를 따라갑니다. 어휘를 만들 텍스트의 단어 빈도는 "low" 5번, "lower" 2번, "newest" 6번, "widest" 3번입니다.
Step 1, 문자에서 시작합니다. 모든 단어를 개별 문자로 쪼개고 단어의 끝을 알 수 있도록 끝 기호 _를 붙입니다.
| 단어 | 쪼갠 모양 | 빈도 |
|---|---|---|
| low | l o w _ |
5 |
| lower | l o w e r _ |
2 |
| newest | n e w e s t _ |
6 |
| widest | w i d e s t _ |
3 |
초기 어휘는 개별 문자 {l, o, w, e, r, n, s, t, i, d, _}입니다.
Step 2, 가장 빈번한 쌍을 찾습니다. 전체 텍스트에서 인접 쌍의 빈도를 셉니다.
e s는 newest(6)와 widest(3)에서 나와 9번입니다.s t도 newest(6)+widest(3)=9번,t _도 9번입니다.l o는 low(5)+lower(2)=7번,o w도 7번입니다.
세 쌍이 9번으로 동률인데(python3 -I로 전체 쌍을 세어 확인했습니다), 정해진 규칙으로 하나를 고르고 여기서는 e s를 합쳐 토큰 es를 만듭니다.
Step 3, 합치고 갱신합니다. e와 s가 함께 나온 곳이 모두 es로 바뀝니다. 이제 n e w es t _(6), w i d es t _(3)이며 low와 lower는 그대로입니다. 어휘는 {..., es}로 하나 늘어납니다.
Step 4, 반복합니다. 다음 최다 쌍은 es t로 9번(newest 6 + widest 3)이고 est로 합칩니다. 그다음 est _가 est_로, 그다음 l o가 lo로, lo w가 low로 합쳐집니다. 이 순서는 시뮬레이션으로 재확인했습니다. 병합할 때마다 어휘는 하나 늘고 텍스트는 더 적고 더 큰 조각으로 표현됩니다.
flowchart LR
  A["문자로 분해<br/>l o w e s t _"] --> B["쌍 빈도 세기"]
  B --> C["최다 쌍 병합<br/>e s -> es"]
  C --> D{"어휘가 목표 크기?"}
  D -- 아니오 --> B
  D -- 예 --> E["어휘 + 순서 있는 병합 규칙"]
그림 2.5.1 — BPE 학습은 쌍 세기와 병합을 목표 어휘 크기까지 반복합니다.
Step 5, 멈춥니다. 미리 정한 어휘 크기(vocabulary size)에 이를 때까지 병합합니다. 현대 LLM은 보통 32,000~256,000 토큰을 쓰며, 2026년 3월 글 기준으로 LLaMA 3는 약 128K, Gemma는 약 256K입니다. 최종 어휘는 "the", "is", "and" 같은 흔한 단어, "ing", "tion", "est", "un" 같은 흔한 서브워드, 드문 조합을 위한 개별 문자가 섞입니다. 고객 도메인(의료, 법률, 코드 등)의 용어가 어휘에 없으면 잘게 쪼개져 비용이 오르므로, 핵심 용어 몇 개로 토큰 수를 미리 재 보는 것이 판단 근거가 됩니다.
2.5.2 학습된 병합 규칙으로 새 텍스트 토큰화
학습이 끝난 BPE에는 어휘와 순서가 있는 병합 규칙 목록이 남습니다. 순서가 중요한 이유는 학습 중 e s → es, es t → est, l o → lo 같은 특정 순서로 병합을 익혔기 때문이며, 이 순서가 그대로 저장됩니다. 새 텍스트를 토큰화할 때 단순히 어휘에서 서브워드를 찾지 않고 학습 때 배운 순서 그대로 병합 규칙을 다시 적용합니다.
"lowest"를 예로 듭니다.
| 단계 | 적용한 규칙 | 결과 |
|---|---|---|
| 시작 | 문자로 분해 | l o w e s t |
| 규칙 1 | e s → es |
l o w es t |
| 규칙 2 | es t → est |
l o w est |
| 규칙 3 | l o → lo |
lo w est |
| 규칙 4 | lo w → low |
low est |
결과는 ["low", "est"]입니다. 위 표는 설명을 위해 단어 끝 기호 없이 est _ → est_ 규칙(실제 학습에서는 es t 다음에 오는 규칙)을 건너뛴 흐름이며, 끝 기호까지 붙여 전체 규칙을 돌리면 low, est_가 됩니다. "newer"는 n e w e r에서 시작해 맞는 규칙이 순서대로 하나씩 적용되고, 원문은 결과를 ["new", "er"]로 제시합니다. 이 결과는 ne, new, er 같은 뒤쪽 병합 규칙이 어휘에 있어야 성립하므로, 이 작은 예제의 앞 몇 개 규칙만으로는 재현되지 않고 규칙이 충분히 학습된 경우의 예상 결과로 읽어야 합니다. 드문 단어 "widestness"는 w i d e s t n e s s에서 시작해 es, est 같은 흔한 병합이 맞는 곳에서 일어나고 나머지는 작은 조각으로 남아 어휘의 알려진 서브워드로 분해됩니다.
순서가 중요한 이유는 병합 순서가 달라지면 결과가 달라지기 때문입니다. 어휘에서 가장 긴 일치 서브워드를 찾는 탐욕적 조회를 쓰면 모델이 기대하는 것과 다른 토큰화가 나올 수 있습니다. 학습 순서 그대로 규칙을 재생해야 매번 일관되고 올바른 토큰화가 나옵니다. 이는 FAQ의 "탐욕적 최장 일치 조회를 쓰는가"에 대한 답이 아니오인 이유입니다.
BPE는 완전히 모르는 단어를 만나지 않습니다. 본 적 없는 단어도 병합 규칙으로 더 작은 조각으로 분해할 수 있고, 최악의 경우 개별 문자로 되돌아가지만 흔한 언어에서는 드뭅니다. 따라서 어떤 단어도 토큰화에 실패하지 않습니다. 고객이 두 모델의 토큰 수가 다르다고 문의하면 두 모델의 병합 규칙과 어휘가 다르다는 점으로 설명합니다.
2.5.3 현대 LLM이 BPE를 쓰는 이유
BPE는 대부분의 현대 LLM이 쓰는 토큰화 알고리즘이고 이유는 네 가지입니다.
- 미지 단어 처리: 본 적 없는 단어도 아는 서브워드 조각으로 쪼개 토큰화하므로 완전히 "미지"인 단어가 없습니다.
- 효율적인 어휘 크기: 가능한 모든 단어를 담으려면 수백만 항목이 필요하지만 BPE는 32,000~256,000 토큰의 간결한 어휘로 어떤 텍스트든 표현합니다.
- 의미와 효율의 균형: "the", "is" 같은 흔한 단어는 단일 토큰이라 처리가 빠르고 의미가 분명하며, 드문 단어는 서브워드로 쪼개져 이해 가능하고 관리 가능합니다.
- 다국어 호환: 문자 수준에서 작동하므로 어떤 언어, 문자 체계, 특수 문자도 다루며 영어, 중국어, 아랍어, 코드에 알고리즘 변경 없이 같은 방식이 적용됩니다.
모델들은 BPE의 변형을 쓰지만 핵심 아이디어는 같습니다. BPE 또는 그 변형이 현대 LLM이 텍스트를 읽고 처리하는 방식의 중심에 있습니다. 텍스트가 토큰으로 나뉘면 트랜스포머가 이어받으며, 토큰을 처리하는 두 블록이 인코더와 디코더입니다(2.8 참조). 단어 단위보다 BPE가 나은 이유는 미지 단어가 사라지기 때문이고, 문자 단위가 아닌 이유는 토큰이 너무 작아 학습이 느리고 의미 파악이 어려워지기 때문이며, 어휘 크기는 32,000~256,000에서 병합이 목표에 닿을 때까지 정해집니다. 고객 현장에서는 "어휘가 영어 중심인가, 한국어와 도메인 용어까지 잘 덮는가"를 같은 문서로 토큰 수를 세어 비교해 모델을 고릅니다.
2.6 임베딩(Embedding)
원문: What are Embeddings?
영상: Embeddings in Machine Learning
검색, 추천, RAG, 챗봇이 "비슷한 의미"를 찾는 방법은 모두 임베딩 하나에서 나옵니다. 이 절은 컴퓨터가 의미를 비교하지 못하는 문제에서 출발해, 숫자 목록이 의미를 대신하는 원리와 그것을 쓸 때의 함정을 다룹니다. 아래 설명은 2026년 7월에 게시된 글을 기준으로 합니다.
2.6.1 의미를 비교할 수 없는 컴퓨터의 문제
컴퓨터는 숫자 비교에 뛰어납니다. 5가 3보다 큰지는 즉시 답합니다. 그러나 단어가 무슨 뜻인지는 모르고, 컴퓨터에게 단어는 글자의 집합일 뿐입니다. 두 쌍의 문장으로 문제를 확인합니다.
| 쌍 | 문장 | 사람의 판단 | 글자만 비교하는 컴퓨터의 판단 |
|---|---|---|---|
| A, B | "How do I reset my password?" / "I forgot my login details." | 같은 요청 | 공유하는 핵심 단어(reset, password, forgot, login)가 하나도 없어 무관 |
| C, D | "The bank of the river was muddy." / "I need to visit the bank today." | 하나는 강둑, 하나는 은행으로 전혀 다름 | "bank"를 공유하니 관련 있음 |
컴퓨터는 두 경우 모두 거꾸로 판단했습니다. 글자가 일치하는 것과 의미를 이해하는 것은 다르며, 컴퓨터가 잘하는 형태인 숫자로 의미를 건네줄 방법이 필요합니다. 그 해법이 임베딩입니다. 고객의 FAQ 검색이 키워드 일치로만 동작해 "비밀번호 재설정"과 "로그인 정보를 잊었어요"를 따로 취급한다면 바로 이 문제 때문이며, 임베딩 기반 검색 도입의 근거가 됩니다(5.3 참조).
2.6.2 두 숫자 예제와 고차원으로의 확장
임베딩(embedding)은 무언가의 의미를 나타내는 숫자 목록이며, 비슷한 의미끼리 비슷한 숫자를 갖도록 배열된 것입니다. 의미를 숫자로 옮긴 것이라 할 수 있습니다. embed는 "무언가 안에 놓다"라는 뜻으로, 단어, 문장, 그림을 숫자로 된 공간 안에 놓으면 위치가 생기고, 위치가 생기면 어느 것이 가까운지 물을 수 있습니다. 숫자 목록의 이름이 벡터(vector)이므로 "이 문장의 벡터"와 "이 문장의 임베딩"은 같은 말입니다(1.4.4 참조). 예를 들어 "How do I reset my password?"는 [0.21, -0.48, 0.83, 0.02, ...], "I forgot my login details."는 [0.19, -0.44, 0.79, 0.05, ...], "The bank of the river."는 [-0.71, 0.33, -0.12, 0.66, ...]처럼 나옵니다. 앞의 둘은 의미가 거의 같아 숫자가 가깝고, 셋째는 완전히 다릅니다. 컴퓨터는 영어를 이해할 필요 없이 두 숫자 목록이 비슷하다는 것만 알아채면 됩니다.
실제 임베딩은 수백 개 숫자를 쓰므로 그림으로 그릴 수 없어 두 숫자로 시작합니다. 과일을 단맛(0~10)과 크기(0~10) 두 점수로 놓습니다.
| 과일 | 단맛 | 크기 | 임베딩 | 사과 [7, 5]와의 거리 |
|---|---|---|---|---|
| 사과 | 7 | 5 | [7, 5] |
0 |
| 바나나 | 8 | 5 | [8, 5] |
1.00 |
| 레몬 | 1 | 3 | [1, 3] |
6.32 |
| 수박 | 6 | 10 | [6, 10] |
5.10 |
거리는 python3 -I로 재계산한 값입니다. 컴퓨터에 사과와 바나나가 비슷한 과일이라고 알려 준 적이 없지만, 숫자 네 쌍만으로 사과와 바나나는 서로 옆에 놓이고 레몬은 먼 구석에 놓입니다. "사과와 가장 비슷한 과일은?"이라는 질문에 컴퓨터는 과일에 대해 아무것도 몰라도 [7, 5]에 가장 가까운 점을 찾아 바나나를 답합니다. 의미가 위치가 되었고 위치는 잴 수 있기 때문입니다.
quadrantChart
  title 과일 임베딩 (단맛, 크기)
  x-axis 덜 달다 --> 더 달다
  y-axis 작다 --> 크다
  quadrant-1 크고 단 것
  quadrant-2 크고 덜 단 것
  quadrant-3 작고 덜 단 것
  quadrant-4 작고 단 것
  Apple: [0.7, 0.5]
  Banana: [0.8, 0.5]
  Lemon: [0.1, 0.3]
  Watermelon: [0.6, 1]
그림 2.6.2 — 두 숫자만으로 사과와 바나나는 가깝고 레몬은 멉니다.
두 숫자의 한계도 분명합니다. 단맛과 크기만으로는 레몬과 라임이 거의 같은 점수라 겹쳐 놓이고 구분할 수 없습니다. 색에 대한 숫자를 주지 않았기 때문입니다. 언어는 과일보다 훨씬 풍부해서, 사물인가 행동인가, 격식인가 구어인가, 긍정인가 부정인가, 사람·돈·자연·시간 중 무엇에 관한 것인가를 한 단어가 한꺼번에 담습니다. 그래서 오늘날 문장 임베딩은 대략 384~3072개의 숫자를 가지며(2026년 7월 글 기준), 각각을 차원(dimension)이라 합니다. 2차원은 종이, 3차원은 방, 768차원은 상상할 수 없고 그래도 괜찮습니다. 과일 그림에서 이해한 것(비슷하면 가깝고 다르면 멉니다)과 거리를 재는 수학은 숫자가 몇 개든 똑같이 적용됩니다.
영상 강의는 같은 원리를 개와 금붕어로 설명합니다. 개는 친근함이 높고 크기가 중간이며 에너지가 높고, 금붕어는 모두 낮거나 작습니다. 속성이 친근함 하나면 1차원 직선에 개, 고양이, 금붕어를 놓고, 친근함과 크기 둘이면 2차원 평면, 크기·친근함·에너지 셋이면 3차원 공간입니다. 영상 정의는 "객체(텍스트, 이미지, 오디오)를 그 속성과 관계에 따라 벡터로 나타낸 표현"입니다. 영상은 또 실제 임베딩이 1D~3D가 아니라 수백~수천 차원임을 상기시키고, 개와 강아지, 고양이와 새끼 고양이처럼 관련 있는 것이 가깝게 놓이고 개와 금붕어는 멀리 놓인다는 점에서 임베딩이 비슷한 객체 찾기를 돕는다고 설명합니다.
이 과일 예제에서는 우리가 단맛과 크기라고 숫자의 의미를 직접 골랐지만, 실제 임베딩에서는 아무도 고르지 않습니다. 숫자는 많은 예시로 패턴을 학습한 프로그램인 모델에서 나오며, 숫자 하나하나는 우리가 이름 붙일 수 있는 무엇을 뜻하지 않습니다. 42번째 차원이 "격식"이 아니며 의미는 모든 차원에 걸쳐 퍼져 있습니다. 따라서 고객이 "이 차원이 무엇을 뜻하느냐"고 물으면 개별 차원은 해석 대상이 아니라고 답합니다.
2.6.3 근접도 측정
"가깝다"를 재는 가장 직관적인 방법은 과일 그림에서 자로 재듯 두 점 사이의 평범한 거리를 구하는 것입니다. 사과 [7, 5]와 바나나 [8, 5]는 1 단위 떨어져 있고 사과와 레몬은 훨씬 멉니다. 하지만 실무에서 더 흔한 방법은 코사인 유사도(cosine similarity)입니다(2.7 참조). 각 임베딩을 점이 아니라 중심에서 뻗은 화살표로 보고, 화살표의 길이는 무시한 채 두 화살표 사이의 각도만 잽니다.
| 두 화살표의 관계 | 의미 | 점수 |
|---|---|---|
| 각도가 작음 | 의미가 아주 비슷함 | 1에 가까움 |
| 직각 | 무관함 | 0에 가까움 |
| 반대 방향 | 반대 의미 | -1에 가까움 |
점수는 -1과 1 사이의 숫자 하나입니다. 평범한 거리 대신 각도를 선호하는 이유는 화살표 길이가 우리가 신경 쓰지 않는 것, 예컨대 텍스트가 얼마나 긴지를 반영하는 경우가 많기 때문입니다. 같은 주제에 대한 두 줄짜리 답과 두 쪽짜리 답은 비슷하다고 쳐야 하는데, 길이를 무시하고 방향만 남기면 그렇게 됩니다.
실제 사용에서는 점수가 -1 근처로 가는 경우가 드뭅니다. 2026년 7월 글 기준으로 대부분의 현대 텍스트 모델에서 무관한 문장도 0.1~0.3 정도, 관련 있는 문장은 0.7~0.9 정도입니다. 따라서 0이 무관을 뜻할 것이라 기대하면 안 되고, 중요한 것은 점수 하나의 값이 아니라 점수끼리의 상대 비교입니다. 같은 이유로 코사인 유사도 0.3이 "관련 있음"을 뜻하느냐는 질문에는 대개 아니라고 답합니다. 검색 시스템이 질문에 가장 잘 맞는 문서를 찾는 일은 질문을 임베딩으로 바꾸고 저장된 임베딩 중 코사인 유사도가 가장 높은 것을 찾는 것이 전부입니다. 고객이 유사도 임곗값을 하나의 숫자로 정해 달라고 하면 실제 질문-문서 쌍으로 분포를 먼저 보고 정하자고 제안합니다.
2.6.4 임베딩의 출처: 학습
숫자는 누가 정할까요. 손으로 쓰지 않고 임베딩 모델(embedding model)이라는 학습된 모델이 만듭니다. 텍스트를 넘기면 숫자 목록이 돌아오고, 이런 모델이 많이 있어 우리는 하나를 골라 씁니다. 영상 강의의 예로 텍스트에는 word2vec, 이미지에는 ResNet이 있으며 용도마다 다른 모델이 있습니다. 모델은 방대한 데이터로 학습해 만들어집니다.
모델은 방대한 텍스트를 읽으며 하나의 패턴에서 배웁니다. 비슷한 상황에 나타나는 단어는 비슷한 뜻을 가지는 경향이 있다는 것입니다. 이 아이디어는 언어학자 J. R. Firth가 1957년에 "단어는 함께 다니는 단어들로 알 수 있다(You shall know a word by the company it keeps)"라고 표현했습니다. 예문으로 보면 다음 네 문장이 있습니다.
- "I drank a cup of tea in the morning."
- "I drank a cup of coffee in the morning."
- "She poured the tea into a cup."
- "She poured the coffee into a cup."
"tea"와 "coffee"는 같은 종류의 문장 안에서 같은 종류의 단어에 둘러싸여 나옵니다. 마시고, 따르고, 컵에 담기고, 아침에 일어나는 일입니다. 모델이 수백만 문장에서 이 현상을 수백만 번 보면 두 단어를 숫자 공간에서 가깝게 놓습니다. 둘 다 뜨거운 음료라고 알려 준 적이 없는데 오로지 함께 다니는 단어로 알아냈습니다. 반대로 "bicycle"은 그런 환경에 거의 나오지 않아 멀리 놓입니다. 이렇게 기계가 아무도 단어를 설명해 주지 않았는데도 의미 이해처럼 동작하는 것을 만듭니다. 유사한 것을 끌어당기고 다른 것을 밀어내는 학습 방식은 대조 학습(contrastive learning)이라 부릅니다. 고객 도메인 용어가 학습 텍스트에 거의 없다면 모델이 좋은 위치를 주지 못하며, 2.6.7의 "시점이 고정되어 있다"가 이 경우입니다.
2.6.5 단어 산술(king-queen) 예제
단어가 공간의 위치이면 위치끼리 산술을 할 수 있고, 놀라운 결과가 나옵니다. king - man + woman은 queen에 아주 가까운 곳에 도착합니다. "king"의 위치에서 "man"의 위치를 빼면 남성 부분이 빠지고, "woman"의 위치를 더하면 여성 부분이 더해져 가장 가까운 단어가 "queen"입니다. 비슷한 패턴은 곳곳에 나타납니다. Paris - France + Italy는 Rome 근처에 닿습니다. France를 빼면 나라가 제거되어 "~의 수도"에 가까운 무언가가 남고, Italy를 더하면 그것이 이탈리아에 적용되어 Rome 근처에 도달합니다.
아무도 모델에 성별이나 수도라는 개념을 프로그래밍하지 않았습니다. 이 관계는 사람들이 글을 쓰는 방식에 이미 존재하기 때문에 저절로 나타났습니다. 이 사례가 보여 주는 것은 숫자 안에 숨은 구조의 풍부함이며, 2.2.2에서 본 king, queen, apple의 숫자가 보여 준 직관과 같은 맥락입니다. 이 예제는 데모이므로, 실제 서비스에서 이런 산술이 항상 성립한다고 가정하지는 않습니다.
2.6.6 텍스트 밖의 임베딩과 활용처
아이디어는 단어에 한정되지 않습니다. 어떤 것이든 비슷한 것끼리 가깝게 놓이도록 숫자로 바꾸는 모델을 학습시킬 수 있다면 임베딩할 수 있습니다.
- 단어와 문장: 지금까지 다룬 경우입니다.
- 문서 전체: 한 쪽을 숫자 목록 하나로 만들어 비슷한 쪽을 찾습니다.
- 이미지: 사진이 숫자 목록이 되어 개 사진 둘은 가깝고 자동차 사진은 멉니다(5.11 참조).
- 오디오: 같은 노래의 두 녹음이나 같은 억양의 두 목소리가 가깝습니다.
- 상품과 사용자: 쇼핑몰이 상품과 구매자를 함께 임베딩해 구매자 가까이의 상품을 추천합니다.
영리한 점이 하나 더 있습니다. 일부 모델은 서로 다른 종류를 같은 공간에 둡니다. 고양이 사진과 "a cat sitting on a chair"라는 문장이 같은 이웃에 놓일 수 있어서, 사진에 라벨이나 태그가 전혀 없어도 문장을 입력해 사진 모음을 검색할 수 있습니다(3.4 참조).
활용처는 다음과 같습니다.
- 시맨틱 검색: 가장 큰 활용이며 단어 대신 의미를 매칭합니다. "reset my password"와 "forgot my login details"를 같은 요청으로 인식해 처음 문제를 해결합니다(5.3 참조).
- RAG: 문서를 임베딩하고 사용자 질문도 임베딩해 가장 가까운 조각을 질문과 함께 AI에 넘깁니다. 전체가 임베딩 위에 서 있습니다.
- 추천: "다른 사람들도 좋아했습니다"는 임베딩 공간에서 최근접 이웃을 찾는 일인 경우가 많습니다(5.2 참조).
- 그룹화: 고객 피드백 1만 건을 모두 임베딩하면 불만이 자연스럽게 군집을 이루며, 미리 읽고 범주를 만들 필요가 없습니다.
- 중복 탐지: 표현이 전혀 다른데 같은 버그를 신고한 두 지원 티켓이 가깝게 놓입니다.
- 분류: 각 범주의 예시와 가장 가까운 쪽으로 메시지를 분류합니다.
영상 강의는 사용 사례를 더 자세히 듭니다. 문서 유사도는 텍스트 두 개가 개념적으로 얼마나 비슷한지 잽니다. 콘텐츠 기반 추천은 영화의 제목과 설명을 임베딩해 비슷한 항목을 제안합니다. 협업 필터링(collaborative filtering)은 항목에 사용자를 함께 넣는 방식이며, 나는 축구와 크리켓 영상을 보고 당신은 축구만 본다면 시스템이 두 사용자가 비슷하다는 것을 알아 당신에게 크리켓을 추천할 수 있어, 콘텐츠 기반 추천으로는 못 하던 일입니다. 이미지 검색은 시각적으로 비슷한 이미지를 찾고, 얼굴 인식은 얼굴 임베딩을 비교·식별용으로 만듭니다. 벡터 DB는 임베딩을 저장하고 의미 유사도로 조회하며(5.1 참조), LLM도 토큰을 벡터로 바꾸는 데 임베딩을 씁니다.
임베딩이 수백만 개라면 가장 가까운 것을 어떻게 빨리 찾을까요? 전부 확인하면 너무 느리며, 벡터 데이터베이스(vector database)가 임베딩을 저장하고 가까운 것을 빠르게 찾도록 만들어졌습니다. 고객이 "비슷한 문서 찾기" 요구를 말하면 먼저 어떤 대상을 어떤 모델로 임베딩할지, 수가 얼마인지를 묻습니다.
2.6.7 주의할 점
임베딩에는 함정이 있습니다.
- 서로 다른 모델의 임베딩은 비교할 수 없습니다. 가장 흔한 실수입니다. 각 모델은 자기만의 공간과 배열을 가지므로 모델 A의 벡터와 모델 B의 벡터는 서로 다른 언어입니다. 비교하면 멀쩡해 보이지만 의미 없는 숫자가 나옵니다. 임베딩 모델을 바꾸면 저장된 모든 임베딩을 다시 만들어야 합니다.
- 비슷함이 정확함은 아닙니다. 두 문장이 가깝다고 서로의 답이 되지는 않습니다. 임베딩은 같은 주제임을 잡을 뿐 사실을 검증하지 않고 부정을 잡아내지 못합니다. "The medicine is safe"와 "The medicine is not safe"는 같은 주제이고 불편할 만큼 가깝게 놓일 수 있습니다.
- 훈련 텍스트의 편향을 지닙니다. 모델이 사람의 글에서 배웠으므로 그 글에 있는 불공정한 연상이 위치에 그대로 들어갑니다. 채용이나 대출에 쓸 때 특히 중요합니다.
- 시점이 고정되어 있습니다. 임베딩 모델은 학습한 언어만 압니다. 새로 생긴 단어나 회사 내부 용어는 공간에서 좋은 위치를 갖지 못합니다.
- 긴 텍스트는 세부를 잃습니다. 20쪽 문서를 숫자 목록 하나로 짜 넣으면 모든 것이 평균 내어져 흐려집니다. 그래서 긴 문서는 작은 조각으로 잘라 각각 임베딩하고(5.6 참조), 이때 잃은 정밀도는 리랭커로 되찾습니다(5.5 참조).
- 임베딩 없이 문서를 찾는 방법도 있습니다(5.16 참조).
규칙은 간단합니다. 모든 용도에 한 모델을 쓰고, 모델을 바꾸면 전부 다시 만들며, 가깝다고 맞다고 가정하지 않는 것입니다. FAQ의 질문도 이 규칙 안에 있습니다. 임베딩은 벡터와 같은 말이고, 개별 차원은 이름 붙일 수 없으며, 모델을 바꾸면 재임베딩이 필요하고, 부정을 이해하지 못합니다. 고객 현장에서는 모델 교체 비용(전체 재임베딩), 안전·부정 표현이 중요한 도메인의 검증 방법, 긴 문서의 청킹 정책을 도입 전에 확인합니다.
2.7 코사인 유사도(Cosine Similarity)
원문: How does Cosine Similarity work?
임베딩 검색이 "가장 비슷한 것"을 찾을 때 실제로 계산하는 값이 코사인 유사도입니다. 이 절은 벡터와 각도의 직관에서 출발해 공식, 손 계산, 코드, 그리고 거리 대신 각도를 쓰는 이유까지 한 번에 따라갑니다. 아래 설명은 2026년 10월에 게시된 글을 기준으로 합니다.
2.7.1 벡터의 방향과 각도
코사인 유사도(Cosine Similarity)는 두 벡터 사이의 각도를 보고 두 대상이 얼마나 비슷한지 재는 방법입니다. 두 대상이 같은 방향을 가리키는지 다른 방향을 가리키는지를 하나의 숫자로 알려 줍니다. 값은 항상 -1과 1 사이입니다.
1에 가까우면 두 대상이 아주 비슷합니다.0에 가까우면 관련이 없습니다.-1에 가까우면 반대입니다.
숫자로 비교하려면 먼저 각 대상을 벡터(vector), 곧 숫자 목록으로 바꿉니다. 과일을 단맛과 둥근 정도 두 가지 피처로 설명한다면 사과는 [8, 9](단맛 8, 둥근 정도 9), 레몬은 [3, 8](단맛 3, 둥근 정도 8)입니다(1.3 참조). 실제 벡터는 수백, 수천 개의 숫자를 가지지만 이해를 위해 두세 개짜리를 씁니다(2.6 참조).
방향과 각도는 그래프로 이해합니다. 오른쪽으로 가는 축이 단맛, 위로 가는 축이 둥근 정도입니다. 사과 [8, 9]는 원점에서 오른쪽으로 8, 위로 9 이동한 점이고, 원점에서 그 점까지 그은 화살표가 사과의 방향입니다. 레몬 [3, 8]도 오른쪽 3, 위로 8의 화살표입니다. 두 화살표 사이의 벌어진 틈이 각도(angle)입니다.
| 화살표 관계 | 각도 | 해석 |
|---|---|---|
| 거의 같은 방향 | 작음 | 비슷함 |
| 많이 다른 방향 | 큼 | 다름 |
이름이 "각도 유사도"가 아니라 "코사인"인 이유는 각도 자체가 아니라 각도의 코사인(cosine)을 쓰기 때문입니다. 코사인은 각도를 받아 -1과 1 사이의 값을 돌려주는 단순한 수학 함수입니다.
| 각도 | 화살표의 모양 | 코사인 | 뜻 |
|---|---|---|---|
| 0도 | 완전히 같은 방향 | 1 |
가장 비슷함 |
| 90도 | 직각 | 0 |
무관함 |
| 180도 | 정반대 방향 | -1 |
가장 반대임 |
각도가 0도에서 90도, 180도로 커질수록 코사인은 1에서 0, -1로 부드럽게 내려갑니다. 코사인이 각도를 깔끔한 유사도 점수로 바꿔 주는 것입니다. 고객에게 설명할 때는 "두 문서의 방향이 얼마나 같은가를 -1에서 1로 나타낸 값"이라는 한 줄이면 충분합니다.
2.7.2 코사인 유사도 공식과 수치 계산
두 벡터 A, B의 코사인 유사도는 다음과 같습니다.
Cosine Similarity = (A · B) / (‖A‖ × ‖B‖)
공식은 윗부분과 아랫부분으로 나뉩니다.
- 윗부분
A · B는 내적(dot product)입니다. 두 벡터의 대응하는 숫자끼리 곱한 뒤 더합니다.A = [a1, a2],B = [b1, b2]이면A · B = a1×b1 + a2×b2입니다. - 아랫부분
‖A‖ × ‖B‖는 두 벡터의 크기(magnitude)를 곱한 것입니다. 크기는 앞에서 그린 화살표의 길이이며, 모든 숫자를 제곱해 더한 뒤 제곱근을 취해 구합니다.‖A‖ = √(a1² + a2²)입니다.
전체 공식은 내적을 두 길이의 곱으로 나눕니다. 이 나눗셈이 길이의 영향을 지우고 방향만 남깁니다. 이제 A = [8, 9], B = [3, 8]로 단계별로 계산합니다. 모든 값은 python3 -I로 재계산했습니다.
| 단계 | 계산 | 결과 |
|---|---|---|
1. 내적 A · B |
(8×3) + (9×8) = 24 + 72 | 96 |
2. 크기 ‖A‖ |
√(8² + 9²) = √(64 + 81) = √145 | 약 12.04 |
3. 크기 ‖B‖ |
√(3² + 8²) = √(9 + 64) = √73 | 약 8.54 |
| 4. 공식 대입 | 96 / (12.04 × 8.54) = 96 / 102.82 | 약 0.93 |
결과 0.93은 1에 가깝습니다. 사과와 레몬은 둘 다 단맛이 어느 정도 있는 둥근 과일이라 이 예제에서는 상당히 비슷하다고 읽습니다. 반올림을 줄이면 곱 ‖A‖ × ‖B‖는 약 102.88, 결과는 0.93309로, 각도로는 약 21.1도입니다. 반올림된 값 102.82로 나눈 0.9337과 차이가 있지만 둘째 자리에서는 모두 0.93입니다.
같은 계산을 Python으로 쓰면 이렇습니다.
import math

def cosine_similarity(a, b):
    dot_product = sum(x * y for x, y in zip(a, b))
    magnitude_a = math.sqrt(sum(x * x for x in a))
    magnitude_b = math.sqrt(sum(y * y for y in b))
    return dot_product / (magnitude_a * magnitude_b)

print(cosine_similarity([8, 9], [3, 8])) # 0.9330948702273482- 먼저 대응하는 숫자를 곱해 더해
dot_product를 구합니다. - 다음에 모든 숫자를 제곱해 더하고 제곱근을 취해
magnitude_a,magnitude_b를 구합니다. - 마지막으로 내적을 두 크기의 곱으로 나눕니다.
출력 0.9330948702273482는 손으로 계산한 0.93과 같습니다. 벡터가 수천 개의 숫자를 가져도 공식은 그대로이며, 내적은 대응 숫자를 곱해 더하고 크기는 모든 숫자를 제곱해 더한 뒤 제곱근을 취하면 됩니다. 내적만으로는 길이가 큰 벡터가 유리하므로, 코사인 유사도는 그 내적을 두 길이의 곱으로 나눈 값이라는 차이도 기억해 둘 만합니다. 임베딩 검색 라이브러리에서 "cosine"과 "dot product" 옵션이 따로 있는 이유가 이것이므로, 고객 환경의 설정이 모델이 기대하는 방식과 맞는지 확인합니다(5.1 참조).
2.7.3 거리 대신 각도를 쓰는 이유
두 점 사이의 평범한 거리가 아니라 각도를 보는 이유는 길이가 주제와 무관한 경우가 많기 때문입니다. 자동차에 관한 문서 둘을 생각합니다. 문서 A는 짧은 메모로 "car"가 1번, "engine"이 1번 나와 벡터가 [1, 1]입니다. 문서 B는 긴 기사로 "car"가 10번, "engine"이 10번 나와 [10, 10]입니다. 두 문서는 같은 주제를 같은 비율로 말하며 길이만 다릅니다.
[1, 1]과 [10, 10] 사이의 평범한 거리는 약 12.73으로 커서 서로 아주 달라 보입니다. 그러나 이는 틀린 판단입니다. 두 벡터는 정확히 같은 방향을 가리키고 사이의 각도는 0이므로 코사인 유사도는 1, 곧 완전히 비슷합니다. 화살표 A는 짧고 B는 길지만 같은 직선 위에 놓여 있어 끝점 사이의 거리는 크더라도 방향은 동일합니다.
flowchart LR
  O((원점)) -->|A = 1, 1| A[짧은 메모]
  O -->|B = 10, 10| B[긴 기사]
  A -.같은 직선, 각도 0.-> B
그림 2.7.3 — 길이는 달라도 방향이 같으면 코사인 유사도는 1입니다.
그래서 코사인 유사도는 크기를 무시하고 방향만 봅니다. 긴 문서와 짧은 문서가 같은 주제일 수 있는 텍스트에서 특히 잘 맞는 이유입니다(5.3 참조). 같은 성질은 사과 [8, 9]를 두 배한 [16, 18]과 레몬 [3, 8] 사이에서도 확인됩니다. 코사인 유사도는 여전히 0.9331로 변하지 않지만 평범한 거리는 5.10에서 16.40으로 바뀝니다. 고객이 "분량 차이 때문에 검색 순위가 흔들린다"고 하면 거리 기반 지표를 쓰고 있지 않은지가 첫 확인 대상입니다.
활용처는 이렇습니다.
- 검색 엔진: 입력한 것과 맞는 문서를 찾습니다.
- 추천 시스템: 이미 좋아한 영화나 상품과 비슷한 것을 제안합니다.
- 챗봇과 AI 어시스턴트: 질문에 가장 관련 있는 답을 찾습니다.
- 표절 검사: 서로 거의 같은 문서를 찾습니다.
- LLM 앱의 임베딩 검색: 텍스트를 임베딩이라는 벡터로 바꾸고, 어느 텍스트 조각이 의미상 가장 가까운지 코사인 유사도로 찾습니다(2.6 참조).
2.7.4 유클리드 거리와의 비교
벡터를 비교하는 또 다른 인기 방법이 유클리드 거리(Euclidean Distance)입니다. 두 점 사이의 직선 거리로, 화살표 사이의 각도가 아니라 두 화살표 끝이 얼마나 떨어져 있는지를 잽니다. 위 예제에서 A = [8, 9], B = [3, 8]의 유클리드 거리는 약 5.10입니다.
| 항목 | 코사인 유사도 | 유클리드 거리 |
|---|---|---|
| 재는 것 | 두 벡터 사이의 각도 | 두 점 사이의 직선 거리 |
| 크기를 고려하는가 | 아니오, 벡터 길이를 무시 | 예, 길이가 결과에 영향 |
| 값의 범위 | -1 ~ 1 |
0에서 큰 수까지 |
| 값이 클수록 | 더 비슷함 | 더 멀리 떨어짐, 곧 덜 비슷함 |
| 적합한 용도 | 텍스트와 고차원 데이터 | 실제 크기와 거리가 중요할 때 |
둘은 유사도를 다른 방식으로 잽니다. 벡터의 크기가 중요하지 않고 방향만 중요하면 코사인 유사도를, 실제 거리가 중요하면 유클리드 거리를 씁니다. 용도에 따라 고르는 것이며, 벡터 DB에서 코사인, 내적, 유클리드를 비교하는 내용은 5.1 참조입니다.
FAQ의 질문도 이 표에서 풀립니다.
- 음수가 될 수 있는가: 예. 값은 항상 -1과 1 사이이므로 음수가 가능하며, 음수는 두 벡터가 다른 방향이라는 뜻이고 -1은 정반대입니다.
- 0은 무엇을 뜻하는가: 두 대상이 관련이 없다는 뜻이며 두 벡터의 각도가 90도, 곧 직각일 때 생깁니다. 다만 실제 임베딩 모델의 점수 분포는 달라서 0이 곧 무관인 경우는 드뭅니다(2.6.3 참조).
- 내적과의 차이: 내적은 코사인 유사도 공식의 윗부분일 뿐이고, 코사인 유사도는 이를 두 벡터 길이의 곱으로 나눠 길이의 영향을 지우고 방향만 남깁니다.
- 수천 개 숫자의 벡터에도 되는가: 예. 공식은 그대로입니다.
고객 현장에서는 임베딩 모델 문서가 권장하는 유사도 척도(코사인, 내적, 유클리드)를 확인하고 인덱스 설정을 그에 맞춰, 문서 길이가 순위에 영향을 주는지 샘플로 점검합니다.
2.8 트랜스포머(Transformer) 아키텍처
원문: How Does the Transformer Architecture Work?
트랜스포머는 현대 LLM 전부의 바탕 구조이며, 부품 하나하나는 단순하고 복잡함은 부품을 쌓는 방식에서 나옵니다. 이 절은 2026년 4월 글 기준으로 부품을 하나씩 분해해 입력 토큰이 출력 토큰으로 바뀌는 전체 경로를 따라갑니다.
2.8.1 인코더와 디코더 두 반쪽
트랜스포머(Transformer)는 토큰 열을 받아 토큰 열을 내놓는 "토큰 입력, 토큰 출력" 기계입니다. 토큰은 텍스트에서 나오고 다시 텍스트로 돌아가므로 텍스트 입력, 텍스트 출력 기계로 봐도 됩니다. Translate: I love learning을 넣으면 J'adore apprendre가, What is the capital of France?를 넣으면 The capital of France is Paris.가 나옵니다.
이 구조가 필요했던 이유는 이전 모델의 두 가지 약점에 있습니다. 이전 모델은 단어를 왼쪽에서 오른쪽으로 하나씩 순서대로 읽었습니다(2.10.1 참조).
| 문제 | 증상 | 트랜스포머의 해법 |
|---|---|---|
| 망각 | 문장이 길어지면 50번째 단어에 도달했을 때 1번째 단어의 기억이 약해짐 | 모든 토큰이 다른 모든 토큰을 직접 봄 |
| 느림 | 2번째 단어는 1번째 처리가 끝나야 시작할 수 있음 | 모든 입력 토큰을 동시에(병렬로) 처리해 학습 속도 상승 |
2017년 Google 연구진의 논문 "Attention Is All You Need"에서 소개된 원형 트랜스포머는 두 반쪽으로 구성됩니다.
- 인코더(Encoder): 입력을 읽고 이해하는 쪽입니다.
- 디코더(Decoder): 출력을 생성하는 쪽입니다.
독자(인코더)가 문서를 꼼꼼히 읽고 상세한 메모를 만들면, 작가(디코더)가 그 메모를 바탕으로 새 문서를 쓰는 관계와 같습니다. 독자는 이해에, 작가는 생산에 집중합니다.
flowchart LR
  A[입력 텍스트] --> B[토큰화·임베딩·위치 인코딩]
  B --> C[인코더: 읽고 이해]
  C -->|인코더 출력| D[디코더: 한 토큰씩 생성]
  D --> E[출력 텍스트]
그림 2.8.1 — 원형 트랜스포머의 큰 흐름. 인코더의 출력이 디코더로 넘어갑니다.
고객이 "GPT도 트랜스포머입니까"라고 물으면 "예, 그중 디코더 반쪽만 쓰는 변형입니다"라고 정확히 답할 수 있어야 합니다(2.8.6 참조).
2.8.2 위치 인코딩(Positional Encoding)
모델은 단어를 이해하지 못하고 숫자만 다룹니다. 그래서 입력 텍스트는 먼저 두 단계를 거칩니다. 토큰화는 텍스트를 토큰으로 쪼개는 단계이며(원문 설명을 위해 여기서는 토큰 하나를 단어 하나로 가정합니다), I love learning은 I, love, learning 세 토큰이 됩니다(2.4 참조). 임베딩은 각 토큰을 숫자 벡터로 바꾸는 단계로, 단어의 디지털 지문에 해당하며 뜻이 비슷한 단어는 비슷한 지문을 받습니다. happy와 joyful은 가깝고 happy와 car는 멉니다(2.6 참조).
여기에 함정이 하나 있습니다. 인코더는 모든 토큰을 동시에 처리하므로 어느 단어가 첫째이고 둘째인지 알지 못합니다. 순서 정보가 없으면 I love AI와 AI love I가 모델에게 똑같이 보입니다.
- 위치 인코딩(Positional Encoding)은 각 임베딩에 "몇 번째 위치인가"를 나타내는 벡터를 더해 줍니다. 극장의 좌석 번호처럼, 관객이 동시에 입장해도 번호가 각자의 자리를 알려 줍니다.
- 덧셈으로 합쳐지므로 토큰마다 "무슨 뜻인가"와 "문장 어디에 있는가"를 함께 담은 벡터 하나를 갖게 됩니다.
- 첫째 단어와 둘째 단어는 서로 다른 위치 신호를 받습니다.
병렬 처리의 속도 이득은 순서 정보를 잃는 대가를 치르며, 위치 인코딩이 그 손실을 메웁니다. 고객이 "단어 순서를 바꿔도 결과가 같습니까"를 물으면 이 구조 때문에 순서 정보를 따로 주입한다는 점이 답의 출발점입니다.
2.8.3 멀티 헤드 어텐션
어텐션(Attention)은 트랜스포머의 핵심으로, 문장 안의 각 단어가 다른 모든 단어를 보고 얼마나 주목할지 정하는 장치입니다. The cat sat on the mat because it was tired.에서 모델이 it을 처리할 때 고양이를 가리키는지 매트를 가리키는지 가려야 합니다. 어텐션은 cat에 더 큰 비중을, mat에 작은 비중을 주도록 돕습니다.
각 단어는 세 가지로 변환됩니다(2.9.1 참조).
| 요소 | 역할 |
|---|---|
| Query(Q) | 이 단어가 찾고 있는 것 |
| Key(K) | 이 단어가 제공할 수 있는 것 |
| Value(V) | 이 단어가 실제로 지닌 정보 |
계산 순서는 네 단계입니다.
- 각 단어의 Query를 다른 모든 단어의 Key와 내적해 어텐션 점수(두 단어가 얼마나 관련 있는지)를 구합니다.
- 점수를
√dₖ로 나누어 다루기 쉬운 범위로 줄입니다. - 점수에 Softmax를 적용해 합이 1인 확률로 바꿉니다(1.11 참조).
- 그 확률로 Value들을 가중 평균해 섞습니다.
결과적으로 it은 cat의 신호를 강하게 품게 됩니다. 한 문장으로 줄이면, 각 토큰이 다음 층으로 가기 전에 관련 있는 다른 토큰에서 유용한 정보를 빌려 오는 과정입니다. 단계별 수치 계산은 2.9.2 참조.
트랜스포머는 어텐션을 한 번만 돌리지 않고 관점을 달리해 여러 번 병렬로 돌리며, 이를 멀티 헤드 어텐션(Multi-Head Attention)이라 부릅니다. 한 기사를 문법 담당, 사실 확인 담당, 흐름 담당 편집자가 각각 검토하는 것과 같습니다. 헤드마다 다른 종류의 관계(주어-동사 연결, 형용사가 꾸미는 명사 등)에 주목하고, 모든 헤드의 출력을 합쳐 풍부한 이해를 얻습니다.
flowchart TB
  I[입력] --> H1[Head 1]
  I --> H2[Head 2]
  I --> H3[Head 3]
  I --> HN[Head N]
  H1 --> C[결합]
  H2 --> C
  H3 --> C
  HN --> C
  C --> O[출력]
그림 2.8.3 — 모든 헤드가 같은 입력을 병렬로 처리하고 출력을 마지막에 결합합니다.
헤드가 병렬로 도는 것과 층이 순서대로 쌓이는 것은 별개의 개념입니다(2.8.4 참조). 멀티 헤드의 세부 계산은 2.9.4 참조.
2.8.4 피드포워드 네트워크·잔차 연결·층 정규화
어텐션이 단어 사이의 관계를 이해하는 단계라면, 피드포워드 네트워크(Feed-Forward Network)는 각 단어의 표현을 개별적으로 다듬는 정련 단계입니다. 어텐션이 만든 풍부한 표현에서 신호를 선명하게 하고 잡음을 걷어 냅니다. 모든 단어가 같은 네트워크를 각자 독립적으로 통과합니다.
층 안에는 학습을 안정시키는 두 부품이 더 있습니다.
- 잔차 연결(Residual Connection, 스킵 연결): 각 하위 층(어텐션 또는 피드포워드)의 입력을 출력에 그대로 더합니다. 식으로는
output = sub-layer(input) + input입니다. 수업 중 새 내용을 받아 적더라도 원래 필기를 버리지 않고 합쳐 두는 것과 같아서, 데이터가 많은 층을 지나도 중요한 정보를 잃지 않습니다. - 층 정규화(Layer Normalization): 잔차 연결 뒤에 숫자를 안정된 범위로 조정합니다. 층을 거치며 값이 지나치게 커지거나 작아지는 일을 막아 학습을 안정시킵니다.
이 두 부품은 인코더와 디코더의 모든 층에 들어 있습니다.
멀티 헤드 어텐션 하위 층 하나와 피드포워드 하위 층 하나(각각의 잔차 연결과 층 정규화 포함)가 묶여 층(layer) 하나, 곧 트랜스포머 블록이 됩니다. 트랜스포머는 이 블록을 순서대로 여러 개 쌓습니다.
flowchart TB
  A[입력] --> L1["층 1: 멀티 헤드 어텐션 + 피드포워드"]
  L1 --> L2["층 2: 멀티 헤드 어텐션 + 피드포워드"]
  L2 --> D[...]
  D --> LN["층 N: 멀티 헤드 어텐션 + 피드포워드"]
  LN --> O[출력]
그림 2.8.4 — 블록이 직렬로 쌓이며, 앞 층의 출력이 다음 층의 입력이 됩니다.
- 원형 트랜스포머는 인코더와 디코더 각각 6층입니다. GPT-3(1,750억 파라미터)는 96층, 곧 블록 96개가 직렬로 쌓여 있습니다. 각 블록은 자기만의 멀티 헤드 어텐션과 피드포워드를 가집니다.
- 책을 여러 번 읽는 것과 비슷합니다. 첫 번째 읽기는 기본 이해를, 두 번째는 놓친 연결을, 세 번째는 더 깊은 통찰을 줍니다. 층마다 이해가 풍부해집니다.
- 멀티 헤드는 한 어텐션 층 안에서 헤드가 병렬로 도는 것이고, 층 쌓기는 블록이 직렬로 이어지는 것입니다. 둘을 혼동하면 "층이 96개면 헤드도 96개입니까" 같은 질문에서 길을 잃습니다.
고객이 모델 크기를 이야기할 때 "층 수, 헤드 수, 파라미터 수 중 무엇을 말씀하십니까"라고 되물으면 규모에 대한 논의가 정확해집니다.
2.8.5 디코더가 다음 단어를 고르는 방식
먼저 인코더가 하는 일부터 확인합니다. 인코더 층은 두 요소로 구성됩니다. 셀프 어텐션(입력의 모든 단어가 서로를 봄, 2.9 참조)과 피드포워드이며, 둘 다 뒤에 잔차 연결과 층 정규화가 붙습니다. I love learning을 넣으면 첫 번째 층에서 love가 I를 주어로, learning을 목적어로 알아차리기 시작합니다. 두 번째 층에서는 I love learning이 하나의 완결된 생각이라는 결합 의미까지 파악하고, 여섯 번째 층에 이르면 learning이 사전적 뜻이 아니라 "이 문장에서 I가 좋아하는 활동"이라는 문맥 표현을 지닙니다. 이 이해가 디코더로 전달됩니다.
디코더는 출력을 한 토큰씩 생성하며 층마다 세 요소를 가집니다.
- 마스크드 셀프 어텐션(Masked Self-Attention): 각 출력 단어는 이미 생성된 앞 단어만 보고 미래 단어는 보지 못합니다. 생성 시점에 미래 단어가 아직 존재하지 않기 때문입니다.
love는I를 볼 수 있어도 아직 생성되지 않은learning은 볼 수 없으며, 이 제한이 인과 마스킹(causal masking)입니다(2.3.3 참조). - 크로스 어텐션(Cross-Attention): 디코더가 인코더와 연결되는 통로입니다. Query는 디코더에서, Key와 Value는 인코더 출력에서 옵니다. 입력을 이해하는 쪽과 출력을 생성하는 쪽을 잇는 다리가 이것입니다.
- 피드포워드 네트워크: 인코더와 같은 정련 단계입니다.
세 요소 뒤에도 인코더와 마찬가지로 잔차 연결과 층 정규화가 붙습니다.
모든 디코더 층을 통과한 출력은 아직 숫자 벡터이며 단어가 아닙니다. 선형 층(linear layer)이 이를 어휘 전체 단어의 점수로 바꾸고(어휘가 5만 개면 점수도 5만 개), Softmax가 점수를 합이 1인 확률로 바꿉니다. 번역 중 J'까지 생성한 상태라면 다음과 같은 분포가 나옵니다.
| 후보 | 확률 |
|---|---|
| adore | 0.72 |
| aime | 0.15 |
| mange | 0.01 |
| 나머지 약 5만 단어 | 각각 아주 작은 값 |
가장 높은 adore를 고르는 것이 가장 단순한 설명이며(탐욕적 선택), 실무에서는 온도(2.11 참조), Top-k와 Top-p 샘플링(2.12 참조) 같은 전략으로 출력이 얼마나 창의적이거나 집중적일지 조절합니다. 따라서 디코더가 항상 확률 최고의 단어를 고르는 것은 아닙니다.
I love learning을 프랑스어로 옮기는 전체 흐름은 다음과 같습니다.
| 단계 | 하는 일 |
|---|---|
| 인코더 | 토큰화 후 임베딩, 위치 인코딩 추가, 6개 인코더 층 통과 → 문맥을 품은 표현 완성 |
| 첫 단어 | 디코더가 "시작" 토큰으로 출발. 마스크드 셀프 어텐션은 되돌아볼 대상이 없고, 크로스 어텐션이 영어 입력을 참조. 선형 층과 Softmax 후 J' 선택 |
| 둘째 단어 | 입력이 [시작, J']. 마스크드 셀프 어텐션이 둘을 보고, 크로스 어텐션이 인코더 출력을 다시 참조. adore 선택 |
| 셋째 단어 | 입력이 [시작, J', adore]. 앞 세 토큰을 보고 apprendre 선택 |
| 종료 | 디코더가 "끝" 토큰을 생성해 번역 완료를 알림 |
최종 출력은 J'adore apprendre입니다. 고객이 "출력이 왜 한 단어씩 나옵니까"라고 물으면 디코더가 앞서 낸 토큰을 입력으로 되먹이며 하나씩 고르는 구조 때문이라고 답하고, 샘플링 설정이 그 선택을 좌우한다는 점을 함께 설명합니다(2.3.2 참조).
2.8.6 세 가지 변형: encoder-only·decoder-only·encoder-decoder
원형은 인코더와 디코더를 모두 쓰지만 작업에 따라 한쪽만 써도 됩니다.
| 변형 | 대표 모델 | 구성 | 주 용도 |
|---|---|---|---|
| encoder-only | BERT | 인코더만. 읽고 이해하되 새 텍스트는 생성하지 않음 | 스팸 메일 분류, 리뷰 감성 파악, 주어진 글에서 답 찾기 |
| decoder-only | GPT | 디코더만. 한 토큰씩 생성하며 각 토큰은 앞 토큰만 봄 | 텍스트 생성, 질의응답, 코드 작성, 대화. 현대 LLM 대부분이 이 변형 |
| encoder-decoder | T5, 원형 트랜스포머 | 둘 다. 인코더가 이해하고 디코더가 그에 기반해 생성 | 번역, 요약 등 한 텍스트를 다른 텍스트로 변환 |
GPT는 전체 트랜스포머를 쓰지 않고 디코더 반쪽만 씁니다. 디코더 층 안의 크로스 어텐션은 인코더가 있을 때 필요하므로, decoder-only 모델에서는 마스크드 셀프 어텐션과 피드포워드가 중심을 이룹니다.
트랜스포머가 강력한 이유는 네 가지로 나뉩니다.
- 병렬 처리: 인코더는 모든 입력 토큰을 동시에 처리하고, 디코더도 학습 중에는 병렬로 돕니다. 학습이 빨라져 방대한 데이터를 소화할 수 있습니다.
- 장거리 망각 해소: 어텐션으로 모든 단어가 서로 직접 접근하므로 1번째 단어도 1,000번째 단어만큼 접근하기 쉽습니다.
- 확장성: 층, 헤드, 데이터를 늘릴수록 성능이 계속 오릅니다. 그래서 수십억 파라미터 모델이 존재합니다(2.10.3 참조). 파라미터는 학습 중 모델이 배우는 모델 내부의 숫자입니다.
- 다재다능: 번역, 질의응답, 텍스트 생성, 코드 작성, 요약을 같은 설계로 처리합니다.
FDE는 고객 과제의 모양으로 변형을 가립니다. 분류나 검색용 이해 과제는 encoder-only, 대화와 생성은 decoder-only, 입력을 다른 형식으로 바꾸는 과제는 encoder-decoder가 자연스러운 후보이며, 현재 대화형 제품 대부분은 decoder-only 모델 위에 놓여 있다는 점을 전제로 논의를 시작하면 됩니다.
2.9 셀프 어텐션(Self Attention)
원문: What is Self Attention in Transformers and How Does It Work?
셀프 어텐션은 BERT와 GPT 같은 현대 LLM의 심장이며, 문장 안의 모든 단어가 같은 문장의 다른 모든 단어를 보고 자기 뜻을 정하게 하는 장치입니다. 이 절은 2026년 5월 글 기준으로 Q·K·V 계산을 여섯 단계로 따라가고, 세 토큰짜리 예제로 숫자가 어떻게 움직이는지 확인합니다(어텐션의 큰 그림은 2.8.3 참조).
2.9.1 Query·Key·Value 벡터
셀프 어텐션(Self Attention)은 한 열 안의 모든 토큰이 자기 자신을 포함한 같은 열의 모든 토큰을 보고 문맥을 이해하게 하는 메커니즘입니다. 이름 그대로 Self와 Attention의 결합이며, "어텐션"은 각 토큰이 다른 토큰에 얼마나 주목할지 스스로 정한다는 뜻입니다.
왜 필요한지는 두 문장을 비교하면 드러납니다.
| 문장 | it이 가리키는 것 |
단서 |
|---|---|---|
| The animal did not cross the street because it was too tired. | the animal | tired가 주의를 동물 쪽으로 끌어당김 |
| The animal did not cross the street because it was too wide. | the street | wide가 주의를 길 쪽으로 끌어당김 |
구조도 같고 단어 it도 같지만, 단어 하나를 tired에서 wide로 바꾸면 it의 의미가 완전히 달라집니다. 사람은 주변 단어를 살펴 it의 뜻을 정하며, LLM 내부에서도 같은 일이 일어납니다. 모델은 중요한 단어에 더 큰 주의를, 중요하지 않은 단어에 작은 주의를 줍니다. 한 문장이 자기 자신을 향해 주의를 기울이므로 셀프 어텐션이라 부릅니다. 셀프 어텐션이 없으면 it은 실제 의미가 없는 범용 토큰에 그칩니다.
각 토큰은 두 질문에 답해야 합니다. 이 문장에서 나에게 중요한 토큰은 무엇인가, 그리고 각각에 얼마나 집중할 것인가입니다. 이를 위해 토큰마다 벡터 세 개를 만듭니다.
- Query(Q): 이 토큰이 찾고 있는 것입니다.
- Key(K): 이 토큰이 다른 토큰에게 제공하는 것입니다.
- Value(V): 이 토큰이 실제로 지닌 정보입니다.
"Self"라는 이름의 근거는 Q, K, V가 모두 같은 입력열에서 나온다는 사실입니다. 질문, 질문과 맞춰 볼 키, 값을 같은 열이 전부 만들어 냅니다. 입력이 "The animal did not cross the street"이면 Q, K, V 셋 모두 이 문장 자체에서 유도됩니다.
도서관 비유가 이해를 돕습니다. 머신러닝 책을 찾고 있다면 Query는 찾는 주제인 "machine learning", Key는 서가의 모든 책에 붙은 라벨, Value는 책 안의 실제 내용입니다. 내 Query를 모든 Key와 비교해 일치하는 Key의 Value를 가장 많이 가져옵니다.
| 구분 | 셀프 어텐션 | 크로스 어텐션 |
|---|---|---|
| Query | 입력열 | 한 열(디코더) |
| Key·Value | 같은 입력열 | 다른 열(인코더 출력) |
크로스 어텐션과의 차이는 Q·K·V의 출처가 하나인지 둘인지에 있습니다(2.8.5 참조). 고객이 "모델이 문맥을 어떻게 파악합니까"라고 물으면 같은 문장 안 토큰들이 서로에게 Query와 Key로 질의하고 응답하는 구조라고 답하면 됩니다.
2.9.2 셀프 어텐션 단계별 계산
계산은 여섯 단계입니다.
| 단계 | 하는 일 | 식 |
|---|---|---|
| 1 | 입력 임베딩 준비: 모든 토큰을 벡터로 변환 | |
| 2 | 임베딩에 서로 다른 가중치 행렬 3개를 곱해 Q, K, V 생성 | Q = X·W_Q, K = X·W_K, V = X·W_V |
| 3 | Q와 K의 전치 행렬을 내적해 어텐션 점수 계산 | Scores = Q·Kᵀ |
| 4 | 점수를 Key 벡터 차원의 제곱근으로 나눔 | Scaled = (Q·Kᵀ)/√d_k |
| 5 | Softmax 적용. 각 행의 합이 1이 됨 | Weights = softmax(Scaled) |
| 6 | 가중치에 Value 행렬을 곱해 최종 출력 계산 | Output = Weights·V |
W_Q,W_K,W_V는 모델이 학습 중에 배우는 가중치 행렬이며 고정된 값이 아닙니다. 입력 임베딩마다 이 세 행렬을 곱해 Q, K, V를 만듭니다.- 3단계에서 전치를 쓰는 이유는 행렬 곱의 모양을 맞추기 위해서입니다. 점수가 높을수록 한 토큰의 Query와 다른 토큰의 Key가 더 잘 맞는다는 뜻입니다.
- 4단계의 스케일링은 값을 안정된 범위로 유지해 Softmax가 극단적인 값을 내지 않게 합니다. 이 나눗셈이 없으면 학습 중 기울기가 아주 작아질 수 있습니다.
- 5단계 가중치는 각 토큰이 다른 모든 토큰에 얼마나 주의를 줄지를 나타내며(1.11 참조), 6단계 출력은 주변 문맥으로 의미가 풍부해진 각 토큰의 새 표현입니다.
전체 식은 Attention(Q, K, V) = softmax(Q·Kᵀ / √d_k) · V입니다.
flowchart TB
  X[입력 임베딩] --> Q[Q]
  X --> K[K]
  X --> V[V]
  Q --> S["Q·Kᵀ"]
  K --> S
  S --> D["√d_k로 나눔"]
  D --> SM[Softmax]
  SM --> W[어텐션 가중치]
  W --> M[Value와 곱함]
  V --> M
  M --> O[출력]
그림 2.9.2 — Q, K, V는 모두 같은 입력에서 만들어지며, Q와 K가 가중치를 만들고 V가 최종 출력을 만듭니다.
스케일링의 효과는 숫자로 확인됩니다. 점수가 [8, 0]이면 Softmax 결과는 [0.9997, 0.0003]로 한쪽에 쏠리고, 같은 점수를 √64 = 8로 나눈 [1, 0]이면 [0.7311, 0.2689]로 완만해집니다. 쏠린 Softmax는 기울기가 거의 0이어서 학습이 멈춥니다(1.10 참조). 모델에서 어텐션 점수가 비정상적으로 극단적이라는 보고를 받으면 이 스케일링 단계가 있는지부터 확인합니다.
2.9.3 간단한 문장 예제 따라가기
I love AI 세 토큰으로 6단계를 따라가 봅니다.
- 각 토큰이 임베딩 벡터가 됩니다.
- 학습된 가중치 행렬로 토큰마다 Q, K, V를 만듭니다. 토큰이 셋이므로 Q 셋, K 셋, V 셋이 생깁니다.
- 토큰
I의 Query를I,love,AI셋의 Key와 각각 내적하면 점수 세 개가 나옵니다. - 점수를
√d_k로 나눕니다. - Softmax를 적용합니다. 원문이 이해를 돕기 위해 가정한
I의 결과는 아래와 같습니다. - 이 가중치로 Value를 합산한 것이
I의 새 표현입니다.
I의 가중치는 자기 자신 0.070, love 0.707, AI 0.223입니다. 곧 I는 자신에게 7%, love에 70.7%, AI에 22.3%의 주의를 줍니다. 모든 토큰에 같은 계산을 하면 전체 어텐션 가중치 행렬이 됩니다.
| 보는 쪽 \ 받는 쪽 | I | love | AI | 행 합계 |
|---|---|---|---|---|
| I | 0.070 | 0.707 | 0.223 | 1.000 |
| love | 0.333 | 0.333 | 0.333 | 1.000 |
| AI | 0.168 | 0.533 | 0.299 | 1.000 |
표 2.9.3 — 이해를 돕기 위한 가정 값입니다. 행 합계가 1인 것은 Softmax 때문이며
python3로 세 행 모두 1.000임을 재계산했습니다.
- 각 행은 해당 토큰이 문장 안의 모든 토큰에 주는 주의의 몫을 나타냅니다.
love행은 세 칸이 모두 0.333이므로 어느 토큰도 특별히 고르지 않은 균등 주의입니다. - 행 합계가 반드시 1이어야 하므로, 주목할 대상이 없어도 토큰은 주의를 어딘가에 나눠 줘야 합니다. 그 결과 문장 맨 앞 토큰이 주의를 받아 내는 어텐션 싱크(attention sink) 역할을 하게 됩니다.
I의 출력은0.070 × V(I) + 0.707 × V(love) + 0.223 × V(AI)입니다.love의 가중치가 가장 크므로I의 새 표현은love의 의미에 크게 좌우됩니다.
원문에는 Value 값이 주어지지 않으므로 계산 감각을 위해 가상의 2차원 값을 두어 봅니다. V(I) = [1, 0], V(love) = [0, 1], V(AI) = [1, 1]이면 I의 출력은 [0.070 + 0.223, 0.707 + 0.223] = [0.293, 0.930]이고, python3로 재계산해도 같습니다. 출력이 V(love) 쪽으로 기운 것이 가중치 0.707의 효과입니다.
같은 과정이 모든 토큰에 동시에 일어나므로 한 번에 문장 전체의 문맥 반영 표현이 나옵니다. 고객이 모델의 주목 대상을 시각화한 히트맵을 가져오면, 행이 보는 쪽이고 열이 받는 쪽이며 각 행의 합이 1이라는 읽는 법을 먼저 맞추고 논의를 시작합니다.
2.9.4 멀티 헤드 셀프 어텐션
Q, K, V 한 벌로는 문장 안의 다양한 관계를 모두 잡기 어렵습니다. 멀티 헤드 셀프 어텐션(Multi-Head Self Attention)은 각자의 W_Q, W_K, W_V를 가진 셀프 어텐션을 여러 번 병렬로 돌리는 방식이며, 한 번의 실행을 "헤드"라 부릅니다. 헤드마다 문장의 다른 측면을 학습합니다.
- 한 헤드는 주어-목적어 관계에 주목합니다.
- 다른 헤드는 동사 시제에 주목합니다.
- 또 다른 헤드는 멀리 떨어진 단어 사이의 의존 관계에 주목합니다.
모든 헤드의 작업이 끝나면 출력을 이어 붙이고(concatenate) 선형 층 하나를 더 통과시켜 최종 출력을 얻습니다.
flowchart TB
  I[입력] --> H1[Head 1]
  I --> H2[Head 2]
  I --> HN[Head N]
  H1 --> C[이어 붙이기]
  H2 --> C
  HN --> C
  C --> L[선형 층]
  L --> F[최종 출력]
그림 2.9.4 — 헤드마다 자기만의
W_Q,W_K,W_V로 셀프 어텐션을 돌립니다.
멀티 헤드 셀프 어텐션은 여러 셀프 어텐션의 병렬 실행이므로, 같은 문장에서 여러 종류의 관계를 동시에 잡습니다.
셀프 어텐션이 쓰이는 위치는 두 곳입니다.
| 위치 | 방식 |
|---|---|
| 인코더 | 모든 인코더 층의 핵심 부품. 입력 토큰 각각이 다른 모든 입력 토큰을 봄 |
| 디코더 | 마스크드 셀프 어텐션. 미래 토큰을 마스크로 가려, 각 토큰이 자신과 앞선 토큰만 봄 |
디코더가 마스크를 쓰는 이유는 한 번에 한 토큰씩 생성하므로 아직 없는 미래 토큰을 볼 수 없기 때문입니다(2.3.3 참조).
셀프 어텐션이 잘 작동하는 이유는 네 가지입니다.
- 병렬화: RNN과 LSTM은 토큰을 하나씩 처리해 느렸지만(2.10.1 참조), 셀프 어텐션은 모든 토큰을 동시에 처리하므로 GPU에서 학습이 빠릅니다.
- 장거리 의존성: 멀리 떨어진 토큰도 직접 봅니다. 거리에 따른 감쇠가 없습니다. 대신 비용이 따르며, 그래서 긴 컨텍스트 모델은 각 토큰이 근처 토큰만 보는 슬라이딩 윈도우 어텐션으로 바꾸기도 합니다.
- 문맥 이해: 같은 단어라도 문장에 따라 다른 표현을 받습니다.
- 유연성: 계산 순서에 구애받지 않고 긴 열과 복잡한 관계를 다룹니다.
셀프 어텐션이 없으면 트랜스포머 구조는 지금의 모습으로 존재하지 않았을 것입니다. 모든 토큰이 모든 토큰을 보는 비용이 열 길이에 따라 커진다는 점이 길이 한계와 비용의 출발점이므로, 고객이 긴 문서 입력을 요구하면 이 구조를 근거로 비용과 길이 사이의 균형을 설명합니다(2.16 참조).
2.10 LLM 아키텍처의 진화
원문: Evolution of LLM Architecture
LLM 아키텍처는 모델이 텍스트를 어떻게 읽고, 읽은 것을 어떻게 기억하고, 다음 단어를 어떻게 만드는지를 정한 설계도입니다. 집을 지을 때 벽돌과 시멘트는 어느 집이나 같지만 방 배치와 문 크기, 물의 흐름을 정하는 설계도가 집의 품질을 결정하는 것과 같아서, LLM에서도 숫자와 수학은 모델마다 비슷하고 아키텍처가 읽기·기억·응답 방식을 결정합니다.
이 절은 2026년 9월 글 기준으로 아키텍처가 단계마다 앞선 설계의 문제를 풀며 이어져 온 흐름을 정리합니다. 첫 모델은 읽은 것을 잊었고, 어텐션이 망각을 풀었지만 여전히 느렸으며, 트랜스포머가 속도를 해결했으나 얼마나 크게 만들지가 문제였고, 스케일링이 모델을 똑똑하게 했지만 비용이 커졌고, Mixture of Experts가 비용을 낮췄습니다. 이야기는 지금도 진행 중입니다. 원문 설명을 위해 이 절에서도 토큰을 "단어"로 부르지만 실제로 모델이 다루는 단위는 토큰입니다(2.4 참조).
2.10.1 RNN: 한 단어씩 읽는 구조의 한계
트랜스포머 이전에 텍스트 읽기의 대표 설계는 순환 신경망(RNN, Recurrent Neural Network)이었습니다. RNN은 문장을 왼쪽에서 오른쪽으로 한 단어씩 읽으며, 단어를 읽을 때마다 작은 메모 하나를 갱신하고 다음 단어로 넘어갑니다. The를 읽으면 메모에 The가 담기고, cat을 읽으면 메모가 The cat을 기억하도록 다시 쓰이며, 끝까지 이 과정이 반복됩니다. 마지막에는 문장 전체가 그 메모 한 장에 압축되어 있습니다. 과거에서 앞으로 전달되는 것은 이 메모뿐입니다.
flowchart LR
  W1[The] --> N1[메모] --> W2[cat] --> N2[메모] --> W3[sat] --> N3[메모] --> W4[...] --> NN[메모: 문장 전체가 여기에]
그림 2.10.1 — RNN은 같은 메모 하나를 단어마다 다시 씁니다.
짧은 문장에는 통했지만 두 가지 문제가 있습니다.
| 문제 | 설명 | 예 |
|---|---|---|
| 1. 망각 | 긴 글에서 메모가 너무 여러 번 덮어쓰여 앞 단어가 거의 사라짐 | Riya went to the market and then she bought에서 she가 Riya임을 기억하기 어려움. 맨 앞에 쓰인 Riya가 뒤의 모든 단어에 덮어쓰이며 흐려짐 |
| 2. 느린 학습 | 단어 1을 읽어야 단어 2를 읽고, 단어 2를 읽어야 단어 3을 읽음 | 수천 개를 동시에 처리하는 강력한 컴퓨터를 한 걸음씩만 사용 |
개선판인 LSTM과 GRU는 망각을 크게 줄였지만 없애지는 못했고, 한 단어씩 읽는 느림도 그대로였습니다.
고객이 오래된 순차 모델 기반 시스템을 쓰고 있다면 긴 입력에서 앞부분 정보가 누락되는 현상과 학습·추론 속도가 이 구조의 특성임을 알고 점검하면 됩니다.
2.10.2 어텐션과 트랜스포머의 등장
어텐션(Attention)은 현재 단어를 처리하는 동안 입력의 모든 단어를 돌아보고 각각에 얼마나 집중할지 정하는 메커니즘입니다. 작은 메모 한 장 대신 페이지 전체를 눈앞에 펼쳐 놓고, 단어를 이해할 때 도움이 되는 앞 단어를 직접 보는 방식입니다. 한 줄로 쓰면 "모든 단어를 보고, 각각의 중요도를 정하고, 그에 따라 섞는다"입니다.
Riya went to the market and then she bought mangoes.에서 she를 처리할 때, 앞 단어 4개만 보면 다음과 같은 가중치(합 1)가 나옵니다(원문이 이해를 위해 가정한 값).
| 앞 단어 | 가중치 |
|---|---|
| Riya | 0.70 |
| went | 0.10 |
| market | 0.15 |
| then | 0.05 |
| 합계 | 1.00 |
she의 이해는 Riya에서 70%, market에서 15%, 나머지에서 조금씩 가져와 만들어집니다. 어텐션은 "다른 단어들의 가중 혼합이며, 가중치가 각 단어의 중요도를 말한다"는 한 문장으로 요약됩니다. RNN에서 she는 사슬을 따라 도착한 메모만 보지만, 어텐션에서는 모든 앞 단어로 직접 선이 있어 중간에 잃는 것이 없습니다.
어텐션 안에서 모든 단어는 세 역할을 맡습니다(도서관 비유).
- Query: 묻는 질문입니다.
she에서는 "이 사람이 누구인가"입니다. - Key: 책등의 라벨입니다.
Riya는 "사람 이름"이라는 라벨을 달고 있습니다. - Value: 책 속 내용, 곧 단어가 실제로 지닌 정보입니다.
Query를 모든 Key와 비교해 잘 맞는 Key가 높은 점수를 받고, 그 점수로 가중한 Value를 모읍니다. Key는 맞춰 보는 데만 쓰이고 실제 내용은 Value에서 옵니다(2.9.1 참조). 같은 문장의 단어들이 서로를 보는 형태가 셀프 어텐션이며 LLM 내부에서 쓰이는 형태입니다(2.9 참조). 관계는 하나가 아니어서(she-Riya는 의미, bought-mangoes는 문법) 어텐션을 여러 개 나란히 돌리는 멀티 헤드 어텐션을 쓰고, 헤드마다 이름, 문법, 위치 같은 서로 다른 것을 추적한 뒤 결과를 합칩니다(2.8.3 참조).
어텐션은 망각을 풀었습니다. 입력의 어떤 단어도 메모에서 밀려나지 않고 직접 볼 수 있기 때문입니다. 그러나 처음에는 RNN 위에 어텐션을 얹는 형태였습니다. RNN이 입력을 한 단어씩 읽고, 어텐션은 RNN이 이미 읽은 것을 돌아보는 데만 도왔으므로 느린 순차 읽기는 그대로였습니다.
2017년 "Attention Is All You Need" 논문은 어텐션이 실제 일을 한다면 RNN을 둘 이유가 무엇인지 물었고, RNN을 완전히 없애고 어텐션과 몇 가지 단순한 수학 조각만으로 모델을 지었습니다. 그것이 트랜스포머이며, 입력의 모든 단어를 동시에 읽고 어텐션으로 서로의 관계를 이해하는 모델입니다. 트랜스포머는 블록을 쌓아 만들고 블록마다 두 부분이 있습니다.
- 멀티 헤드 어텐션: 단어들이 서로를 보며 정보를 모으는 "보는 단계"입니다.
- 피드포워드 네트워크: 모은 정보를 단어별로 홀로 처리하는 "생각하는 단계"입니다.
초기 블록은 문법 같은 단순한 것을, 깊은 블록은 의미와 추론 같은 큰 것을 배웁니다. 작은 모델은 12개 안팎, 큰 모델은 100개 이상의 블록을 가집니다(2.8.4 참조).
트랜스포머에는 단어 순서 문제와 구조 선택이 따라붙었습니다.
- 단어 순서: 모든 단어를 한꺼번에 읽으므로
Dog bites man과Man bites dog이 똑같이 보입니다. 위치 인코딩이 단어마다 몇 번째인지 신호를 더해 해결합니다. 원형은 고정된 신호를 썼고, 현대 LLM은 LLaMA 등이 쓰는 회전 위치 임베딩(RoPE, Rotary Position Embedding) 같은 새 방법으로 같은 일을 합니다. 방법은 바뀌었지만 모델에게 위치를 알려 준다는 생각은 같습니다(2.8.2 참조). - 구조: 원형은 입력을 이해하는 인코더와 출력을 한 단어씩 쓰는 디코더로 구성되어 번역(영어를 읽고 프랑스어를 씀)을 위해 만들어졌습니다. 이후 텍스트 생성에는 디코더 반쪽이면 충분하다는 사실이 확인되었습니다. 단어들을 주면 다음 단어를 예측하고, 그 단어를 입력에 붙여 다시 예측합니다. 이것이 decoder-only 트랜스포머이며 GPT를 비롯한 거의 모든 챗 모델의 설계입니다. 이 반복이 자기회귀 생성입니다(2.3 참조).
flowchart LR
  subgraph ED[encoder-decoder: 번역용]
    A["The cat sat"] --> B[Encoder] --> C[Decoder] --> D["Le chat s'est assis"]
  end
  subgraph DO[decoder-only: 챗 모델]
    E["The capital of India is"] --> F[Decoder] --> G["New"]
    H["The capital of India is New"] --> I[Decoder] --> J["Delhi"]
  end
그림 2.10.2 — decoder-only 모델은 생성한 단어를 입력에 되붙여 다시 예측합니다.
트랜스포머가 이긴 이유는 병렬 처리가 GPU에 정확히 맞았기 때문입니다. GPU는 작은 계산 수천 개를 동시에 하는 칩이며, 원문은 RNN으로 몇 주 걸리던 학습이 트랜스포머로는 며칠로 줄었다고 말합니다. 6단어를 읽을 때 RNN은 앞 단계가 끝나길 기다리는 6단계가 필요하고, 트랜스포머는 6단어를 한 단계에서 처리합니다.
이 병렬 읽기는 입력과 학습에 적용됩니다. 답을 쓰는 동안에는 여전히 한 단어씩 만들어, 읽기는 병렬이고 쓰기는 직렬입니다. 이 구분이 비용과 지연을 이해하는 열쇠입니다(10.3 참조). 고객이 "응답이 왜 한 번에 안 나옵니까"라고 물으면 이 구분으로 답합니다.
2.10.3 스케일링: 데이터와 크기의 균형, 비용 문제
학습이 빨라지자 "더 많은 데이터로 더 큰 모델을 훈련하면 어떨까"라는 물음이 이어졌습니다. 스케일링(Scaling)은 모델을 세 방향으로 키우는 일입니다.
- 파라미터: 모델 내부의 설정값입니다. 수십억 개의 작은 손잡이가 달린 거대한 판으로 비유할 수 있고, 학습은 손잡이를 조금씩 돌려 예측을 낫게 만듭니다.
- 데이터: 모델이 배우는 텍스트(책, 웹사이트, 기사, 코드 등)입니다.
- 컴퓨트: 학습 중 수행한 총 계산량입니다. GPU를 더 오래 더 많이 돌린다는 뜻입니다.
2020년 무렵 연구자들은 파라미터, 데이터, 컴퓨트를 함께 늘리면 모델이 부드럽고 예측 가능하게 좋아진다는 사실을 발견했습니다. 갑작스러운 벽이 없었고, 이 관계를 스케일링 법칙(Scaling Laws)이라 부릅니다. 컴퓨트를 이만큼 쓰면 품질이 대략 이만큼 나온다는 공식을 줍니다. 그 결과 모델은 빠르게 커졌습니다.
| 모델 | 파라미터(약) | 비고 |
|---|---|---|
| GPT-2 | 15억 | |
| GPT-3 | 1,750억 | 1년 뒤 100배 이상으로 커짐 (175 ÷ 1.5 ≈ 116.7배, python3로 재계산) |
GPT-3는 특정 과제를 따로 학습하지 않고도 에세이, 질의응답, 코드 작성을 해냈습니다. 큰 크기에서만 나타나는 이런 새 능력을 창발 능력(emergent abilities)이라 합니다. 일부 연구자는 이 능력이 갑자기 나타나는 것이 아니라 크기에 따라 부드럽게 커지는데 측정 방식 때문에 갑작스러워 보일 뿐이라고 주장하지만, 용어는 널리 쓰입니다.
이어 교정이 있었습니다. 2022년 Chinchilla 논문은 많은 대형 모델이 파라미터는 너무 많고 데이터는 너무 적어 덜 학습되었음을 밝혔습니다. 교훈은 최상의 결과를 위해 파라미터와 함께 데이터를 늘려야 한다는 것이며, 더 많은 데이터로 학습한 작은 모델이 데이터가 적은 큰 모델을 이길 수 있습니다. 이후 LLaMA 같은 모델이 수조 토큰으로 학습된 이유입니다. 즉 큰 모델이 항상 더 좋은 것은 아닙니다.
스케일링이 통하자 새 문제가 생겼습니다. 일반 트랜스포머에서는 모든 파라미터가 모든 단어마다 사용됩니다. 1,750억 파라미터 모델에 100단어짜리 질문을 하면 100단어 각각에 대해 1,750억 개가 모두 일합니다. 이런 모델을 밀집(dense) 모델이라 하며, 쉬운 the이든 어려운 전문 용어이든 전체 모델이 일하고, 쉬운 단어에 일을 덜 하는 길이 없습니다. 모델 크기가 두 배면 답변 하나의 비용도 두 배가 되고, 학습도 비싸졌지만 수백만 사용자를 위한 운영은 더 비싸졌습니다.
고객이 "더 큰 모델이 더 좋지 않습니까"라고 물으면 파라미터 수만이 아니라 학습 데이터 양과 운영 비용이 함께 따라온다고 답하고, 크기와 비용 사이 균형으로 모델 선택을 논의합니다.
2.10.4 Mixture of Experts: 전체 vs 활성 파라미터
Mixture of Experts(MoE)는 모델을 전문가(expert)라는 여러 작은 부분으로 나누고, 단어마다 일부 전문가만 쓰는 아키텍처입니다. MoE는 많은 전문가와 그중 몇 명을 고르는 라우터(router)의 결합입니다. 큰 병원에서 접수 담당이 증상을 듣고 한두 명의 적합한 의사에게 보내는 것과 같습니다. 의사가 전문가, 접수 담당이 라우터(게이트라고도 함)이며, 환자를 일부 의사에게만 보내는 것이 희소 활성화(sparse activation)입니다.
트랜스포머 블록 안에서 MoE는 어텐션 뒤 "생각하는 단계"인 피드포워드 네트워크 하나를 여러 개의 피드포워드 네트워크(전문가)로 바꾸고 앞에 작은 라우터를 둡니다. 단어마다 다음과 같이 진행됩니다.
- 라우터가 단어를 보고 전문가마다 점수를 줍니다.
- 점수가 높은 몇 명(대개 상위 1개나 2개)을 고릅니다.
- 선택된 전문가만 그 단어를 처리합니다.
- 출력을 합쳐 다음으로 넘깁니다.
어텐션 부분은 그대로이고 생각하는 단계만 전문가 팀이 됩니다. 전문가 8명 중 라우터 점수가 0.4, 0.1, 0.3, 0, 0.1, 0, 0.1, 0이라면 상위 둘인 전문가 1과 3만 일하고, 다음 단어에서는 다른 쌍이 뽑힐 수 있습니다(라우터 상세는 3.3 참조).
flowchart TB
  W[단어 입력] --> A[멀티 헤드 어텐션: 기존과 동일]
  A --> R[라우터: 전문가별 점수]
  R -->|0.4| E1[전문가 1: 작동]
  R -->|0.3| E3[전문가 3: 작동]
  R -.->|나머지 6명| EX[대기]
  E1 --> C[두 출력을 합침]
  E3 --> C
그림 2.10.4 — 전문가 8명 중 점수 상위 2명만 이 단어를 처리합니다.
핵심 개념은 전체 파라미터와 활성 파라미터의 차이입니다. 약 70억 파라미터 모델의 블록마다 피드포워드 네트워크 하나를 전문가 8개로 바꾼 것이 Mixtral 8x7B의 기본 설계이며, 이름은 70억 규모 기반 위의 전문가 8개라는 뜻입니다. 모델은 8 × 7 = 56(십억)이 되지 않는데, 어텐션과 공유 부분은 복사되지 않고 피드포워드만 8배로 복제되기 때문입니다. 공유 부분을 합치면 총 약 470억입니다. 단어마다 라우터가 8명 중 2명만 고르므로 단어당 일하는 파라미터는 약 130억입니다(원문의 반올림 수치).
| 구분 | 규모 | 의미 |
|---|---|---|
| 전체 파라미터 | 약 470억 | 모델이 가진 지식 |
| 활성 파라미터 | 약 130억 | 단어당 수행하는 작업 |
지식은 470억 모델 수준이면서 운영 비용은 130억 모델에 가깝습니다. 라우터와 공유 부분도 일하므로 정확히 같지는 않지만 470억을 모두 돌리는 것보다 훨씬 쌉니다. 더 큰 예로 DeepSeek-V3는 전체 약 6,710억 파라미터 중 단어당 약 370억만 활성화됩니다(약 5.5%, python3로 계산). 이 수치는 2026년 9월 글 기준입니다.
전문가가 무엇을 맡을지는 사람이 정하지 않습니다. 학습 중 라우터와 전문가가 함께 배우며, 어떤 전문가는 구두점을, 어떤 전문가는 숫자나 코드 일부, 특정 종류의 단어를 맡게 됩니다. 구분이 항상 깔끔하지는 않지만 저절로 생깁니다.
MoE는 공짜가 아닙니다.
- 메모리: 단어당 2명만 일해도 다음 단어가 다른 쌍으로 갈 수 있으므로 8명 모두를 메모리에 올려야 합니다. MoE는 계산을 아끼지만 메모리는 아끼지 못합니다.
- 부하 분산: 라우터가 계속 같은 두 전문가에게만 보내면 나머지는 학습하지 못합니다. 학습 중 라우터가 일을 고르게 나누도록 미는 작은 규칙을 추가하며, 없으면 MoE는 실패합니다.
- 학습 복잡도: 라우팅 결정 때문에 학습이 덜 안정적이고 맞추기 어렵습니다.
그럼에도 수천억 파라미터 모델이 합리적인 시간 안에 응답할 수 있는 것은 MoE 덕분이며, 현재 가장 큰 모델 대부분이 어떤 형태로든 MoE를 씁니다. MoE 제품을 제안받은 고객에게는 "활성 파라미터 기준 비용은 낮지만 메모리는 전체 파라미터를 올려야 한다"는 비대칭을 먼저 알리고, 서버 사양은 전체 파라미터 기준으로 산정해야 합니다.
2.10.5 긴 컨텍스트와 상태 공간 모델(SSM)
모델에 한 번에 주는 텍스트가 컨텍스트(context)입니다. 책 전체, 긴 대화, 큰 코드베이스를 넣고 싶어졌지만 어텐션은 모든 단어를 다른 모든 단어와 비교합니다.
| 입력 길이 | 비교 횟수 | 비고 |
|---|---|---|
| 4단어 | 4 × 4 = 16 | |
| 8단어 | 8 × 8 = 64 | 단어 2배, 비용 4배 |
| 1,000단어 | 1,000 × 1,000 = 100만 | |
| 100,000단어 | 약 100억 | python3로 계산: 10,000,000,000 |
단어를 하나 더하면 행 하나와 열 하나가 통째로 늘어 격자가 입력보다 훨씬 빨리 커집니다. 또 답을 생성하는 동안 모델은 앞 단어의 Key와 Value를 다시 계산하지 않으려고 저장하는데, 이 저장소가 KV 캐시입니다. 긴 입력에서는 KV 캐시가 커져 메모리를 먹어 치웁니다(10.3 참조). 이를 줄이는 설계가 나왔습니다.
| 설계 | 방법 | 효과·사용처 |
|---|---|---|
| 그룹 쿼리 어텐션(GQA) | 여러 어텐션 헤드가 각자 대신 같은 Key와 Value를 공유 | 8헤드를 2그룹으로 나누면 KV 캐시 8세트가 2세트로, 4분의 1. 헤드는 자기 Query를 그대로 물으므로 품질 손실이 아주 작음. LLaMA 3 등 |
| 멀티 헤드 잠재 어텐션(MLA) | Key와 Value를 작은 형태로 압축해 저장하고 필요할 때 원래 크기로 복원 | KV 캐시가 훨씬 작아지며 정보는 온전히 이용. DeepSeek 모델 |
| 슬라이딩 윈도우 어텐션 | 각 단어가 모든 단어 대신 가까운 고정 윈도우만 봄 | 윈도우가 3이면 w8은 w5, w6, w7만 봄. 정보는 블록을 거치며 멀리 전달됨. Mistral |
슬라이딩 윈도우에서 1번 블록의 w5는 w2~w4에서 정보를 모으고, 2번 블록에서 w8이 w5를 보면 그 정보를 간접적으로 얻습니다. 윈도우가 작아도 먼 정보가 블록 한 층씩 건너 도착합니다. 이런 아이디어 덕분에 모델이 한 번에 읽는 길이가 약 2,000토큰에서 100만 토큰으로 늘었습니다.
다른 길도 있습니다. 상태 공간 모델(State Space Model, SSM) 중 대표는 Mamba입니다. RNN처럼 실행 중인 메모리를 유지하므로 비용이 입력 길이에 비례해 직선으로 늘어납니다(어텐션은 제곱). 옛 RNN과 다른 점은 들어오는 단어마다 메모리에 무엇을 남기고 무엇을 버릴지 정한다는 것이어서, 멀리서 온 중요 정보가 훨씬 잘 살아남습니다. 원문이 상대 비교용으로만 제시한 가상 수치는 아래와 같습니다.
| 입력 길이 | 1,000 | 2,000 | 4,000 | 8,000 |
|---|---|---|---|---|
| 어텐션 비용(제곱) | 1 | 4 | 16 | 64 |
| Mamba 비용(직선) | 1 | 2 | 4 | 8 |
표 2.10.5 — 실측이 아닌 비교용 단위. 입력이 두 배가 될 때 어텐션 비용은 4배, Mamba 비용은 2배가 되며
python3로 재계산해도 같습니다.
오늘날에는 어텐션의 정확도와 Mamba의 속도를 함께 얻으려고 소수의 어텐션 블록과 다수의 Mamba 블록을 섞은 하이브리드 모델도 보입니다. 고객이 긴 문서를 통째로 넣으려 하면 비용이 입력 길이의 제곱으로 커지는 구조와, 이를 줄이는 GQA·MLA·슬라이딩 윈도우·SSM 같은 설계가 있다는 점을 알려 줍니다(2.16 참조).
2.10.6 멀티모달과 추론 시간 확장
초기 LLM은 텍스트만 읽었지만 같은 트랜스포머 설계가 이미지, 오디오, 비디오에도 쓰입니다. 이미지는 작은 패치로 잘리고, 각 패치가 단어처럼 토큰이 되어 같은 어텐션이 처리합니다. 오디오와 비디오도 비슷하게 다루며 이를 멀티모달(multimodal) 모델이라 합니다(3.4 참조).
또 하나의 변화는 키우는 방향입니다. 오랫동안 더 똑똑한 모델로 가는 길은 더 큰 모델이었는데, 이제는 답하기 전에 더 오래 생각하게 하는 두 번째 길이 있습니다. 추론 모델(reasoning model)(3.2 참조)은 최종 답 전에 긴 생각 단계 사슬을 생성하며, 그 과정에서 여러 경로를 시도하고 스스로 검증합니다. 이것이 추론 시간(inference time) 확장이며, 추론은 모델이 답하는 시점을 가리키는 말입니다. 학습 때만이 아니라 답할 때도 컴퓨트를 쓰는 것입니다. 스케일링 이야기는 이제 학습을 키우는 방향과 생각을 키우는 방향의 두 갈래입니다.
전체 여정을 표로 모으면 각 단계가 앞 단계의 좋은 점을 유지하고 가장 큰 문제를 고쳤음을 알 수 있습니다.
| 단계 | 핵심 아이디어 | 해결한 문제 | 남긴 문제 |
|---|---|---|---|
| RNN | 메모리 하나로 한 단어씩 읽음 | 임의 길이 텍스트를 읽음 | 앞 단어 망각, 느린 학습 |
| 어텐션 | 가중치로 모든 앞 단어를 봄 | 망각 | RNN 위에서는 여전히 느림 |
| 트랜스포머 | 어텐션만, 모든 단어 병렬 | 느린 학습 | 얼마나 크게 만들지 |
| 스케일링 | 파라미터·데이터·컴퓨트 증가 | 모델 품질 | 크기에 비례해 비용 증가 |
| MoE | 단어당 소수 전문가만 사용 | 대형 모델의 운영 비용 | 메모리, 부하 분산 |
| 새 방향 | GQA, MLA, Mamba, 멀티모달, 추론 | 긴 컨텍스트, 새 입력, 더 똑똑한 답 | 진화 중 |
FDE는 새 모델 소식을 받으면 이 표의 어느 문제를 풀려는 모델인지(긴 컨텍스트인지, 비용인지, 추론 품질인지) 먼저 묻고, 그 답을 근거로 고객 과제에 필요한 모델인지 판단합니다. 위 파라미터 수치는 모두 2026년 9월 글이 인용한 대략값입니다.
2.11 온도(Temperature)와 LLM 출력
원문: How does Temperature control LLM output?
온도는 LLM이 다음 토큰을 고르는 방식을 조절하는 숫자 하나이며, 낮추면 안전하고 예측 가능한 답이, 높이면 창의적이고 의외인 답이 나옵니다. 이 절은 2026년 9월 글 기준으로 점수에서 확률로, 확률에서 추첨으로 이어지는 선택 과정을 수치로 확인하고, 그 과정에서 온도가 개입하는 정확한 지점을 보여 줍니다(1.11 참조).
2.11.1 점수를 확률로 바꾸는 Softmax와 온도
LLM은 문장을 한 번에 쓰지 않고 작은 조각(토큰)을 하나씩 씁니다. 설명을 위해 토큰 하나를 단어 하나로 가정합니다(2.4 참조). The sky is 뒤에 올 토큰을 고를 때 모델은 아는 모든 토큰에 점수를 줍니다. 실제 모델은 10만 개가 넘는 토큰을 알지만 예제는 네 개로 줄입니다.
| 토큰 | 점수(로짓) |
|---|---|
| blue | 4.0 |
| clear | 3.0 |
| falling | 1.0 |
| banana | 0.0 |
The sky is blue가 가장 흔한 문장이므로 blue의 점수가 가장 높고, The sky is banana는 말이 되지 않아 가장 낮습니다. 이 정규화 전 원점수가 로짓(logit)입니다(1.12 참조). 그렇다고 모델이 최고 점수를 무조건 고르지는 않습니다. 먼저 점수를 확률로 바꿉니다. Softmax는 모든 점수를 양수로 만들고 합이 1(100%)이 되게 하며, 점수가 높을수록 확률도 높습니다.
| 토큰 | 점수 | 확률 |
|---|---|---|
| blue | 4.0 | 0.70 |
| clear | 3.0 | 0.26 |
| falling | 1.0 | 0.03 |
| banana | 0.0 | 0.01 |
종이쪽지 100장이 든 상자에서 한 장을 눈 감고 뽑는 추첨과 같습니다. 70장에 blue, 26장에 clear, 3장에 falling, 1장에 banana가 적혀 있고, 대부분은 blue가 나오며 아주 드물게 banana가 나옵니다. 이 뽑기가 샘플링(sampling)이고(2.12 참조), 흐름은 점수, 확률, 추첨 순서입니다. 하나를 뽑으면 텍스트에 붙이고 같은 과정을 반복하며, 이것이 자기회귀 생성입니다(2.3 참조).
온도는 Softmax가 확률로 바꾸기 직전에 점수에 개입합니다. 모든 점수를 온도로 나눈 뒤 Softmax에 넣으며 식은 다음과 같습니다.
새 점수 = 점수 / 온도
이 나눗셈 하나가 속임수의 전부입니다.
- 온도 1이면 모든 점수를 1로 나누므로 변화가 없습니다.
- 온도가 1보다 작으면(예: 0.5) 점수가 두 배가 되어 높은 점수와 낮은 점수의 간격이 벌어집니다.
- 온도가 1보다 크면(예: 2) 점수가 절반이 되어 간격이 좁아집니다.
간격이 중요한 이유는 Softmax가 점수 사이 거리에 반응하기 때문입니다. 한 점수가 크게 앞서면 확률 거의 전부를 가져가고, 점수들이 가까우면 확률이 나뉩니다. 추첨 상자로 말하면 온도는 쪽지의 분배를 바꿉니다. 낮은 온도는 1등 토큰에게 쪽지를 거의 몰아 주고, 높은 온도는 모든 토큰에게 고르게 퍼뜨립니다. 온도는 토큰의 순위를 바꾸지 않으며, blue는 어느 온도에서도 1등이고 바뀌는 것은 blue가 나머지를 얼마나 앞서는가뿐입니다.
고객이 "온도가 무엇을 바꿉니까"라고 물으면 "모델이 아는 것은 그대로 두고, 아는 것 중에서 고르는 방식만 바꿉니다"라고 답할 수 있어야 합니다.
2.11.2 저온 vs 고온의 출력 차이
같은 네 토큰과 점수로 온도를 바꿔 가며 python3 -I로 재계산한 확률은 아래와 같습니다(소수 둘째 자리 반올림, 원문 표와 일치).
| 온도 | blue | clear | falling | banana |
|---|---|---|---|---|
| 0.1 | 1.00 | 0.00 | 0.00 | 0.00 |
| 0.5 | 0.88 | 0.12 | 0.00 | 0.00 |
| 1 | 0.70 | 0.26 | 0.03 | 0.01 |
| 2 | 0.51 | 0.31 | 0.11 | 0.07 |
- 온도 0.5에서 점수는 8, 6, 2, 0이 되고,
blue는 70%에서 88%로 오릅니다. 반올림 전 값은falling0.0022,banana0.0003이어서 사실상 뽑히지 않습니다. 모델이 1등 선택에 더 확신합니다. - 온도 0.1에서 점수는 40, 30, 10, 0이 되고
blue가 사실상 100%입니다. 매번blue를 고릅니다. - 온도 2에서 점수는 2, 1.5, 0.5, 0이 되고
blue는 51%로 내려가며banana는 1%에서 7%로 오릅니다. 약한 토큰에게도 실제 뽑힐 기회가 생깁니다.
온도가 내려가면 1등 토큰이 모든 것을 가져가고, 올라가면 확률이 퍼져 모든 토큰이 제 몫을 받습니다. 직접 해 보려면 다음 코드가 핵심입니다.
def softmax_with_temperature(scores, temperature):
    scaled = [s / temperature for s in scores]   # 온도로 나눔
    exps = [math.exp(s) for s in scaled]         # 양수로
    return [round(e / sum(exps), 2) for e in exps]  # 합 1로
저온(0.1이나 0.2처럼 0에 가까운 값)에서는 모델이 거의 항상 1등 토큰을 고릅니다. 출력은 집중되고 예측 가능하며, 물을 때마다 같거나 거의 같고, 안전하고 핵심에 맞습니다. Write one line about the sky.를 물으면 거의 매번 The sky is blue.가 나옵니다. 장점은 신뢰성으로, 모델이 엉뚱한 곳으로 새지 않습니다. 단점은 지루하고 반복적일 수 있다는 점으로, 이야기 아이디어 열 개를 요청해도 아주 비슷한 열 개가 나올 수 있습니다.
고온(1.5나 2처럼 1을 넘는 값)에서는 약한 토큰에게 실제 기회가 갑니다. 출력은 창의적이고 의외이며 물을 때마다 달라지고, 가끔 이상하거나 틀립니다. 같은 질문에 The sky is clear., The sky is falling., 심지어 The sky is banana.가 나올 수 있습니다. 장점은 다양함과 창의성으로 브레인스토밍과 이야기에 적합합니다. 단점은 나쁜 토큰 하나가 답 전체를 망칠 수 있다는 점입니다. 모델은 이미 뽑은 토큰을 바탕으로 다음 토큰을 고르므로, banana를 뽑으면 The sky is banana라는 이상한 시작에서 문장을 이어 가야 하고 이후 선택도 그 시작에 끌려 내리막을 탑니다. 그래서 너무 높은 온도는 자주 말이 안 되는 출력을 냅니다(오류가 연쇄되는 원리는 2.18.4 참조).
표 2.11.2 — 온도별 확률 분포. 온도가 낮을수록 1등에 쏠리고, 높을수록 퍼집니다.
고객이 같은 질문에 답이 매번 달라진다고 불평하면 온도 설정부터 확인하고, 반대로 다양성이 부족하다고 하면 낮은 온도가 원인이 아닌지 살핍니다.
2.11.3 Temperature 0과 1의 의미
특별한 값이 둘 있습니다.
| 값 | 의미 |
|---|---|
| 온도 1 | 변화 없음. 학습된 그대로의 모델 본래 확률을 씀 |
| 온도 0 | 항상 최고 점수 토큰을 고름. 추첨이 없음. 매번 가장 좋은 토큰을 탐욕적으로 잡으므로 탐욕적 디코딩(greedy decoding) |
엄밀히 0으로 나눌 수는 없습니다. 그래서 온도를 0으로 두면 소프트웨어는 실제로 나누지 않고 추첨을 건너뛰어 1등 토큰을 곧바로 고릅니다.
온도 0이어도 두 번의 실행 결과가 조금 다를 수 있습니다. 모델을 돌리는 칩 내부의 미세한 반올림 차이 때문이며 온도 때문이 아닙니다. 온도 0은 "거의 항상 같다"일 뿐 "항상 같다는 보장"은 아닙니다. 정확히 같은 출력이 필요하면 모델에 다시 묻지 말고 저장해서 재사용해야 합니다. 이름의 유래는 물리학입니다. 차가운 물은 입자가 거의 움직이지 않고 제자리에 고정되어 얼음처럼 있고, 뜨거운 물은 입자가 자유롭게 뛰어다녀 수증기처럼 됩니다. 낮은 온도에서 모델은 1등 선택에 고정되고, 높은 온도에서는 여러 선택지 사이를 뛰어다니며, 연구자들이 물리학의 공식에서 아이디어를 빌려 오면서 이름이 남았습니다. 이 이름은 1.11.3에서 정의한 Softmax 온도와 같은 개념입니다.
고객과 재현성 이야기를 할 때 "온도 0으로 두면 같은 답이 나옵니까"에는 "거의 같지만 보장은 아닙니다"라고 정확히 답하고, 감사나 회귀 테스트에는 결과 저장을 권합니다.
2.11.4 용도별 온도 선택
정답이 하나뿐이면 온도를 낮게, 좋은 답이 여럿이면 높게 둡니다. 원문의 출발점 범위는 다음과 같습니다.
| 용도 | 온도 | 이유 |
|---|---|---|
| 코드 작성 | 0~0.2 | 코드는 창의적이기보다 정확해야 함 |
| 수학·사실 | 0~0.2 | 정답이 하나뿐 |
| 문서 요약 | 0.2~0.5 | 원문에 가까워야 함 |
| 고객 지원 챗 | 0.3~0.7 | 친근하되 정확해야 함 |
| 일반 대화 | 0.7~1 | 자연스럽고 사람 같음 |
| 이야기·시 | 0.8~1.2 | 창의적이고 의외 |
| 아이디어 브레인스토밍 | 1~1.5 | 서로 다른 아이디어를 많이 원함 |
이 범위는 출발점일 뿐이며 값은 용도에 달려 있으므로 몇 개를 시험해 가장 맞는 것을 고릅니다. 값의 일반적 설정 범위는 0~2이고 많은 도구가 기본값을 1로 둡니다(2026년 9월 글 기준이며 도구마다 다를 수 있습니다). 개발자가 자기 앱에서 LLM을 부를 때는 요청에 온도 칸이 있습니다.
response = model.generate(
    prompt="Write one line about the sky.",
    temperature=0.2   # 집중되고 예측 가능한 답
)temperature=1.2로 바꾸면 같은 프롬프트에서 창의적이고 다양한 답이 나오며, 바뀌는 것은 이 숫자 하나입니다. 고객 시스템의 용도별 기본값을 정할 때 이 표를 출발점으로 삼고, 정확성 과제는 낮게, 발상 과제는 높게 설정한 뒤 실제 질문 몇 개로 시험합니다.
2.11.5 온도 사용 시 흔한 실수
- 실수 1, 온도가 모델을 똑똑하게 한다고 믿는 것: 온도는 지식을 더하지 않고 정답률도 높이지 않으며, 모델이 이미 아는 것 중에서 고르는 방식만 바꿉니다. 모델이 답을 모르면 어떤 온도로도 고칠 수 없습니다(환각의 토큰 수준 설명은 2.18 참조). 낮은 온도는 답을 집중시킬 뿐 더 정확하게 만들지 않습니다.
- 실수 2, 창의성을 위해 온도를 너무 높이는 것: 1.5 안팎을 넘으면 출력이 금세 말이 안 됩니다. 창의성은 아주 높은 온도가 아니라 약간 높은 온도에서 나옵니다.
- 실수 3, 온도 0이면 매번 똑같은 출력이 나온다고 기대하는 것: 앞서 본 대로 미세한 반올림 차이가 출력을 조금 바꿀 수 있습니다. 정확히 같은 출력이 필요하면 저장해 두고 재사용합니다.
- 실수 4, 온도와 Top-p를 함께 바꾸는 것: Top-p는 약한 토큰을 추첨 상자에서 빼서 강한 토큰만 남기는 또 다른 무작위성 조절 설정입니다(2.12 참조). 둘 다 출력의 무작위성을 바꾸므로 동시에 바꾸면 무엇이 변화를 일으켰는지 알 수 없습니다. 온도는 점수를 Softmax 전에 나누어 확률을 뾰족하게 하거나 퍼뜨리고, Top-p는 약한 토큰을 선택에서 제거합니다. 한 번에 하나만 바꿉니다.
고객 현장의 튜닝 요청("답이 이상하니 온도를 낮춰 달라")에는 먼저 모델이 그 사실을 아는지를 가립니다. 지식이 없어서 틀리는 것이면 온도가 아니라 프롬프트, 검색(RAG), 모델 선택의 문제입니다.
2.12 Top-k·Top-p 샘플링
원문: How do Top-k and Top-p Sampling work?
Top-k와 Top-p는 LLM이 다음 토큰을 고를 때 후보 목록을 어떻게 자를지 정하는 두 가지 대표 방식입니다. 이 절은 2026년 9월 글 기준으로, 두 극단(항상 최선, 전체에서 추첨)의 문제에서 출발해 각 방식이 후보를 자르는 계산을 수치로 따라갑니다(온도는 2.11 참조).
2.12.1 항상 최선을 고르거나 전체에서 고를 때의 문제
모델은 문장을 한 번에 쓰지 않고 토큰을 하나씩 씁니다. The cat sat on the 뒤에서 모델은 자기가 아는 모든 토큰의 목록, 곧 어휘(vocabulary)의 토큰마다 점수(로짓)를 주고, Softmax로 합이 100%인 확률로 바꿉니다. 어휘는 수만 개 규모입니다(2.4 참조).
| 토큰 | 확률 |
|---|---|
| mat | 40% |
| floor | 25% |
| sofa | 15% |
| bed | 10% |
| roof | 5% |
| 나머지 모든 토큰 | 합계 5% |
표 2.12.1 — 실제 모델에서는 어휘의 모든 토큰이 한 행씩을 차지합니다. 여기서는 일부만 보입니다.
이 목록에서 하나를 뽑는 단계가 샘플링, 뽑는 규칙이 디코딩 전략(decoding strategy)입니다. 뽑힌 토큰이 텍스트에 붙고 같은 과정이 반복됩니다(2.3 참조). Top-k와 Top-p는 모두 "이 확률 목록에서 어느 토큰을 뽑을 것인가"라는 하나의 질문에 대한 답입니다.
두 극단은 각각 문제가 있습니다.
| 방식 | 규칙 | 장점 | 단점 |
|---|---|---|---|
| 탐욕적 디코딩(Greedy Decoding) | 항상 최고 확률 토큰(위 예에서는 mat) |
단순하고 빠름 | 변화가 전혀 없음. 같은 질문에 같은 답, I think that I think that ... 같은 반복 루프에 빠질 수 있음. 매 단계의 최선이 전체적으로 가장 자연스러운 문장은 아님 |
| 순수 샘플링(Pure Sampling) | 어휘 전체에서 확률대로 무작위 추첨 | 답마다 변화가 있음 | 꼬리의 나쁜 토큰이 뽑힘 |
순수 샘플링의 문제는 구체적입니다. 100장의 추첨권에 mat 40장, floor 25장, sofa 15장, bed 10장, roof 5장이 배정되고, 나머지 5장을 수천 개의 다른 토큰이 나눠 가집니다. 각 토큰의 확률은 아주 작지만 수가 워낙 많아서 합치면 5%의 확률로 그중 하나가 뽑히고, The cat sat on the banana나 The cat sat on the democracy 같은 엉뚱한 문장이 나옵니다. 응답은 수백 토큰이므로 엉뚱한 토큰 하나가 뽑히면 모델은 그 위에 나머지 문장을 쌓아 응답 전체가 궤도를 벗어납니다. 다양성은 유지하되 꼬리의 나쁜 토큰은 잘라 내는 방법이 필요하며, 그것이 Top-k입니다.
고객 시스템에서 응답이 지루하게 반복된다면 탐욕적 쪽으로, 가끔 맥락에 없는 단어가 튀어나온다면 꼬리가 열린 쪽으로 쏠려 있는 것이므로 샘플링 설정부터 살핍니다.
2.12.2 Top-k 샘플링과 그 한계
Top-k 샘플링은 확률 상위 k개 토큰만 남기고 나머지를 버린 뒤 그 k개 안에서 무작위로 뽑는 디코딩 전략입니다. 목록을 고정 크기 k로 줄여 그 짧은 목록에서만 추첨합니다. 식당 비유로, 탐욕적 웨이터는 늘 1위 요리를 고르고 순수 샘플링 웨이터는 아무도 주문하지 않는 요리까지 메뉴 전체에서 고르며, Top-k 웨이터는 가장 인기 있는 3개 요리 중에서만 고릅니다. k는 모델이 학습하는 값이 아니라 사람이 정하는 설정이며, 흔한 값은 10에서 50 사이입니다.
The cat sat on the에서 k = 3으로 계산해 봅니다.
- 확률이 높은 순으로 정렬합니다.
- 상위 k개만 남깁니다.
mat(40%),floor(25%),sofa(15%)를 남기고 나머지는 버립니다. - 남은 확률을 합 100%로 다시 맞춥니다(재정규화, renormalization). 세 토큰의 합이 80%이므로 각각을 80으로 나눕니다.
- 새 확률로 무작위 추첨합니다.
| 토큰 | 원래 확률 | 새 확률 |
|---|---|---|
| mat | 40% | 40 ÷ 80 = 50% |
| floor | 25% | 25 ÷ 80 = 31.25% |
| sofa | 15% | 15 ÷ 80 = 18.75% |
mat은 절반, floor는 약 3분의 1, sofa는 약 5분의 1의 확률로 뽑히고 banana와 democracy는 절대 뽑히지 않습니다. 구현의 핵심은 세 줄입니다.
top_values, top_indices = torch.topk(logits, k)   # 상위 k개 점수와 위치
probs = torch.softmax(top_values, dim=-1)         # k개만 Softmax = 재정규화
chosen = torch.multinomial(probs, num_samples=1)  # 추첨
k개의 점수에만 Softmax를 적용하는 것은 전체에 Softmax를 적용한 뒤 상위 k개를 다시 맞추는 것과 결과가 같으므로 재정규화가 덤으로 따라옵니다.
그러나 k는 상황과 무관하게 고정되어 있고 상황은 토큰마다 변합니다.
| 상황 | 분포 | k = 3의 문제 |
|---|---|---|
The capital of France is |
Paris 95%, the 2%, a 1%, located 1%, 나머지 1% | 답이 분명한데 약한 후보 the, a까지 k가 세 개를 요구해서 포함됨. 가끔 The capital of France is the처럼 좋지 않은 시작이 나옴 |
My favourite colour is |
blue 12%, red 11%, green 11%, black 10%, purple 10%, yellow 9%, white 9%, pink 8%, 나머지 20% | 좋은 후보 black, purple, yellow가 똑같이 좋은데도 잘려 나감. 답이 제한적으로 느껴짐 |
같은 k = 3이 첫 상황에서는 너무 많고 둘째 상황에서는 너무 적습니다. 고정된 k는 모델의 확신도에 적응하지 못합니다. 고객이 top_k=3 같은 값을 쓰고 있다면 질문 유형이 섞여 있는 서비스에서 왜 한쪽은 어색하고 한쪽은 답이 빈약한지의 원인으로 의심합니다.
2.12.3 Top-p(nucleus) 샘플링
Top-p 샘플링은 확률의 합이 p 이상이 되는 가장 작은 상위 토큰 집합만 남기고 나머지를 버린 뒤 그 집합에서 무작위로 뽑는 방식입니다. "3개를 남겨라" 대신 "확률 90%를 덮을 만큼만 남겨라"라고 말합니다. 핵 샘플링(Nucleus Sampling)이라고도 하며, 핵은 중심이라는 뜻으로 남긴 소집단이 목록의 중심이기 때문에 붙은 이름이고, 2019년 논문 "The Curious Case of Neural Text Degeneration"에서 소개되었습니다. 식당 비유로 전 주문의 90%를 차지하는 요리만 보는 웨이터는, 거의 모두가 한 요리를 시키는 날에는 요리 하나만, 주문이 흩어진 날에는 여러 요리를 봅니다. p는 0과 1 사이에서 사람이 정하며 흔한 값은 0.9에서 0.95입니다. 집합의 크기가 고정되지 않고 모델이 확신하면 작아지고 불확실하면 커지는 것이 Top-k와의 핵심 차이입니다.
The cat sat on the에서 p = 0.9로 계산하면 다음과 같습니다.
| 토큰 | 확률 | 누적 합 |
|---|---|---|
| mat | 40% | 40% |
| floor | 25% | 65% |
| sofa | 15% | 80% |
| bed | 10% | 90% |
누적 합이 bed에서 90%에 닿으므로 거기서 멈춥니다. mat, floor, sofa, bed 네 개를 남기고 roof와 나머지는 버립니다. 네 토큰의 합이 90%이므로 각각을 90으로 나눠 재정규화합니다(python3 -I로 재계산).
| 토큰 | 새 확률 |
|---|---|
| mat | 40 ÷ 90 = 44.4% |
| floor | 25 ÷ 90 = 27.8% |
| sofa | 15 ÷ 90 = 16.7% |
| bed | 10 ÷ 90 = 11.1% |
같은 p = 0.9가 Top-k가 어려워한 두 상황에서 어떻게 작동하는지 봅니다.
The capital of France is:Paris하나가 95%로 90%를 넘으므로Paris만 남고 약한the,a는 버려집니다. 집합 크기는 1입니다.My favourite colour is: 여덟 색의 누적 합이 12, 23, 34, 44, 54, 63, 72, 80%로 80%에 머뭅니다. 그래서pink아래 토큰들을 더 포함해 90%에 닿을 때까지 계속하고, 좋은 색은 모두 목록에 남습니다.
같은 p가 한 상황에서는 토큰 하나, 다른 상황에서는 많은 토큰을 남겼으며 집합 크기가 모델의 확신도에 맞춰 스스로 조절되었습니다. 구현은 확률을 내림차순으로 정렬하고 누적 합을 구한 뒤, 현재 토큰 직전의 누적 합이 이미 p 이상이면 그 토큰의 확률을 0으로 만들어 p에 도달하게 한 토큰까지 남기고 이후를 제거합니다. 그다음 남은 확률의 합으로 나누어 재정규화하고 추첨합니다.
probs = torch.softmax(logits, dim=-1)
sorted_probs, sorted_idx = torch.sort(probs, descending=True)
before = torch.cumsum(sorted_probs, dim=-1) - sorted_probs  # 이 토큰 직전 누적 합
sorted_probs[before >= p] = 0.0                              # 이미 p 도달 -> 제거
sorted_probs = sorted_probs / sorted_probs.sum()             # 재정규화
모델이 확신할 때는 후보를 거의 1개로 좁히고 모를 때는 폭넓게 열어 두므로, 질문 유형이 섞인 서비스에서 Top-p가 더 무난한 선택입니다.
2.12.4 Top-k vs Top-p
| 비교 축 | Top-k | Top-p |
|---|---|---|
| 고정하는 것 | 남길 토큰의 수 | 덮을 확률의 합 |
| 남는 집합 크기 | 항상 정확히 k | 토큰마다 변함 |
| 모델이 크게 확신할 때 | 여전히 k개를 남겨 일부는 약한 토큰 | 아주 적게 남김, 때로는 하나 |
| 모델이 불확실할 때 | 여전히 k개만 남겨 좋은 후보를 자름 | 많이 남김 |
| 다른 이름 | 없음 | 핵 샘플링 |
| 흔한 값 | 10~50 | 0.9~0.95 |
| 계산량 | 적음(상위 k개만 찾음) | 많음(전체를 정렬하고 누적 합을 유지) |
확신이 있는 과제에서는 Top-p가 약한 토큰을 걸러 주고, 불확실한 과제에서는 좋은 후보를 보존합니다. 대신 Top-k가 계산이 가볍다는 장점이 있고, 많은 LLM API가 Top-p를 설정으로 노출하는 반면 Top-k는 항상 제공되지는 않습니다. 확신이 서지 않을 때는 Top-p가 더 안전한 기본값입니다. 설정을 고를 때 두 방식은 같은 문제(꼬리 제거)를 서로 다른 기준(개수 대 확률 합)으로 푸는 것임을 설명하면 고객의 선택이 쉬워집니다.
2.12.5 온도와 함께 쓰기
온도도 출력의 무작위성을 조절하는 설정입니다. 온도는 점수를 확률로 바꾸기 전에 나눠서 확률의 모양을 바꿉니다. 0.2처럼 낮으면 1등이 더 두드러져 확률이 뾰족해지고, 1.5처럼 높으면 토큰들이 가까워져 확률이 평평해집니다(2.11 참조). Top-k와 Top-p는 확률의 모양은 그대로 두고 목록만 자릅니다. 그래서 역할이 다릅니다.
- 온도는 확률이 얼마나 뾰족한지 평평한지를 정합니다.
- Top-k와 Top-p는 목록에 몇 개의 토큰이 남는지를 정합니다.
셋을 함께 쓸 수 있고, 모델 내부에서는 보통 다음 순서로 적용됩니다.
점수 → 온도 → Top-k → Top-p → 확률로 변환 → 토큰 하나 선택
먼저 온도가 점수의 모양을 바꾸고, Top-k가 목록을 k개로 자르고, 필요하면 Top-p가 더 자르고, 마지막으로 남은 것에서 추첨합니다. 원문은 많은 도구가 기본값으로 k = 50, p = 0.95를 둔다고 설명합니다(2026년 9월 글 기준). 실제 기본값은 도구마다 달라서, 예를 들어 Hugging Face의 기본 top_k는 50이지만 top_p는 1.0이므로 사용하는 도구의 문서에서 확인해야 합니다. API를 호출할 때는 프롬프트와 함께 top_k, top_p, temperature를 설정으로 넘기며 샘플링 코드를 직접 쓸 필요는 없습니다. 위에서 본 코드가 이 설정 뒤에서 돕니다.
두 극단은 같은 생각의 양쪽 끝입니다. k를 아주 크게 하거나 p를 1.0으로 두면 필터가 아무 일도 하지 않아 순수 샘플링으로 돌아가고, k = 1이거나 p가 0에 아주 가까우면 1등 토큰만 살아남아 탐욕적 디코딩으로 돌아갑니다. Top-k와 Top-p는 그 사이의 임의 지점을 고르게 해 줍니다.
| 용도 | 권장 설정 |
|---|---|
| 정답이 정확해야 하는 과제(사실 질문, 코드 작성, 문서 요약) | 작은 k(예: 10) 또는 p(예: 0.9), 낮은 온도. 모델이 모험을 하면 안 됨 |
| 창의적 과제(이야기, 시) | 큰 k(예: 50) 또는 p(예: 0.95), 약간 높은 온도 |
| 확신이 없을 때 | Top-p. 토큰마다 스스로 조절되므로 더 안전한 기본값 |
고객에게 설정을 권할 때는 온도와 Top-p를 한 번에 하나씩 바꿔 가며 효과를 구분하고(2.11.5 참조), 확신이 없다면 Top-p부터 조정하도록 안내합니다.
2.13 정지 토큰(Stop Token)
정지 토큰은 LLM 어휘 안의 특별한 토큰으로, "여기서 텍스트가 끝난다"를 뜻하며 모델이 이 토큰을 내면 생성 루프가 쓰기를 멈춥니다. 이 절은 2026년 10월 글 기준으로 모델이 어떻게 멈추는지, 멈추지 않을 때 무엇이 막아 주는지, 현장에서 흔히 틀리는 지점이 어디인지를 설명합니다.
2.13.1 정지가 필요한 이유와 정지 토큰 학습
토큰은 LLM이 읽고 쓰는 작은 텍스트 조각으로, 단어 전체, 단어의 일부, 글자 하나, 공백, 문장부호가 될 수 있습니다. I love learning.은 ["I", " love", " learning", "."]로 쪼개지며, love 앞 공백이 토큰의 일부로 포함되어 한 단어가 끝나고 다음 단어가 시작되는 위치를 모델이 파악합니다. 모든 토큰에는 번호가 붙어 있고 모델은 텍스트가 아니라 이 번호를 다루며, 모델이 아는 토큰 전체 목록이 어휘(vocabulary)입니다. 일련번호가 붙은 큰 사전으로 이해하면 됩니다(2.4 참조).
LLM은 답을 한 번에 쓰지 않고 토큰을 하나씩 씁니다. 모델에게 주는 텍스트가 프롬프트이고, The capital of India is에서 시작하면 다음과 같이 진행됩니다.
The capital of India is를 보고New를 고릅니다.The capital of India is New를 보고Delhi를 고릅니다.The capital of India is New Delhi를 보고.을 고릅니다.
매 단계에서 지금까지의 전체 텍스트를 보고 어휘의 모든 토큰에 점수를 매기며, 그 점수에 따라 토큰 하나가 뽑혀 텍스트에 붙습니다(2.12 참조). 이 반복이 자기회귀 생성이며, 모델이 자기 출력을 다시 입력으로 되먹이는 구조입니다(2.3 참조).
tokens = tokenize(prompt)
while True:
    next_token = model.predict_next(tokens)
    tokens.append(next_token)
이 루프에는 출구가 없습니다. 아무것도 "다 끝났다"고 말하지 않으므로 New Delhi. 뒤에도 토큰을 계속 골라 델리의 역사, 날씨, 전혀 다른 이야기를 쓰기 시작하며 스스로는 멈추지 않습니다. 멈추게 하는 방법은 둘입니다.
| 방법 | 장점 | 한계 |
|---|---|---|
| 고정 한도(예: 100토큰 후 정지) | 단순함 | 답이 5토큰이면 95토큰의 쓰레기를 만들어 시간과 비용을 낭비. 답이 200토큰이면 중간에 잘림 |
| 모델 스스로 "끝났다" 선언 | 모델은 답이 언제 완결되는지 앎 | 선언할 수단이 필요함 |
그 수단이 정지 토큰(Stop Token)입니다. 이것은 "텍스트가 여기서 끝난다"를 뜻하는 특수 토큰으로 일반 단어도 아니고 우리가 읽는 답의 일부도 아닙니다. 모델이 답이 완결되었다고 판단할 때 내는 보이지 않는 표지입니다. 마침표 .가 문장을 끝낸다면 정지 토큰은 응답 전체를 끝냅니다. 모델마다 이름이 다릅니다(2026년 10월 글 기준).
| 토큰 | 사용 모델 |
|---|---|
<|endoftext|> |
GPT-2와 많은 구형 모델 |
</s> |
Llama 2와 그 위에 만든 많은 모델 |
<|eot_id|> |
Llama 3 |
<|im_end|> |
Qwen과 여러 챗 모델 |
<end_of_turn> |
Gemma |
이름은 중요하지 않고, 자기 번호를 가진 어휘 속 토큰 하나이며 생성 루프가 정지 신호로 다룬다는 점이 중요합니다. 많은 사람이 EOS 토큰(End Of Sequence, 시퀀스는 텍스트 한 덩어리)이라고도 부르며, 정지 토큰과 EOS 토큰은 흔히 같은 뜻으로 쓰입니다(2.4.4 참조). 루프에 검사 한 줄이 추가됩니다.
while True:
    next_token = model.predict_next(tokens)
    if next_token == STOP_TOKEN:
        break                # 정지 토큰은 리스트에 추가하지 않으므로 최종 텍스트에 나타나지 않음
    tokens.append(next_token)
print(detokenize(tokens))
예제를 다시 따라가면 1단계 New, 2단계 Delhi, 3단계 ., 4단계 <|endoftext|>에서 루프가 멈추고 사용자에게는 The capital of India is New Delhi.가 보입니다. 정지 토큰도 다른 토큰처럼 매 단계 점수를 받습니다. 1단계에서는 The capital of India is가 분명히 미완이므로 아주 낮은 점수를 받고, 4단계에서는 답이 완결되었으므로 최고 점수를 받습니다.
모델은 "질문에 답한 뒤 멈춰라" 같은 규칙을 받지 않고 데이터에서 배웁니다. LLM은 기사, 책, 웹 페이지, 코드 파일, 대화 같은 수많은 개별 문서로 학습하며, 학습 전에 모든 문서 끝에 정지 토큰이 붙습니다.
이것은 문서 1의 전체 텍스트입니다. <|endoftext|>
이것은 문서 2의 전체 텍스트입니다. <|endoftext|>
학습 중 모델의 일은 지금까지의 텍스트를 보고 다음 토큰을 맞추는 것 하나이며, 틀리면 조금씩 교정됩니다. 문서 끝에서는 지금까지의 텍스트가 문서 전체이고 정답 다음 토큰이 정지 토큰이므로, 못 맞출 때마다 교정되어 모델은 점차 "이야기가 끝났다, 질문에 답했다, 코드 파일이 닫혔다"처럼 텍스트가 완결된 느낌일 때 다음 토큰이 정지 토큰일 가능성이 높다는 패턴을 익힙니다. 정지 토큰은 한 문서의 끝과 다음 문서의 시작을 가르는 표시이기도 해서, 그 뒤의 텍스트가 새 시작임을 배웁니다. 수천 편의 이야기를 들은 아이가 "그리고 그들은 행복하게 살았답니다" 뒤에 책을 덮는다는 것을 아는 것과 같고, 아무도 규칙을 직접 가르치지 않았습니다. 모델이 스스로 멈출 수 있는 것은 수많은 끝맺음을 보고 끝맺음의 모양을 배웠기 때문입니다. 정지 토큰은 고정 규칙이 아니라 학습된 행동입니다.
그래서 FDE는 "모델이 왜 답을 끝내지 않습니까"라는 문제를 만나면 코드 규칙이 빠진 것이 아니라 학습 또는 설정의 문제인지부터 가려 봅니다.
2.13.2 정지 토큰 vs 정지 시퀀스
두 용어는 자주 혼동되지만 같지 않습니다. 정지 토큰은 어휘에 내장된 특수 토큰 하나이며 모델이 학습으로 내는 것입니다. 정지 시퀀스(Stop Sequence)는 모델의 사용자인 우리가 시스템에게 지켜보라고 요청하는 임의의 텍스트이며, 그 텍스트가 출력에 나타나면 생성이 멈춥니다. 대부분의 API는 정지 시퀀스 목록을 받습니다.
response = client.completions.create(
    model="some-model",
    prompt="Q: What is 2 + 2?\nA:",
    stop=["\n", "Q:"]      # 줄바꿈이나 "Q:"가 나오면 그 자리에서 정지
)
모델은 정지 시퀀스를 전혀 모릅니다. 평소처럼 토큰을 계속 내고, 모델을 둘러싼 시스템이 토큰마다 출력을 검사해 일치하면 생성을 끊습니다. 필요한 이유는 모델이 우리가 원하는 곳에서 정지 토큰을 내지 않는 경우가 있기 때문입니다. 위 예에서 정지 시퀀스가 없으면 모델은 4라고 답한 뒤 계속해서 Q: What is 3 + 3?을 스스로 쓰기 시작하곤 합니다. 학습 데이터에서 질문과 답의 목록은 보통 더 많은 질문으로 이어지므로 패턴을 이어 가는 것이며, 정지 토큰이 높은 점수를 받지 못합니다. "Q:"라는 정지 시퀀스가 이를 잡아 멈춥니다.
while True:
    next_token = model.predict_next(tokens)
    if next_token == STOP_TOKEN:
        break
    tokens.append(next_token)
    text = detokenize(tokens)
    if ends_with_any(text, stop_sequences):   # 토큰을 붙일 때마다 텍스트 끝을 검사
break| 비교 축 | 정지 토큰 | 정지 시퀀스 |
|---|---|---|
| 정체 | 어휘 속의 특수 토큰 하나 | 우리가 고른 임의의 텍스트 |
| 정하는 주체 | 모델 학습 때 정해짐 | 사용 시점에 우리가 정함 |
| 만드는 주체 | 모델 자신 | 모델은 존재를 모름 |
| 검사하는 주체 | 생성 루프 | 모델을 둘러싼 코드 |
| 출력에 표시 | 안 됨(제거됨) | 대개 출력에서 제거됨 |
| 예 | </s>, <end_of_turn> |
"\n", "Q:", "###" |
실제로는 둘이 함께 작동합니다. 정지 토큰은 항상 켜져 있고 정지 시퀀스는 용도에 따라 추가하는 검사입니다. 고객 파이프라인이 JSON이나 특정 구분자로 출력을 끊어야 한다면 정지 시퀀스로 구분자를 지정할 수 있다는 점을 안내합니다.
2.13.3 모델이 멈추지 않을 때
모델이 정지 토큰을 내지 않고 정지 시퀀스도 나타나지 않는 나쁜 경우가 있습니다. 같은 구절을 계속 반복하는 루프에 빠졌거나, 학습이 부실한 모델이거나, 프롬프트가 지나치게 특이해서 모델이 텍스트가 완결되었다고 느끼지 못할 때입니다. 정지 토큰에만 의지하면 생성이 영원히 돌아 시간, 메모리, 비용을 낭비합니다. 앞서 한 번 물리친 고정 한도가 비상용 백업으로 돌아옵니다.
그래서 모든 시스템은 최대 토큰 한도(max_tokens 또는 max_new_tokens)를 함께 둡니다.
generated = 0
while generated < max_tokens:
    next_token = model.predict_next(tokens)
    if next_token == STOP_TOKEN:
        break
    tokens.append(next_token)
    generated += 1
    if ends_with_any(detokenize(tokens), stop_sequences):
        break
생성은 다음 셋 중 먼저 일어나는 일로 멈춥니다.
| 브레이크 | 성격 |
|---|---|
| 정지 토큰 | 자연스러운 브레이크 |
| 정지 시퀀스 | 우리가 추가하는 브레이크 |
| 최대 토큰 한도 | 비상 브레이크 |
대부분의 API는 어느 브레이크가 작동했는지 finish_reason 또는 stop_reason으로 알려 줍니다. stop이나 end_turn은 모델이 정지 토큰으로 스스로 끝냈거나 정지 시퀀스가 발견되었다는 뜻이고, length나 max_tokens는 한도가 끊었다는 뜻입니다. length가 너무 자주 보인다면 한도가 작아 답이 중간에서 잘리는 것이므로 한도를 늘려야 합니다. 고객이 "답이 문장 중간에서 끊깁니다"라고 하면 응답의 finish_reason을 먼저 확인하는 것이 가장 빠른 진단입니다.
2.13.4 챗 모델의 정지 토큰
AI 어시스턴트는 자기 차례가 끝났음을 어떻게 알까요. 대화는 화자를 표시하는 특수 토큰으로 서식이 입혀집니다. 단순화한 형태는 다음과 같습니다.
<|user|>
What is the capital of India?
<|end|>
<|assistant|>
The capital of India is New Delhi.
<|end|><|user|>, <|assistant|>는 화자를 표시하고 <|end|>는 한 턴의 끝을 표시하며, 셋 모두 앞서 본 정지 토큰처럼 어휘 속의 특수 토큰입니다. 학습 중 모델은 이 서식의 대화를 많이 보고, 어시스턴트의 모든 응답이 <|end|>로 끝납니다. 그래서 응답이 끝났다고 느끼면 <|end|>를 내고, 시스템이 그 토큰을 보고 생성을 멈추고 토큰을 제거한 뒤 응답을 보여 주며, 사용자의 다음 메시지를 기다립니다(2.2.4 참조). 이 챗 모델에서는 <|end|>가 정지 토큰이고, Llama 3에서는 <|eot_id|>, Qwen에서는 <|im_end|>로 아이디어는 같습니다.
일부 모델은 정지 토큰이 둘 이상입니다. Llama 3는 문서의 끝을 <|end_of_text|>로, 챗에서 한 턴의 끝을 <|eot_id|>로 표시하며, 둘 다 정지 신호로 다뤄집니다. 챗 모델이 계속 떠들지 않고 우리의 다음 질문까지 대신 쓰지 않는 이유는 자기 차례가 이 토큰으로 끝난다고 배웠기 때문입니다. 자체 호스팅 모델을 올릴 때는 해당 모델이 쓰는 정지 토큰 전체 목록을 확인해야 합니다.
2.13.5 흔한 실수
- 실수 1, 모델에 맞지 않는 정지 토큰 사용: 모델을 내려받아 자기 기계에서 돌릴 때는 모델이 학습된 정지 토큰을 써야 합니다. 모델이
<|eot_id|>로 턴을 끝내는데 설정이</s>를 기다리면, 모델은<|eot_id|>를 내도 설정이 알아보지 못해 계속 진행하고 사용자의 다음 메시지를 스스로 쓰기 시작합니다. 원문은 Llama 3 출시 때 많은 사람이 정확히 이 문제를 겪었다고 전하며, 해법은 생성 설정에 올바른 정지 토큰을 지정하는 것입니다. - 실수 2, 최대 토큰 한도를 너무 작게 설정: 답이 문장 중간에서 잘리고 모델은 정지 토큰을 낼 기회를 얻지 못합니다.
finish_reason을 항상 확인하고length이면 한도를 늘립니다. - 실수 3, 파인튜닝 데이터에서 정지 토큰 누락: 파인튜닝(Fine-tuning)은 이미 학습된 모델을 우리 데이터로 조금 더 학습시키는 일입니다(2.2.4 참조). 모든 학습 예제가 정지 토큰으로 끝나야 하며 빠뜨리면 모델이 우리 데이터 유형에서 언제 멈춰야 하는지 배우지 못해, 파인튜닝 후 모든 답 뒤에 계속 중얼거립니다.
- 실수 4, 정지 토큰이 사용자에게 보임: 토큰을 텍스트로 되돌리는 코드가 특수 토큰을 제거하지 않으면 사용자가 모든 답 끝에서
<|endoftext|>나</s>를 봅니다. 대부분의 도구에skip_special_tokens=True같은 옵션이 있으며 켜져 있는지 확인해야 합니다.
현장 점검표로 쓰면 다음과 같습니다. 모델이 계속 떠든다면 정지 토큰 불일치(실수 1)나 파인튜닝 데이터의 누락(실수 3)을, 답이 끊기면 finish_reason과 한도(실수 2)를, 화면에 이상한 태그가 보이면 특수 토큰 출력 옵션(실수 4)을 순서대로 확인합니다.
2.14 로그 확률(Logprobs)
원문: What are Log Probabilities (Logprobs) in LLMs?
LLM은 토큰을 하나 고를 때마다 "얼마나 확신했는지"를 숫자로 가지고 있으며, API는 이 숫자를 로그 확률(logprob)이라는 형태로 내줍니다. 2026년 11월 5일 글 기준으로, 이 절은 logprob이 무엇이고 왜 확률 대신 쓰이며 실무에서 어디에 쓰이는지를 설명합니다.
2.14.1 로그와 logprob의 정의
LLM은 토큰마다 로짓(logit)이라는 원점수를 내고, Softmax가 이를 합이 1인 확률로 바꿉니다(1.12 참조). "My pet is a" 뒤에 올 토큰을 cat, dog, car 세 개로 단순화하면 다음과 같습니다.
| 토큰 | 로짓 | 확률 |
|---|---|---|
| cat | 3.64 | 0.70 |
| dog | 2.61 | 0.25 |
| car | 1.00 | 0.05 |
로그(log)는 "고정된 수(밑, base)를 몇 번 곱해야 이 수가 되는가"에 답하는 함수입니다. 밑이 10이면 100의 로그는 2, 1000의 로그는 3이고, 0.1은 1/10이므로 로그가 -1입니다. LLM에서는 밑이 e(약 2.718)인 자연로그 ln을 씁니다. 이 절에서 필요한 로그의 성질은 세 가지입니다.
- 1의 로그는 0입니다.
- 0과 1 사이 수의 로그는 음수이며, 수가 작을수록 더 큰 음수가 됩니다.
- 곱셈이 덧셈으로 바뀝니다.
log(a × b) = log(a) + log(b)
logprob은 확률에 자연로그를 취한 값입니다(logprob = ln(probability)). 확률은 1을 넘지 않으므로 logprob은 항상 0 이하이며 양수가 될 수 없습니다. 정확히 0이면 확률 1(완전한 확신)이고, 반대로 logprob을 확률로 되돌릴 때는 e의 거듭제곱을 취합니다.
| 확률 | logprob | 의미 |
|---|---|---|
| 1.0 | 0 | 완전히 확신 |
| 0.9 | -0.11 | 강한 확신 |
| 0.5 | -0.69 | 반반 |
| 0.25 | -1.39 | 확신 부족 |
| 0.1 | -2.30 | 불확실 |
| 0.01 | -4.61 | 거의 모름 |
| 0.001 | -6.91 | 가능성 거의 없음 |
위 세 토큰의 logprob은 cat -0.36, dog -1.39, car -3.00입니다(np.log(np.exp(logits) / np.exp(logits).sum())로 재현되며, np.log는 상용로그가 아니라 자연로그입니다). 흐름은 로짓에서 Softmax로 확률, 자연로그로 logprob입니다.
flowchart LR
    A["로짓<br/>cat 3.64, dog 2.61, car 1.00"] -->|Softmax| B["확률<br/>0.70, 0.25, 0.05"]
    B -->|자연로그| C["logprob<br/>-0.36, -1.39, -3.00"]
그림 2.14.1 — 로짓은 Softmax를 거쳐 확률이 되고, 자연로그를 거쳐 logprob이 됩니다.
로짓과 logprob은 서로 다른 값입니다. 로짓은 정규화 전 원점수이고 logprob은 정규화와 로그를 모두 거친 값이므로, API에서 받은 숫자가 어느 쪽인지 먼저 확인해야 합니다. 고객이 "모델 점수"라며 숫자를 내밀 때 그것이 로짓인지 logprob인지부터 묻는 것이 첫 번째 확인입니다.
2.14.2 문장 확률과 top logprobs
logprob을 쓰는 이유는 곱셈 문제입니다. 문장 전체의 확률은 토큰별 확률을 모두 곱한 값인데, 1보다 작은 수를 계속 곱하면 결과가 급격히 작아집니다. 0.1을 400번 곱하면 소수점 아래 0이 399개 이어진 뒤 1이 나오는 수가 되며, 일반적인 64비트 부동소수점(파이썬 float)은 대략 10의 -308제곱 부근에서 정밀도를 잃기 시작하고, 약 10의 -324제곱보다 작은 수는 0으로 처리합니다. 이 현상이 언더플로(underflow)입니다.
로그는 곱셈을 덧셈으로 바꾸므로 확률 대신 logprob을 더하면 언더플로가 생기지 않습니다. 파이썬으로 0.1을 400번 곱하면 0.0이 나오지만, ln(0.1)을 400번 더하면 -921.03입니다. 0.0은 틀린 값(진짜 값은 0이 아니라 아주 작은 수)이고 -921.03은 정확하며 저장도 쉽습니다. LLM이 학습과 출력에서 logprob을 쓰는 이유가 이것입니다(교차 엔트로피 손실도 정답 확률의 로그에서 만들어집니다. 1.4 참조).
예를 들어 프롬프트가 "I love"이고 LLM이 "to read books"를 썼다고 하겠습니다.
| 토큰 | 확률 | logprob |
|---|---|---|
| to | 0.5 | -0.69 |
| read | 0.2 | -1.61 |
| books | 0.6 | -0.51 |
- 확률을 곱하면
0.5 × 0.2 × 0.6 = 0.06입니다. - logprob을 더하면
-0.69 + (-1.61) + (-0.51) = -2.81입니다. e^(-2.81)은 다시 0.06이므로 두 방식은 같은 정보를 담습니다.
top logprobs는 선택된 토큰만이 아니라 그 시점에서 가능성이 높았던 상위 몇 개 후보의 logprob입니다. "My pet is a"에서 LLM이 cat을 골랐다면 dog(-1.39)는 강한 2순위였고 car(-3.00)는 약한 3순위였다는 사실까지 알 수 있습니다. 많은 LLM API가 두 옵션을 제공합니다.
logprobs:true로 두면 생성한 모든 토큰의 logprob을 받습니다.top_logprobs:3처럼 숫자를 주면 매 단계의 상위 3개 후보도 함께 받습니다.
응답은 토큰마다 token, logprob, 그리고 후보 목록 top_logprobs(각 항목이 token과 logprob)를 담은 구조입니다. 문장 단위 점수가 필요한 평가 파이프라인에서는 logprob을 더한다는 한 가지 규칙만 기억하면 됩니다.
2.14.3 신뢰도 추정과 분류에 쓰기
logprob을 확률로 되돌리려면 e의 거듭제곱을 취합니다(probability = e^(logprob)). -0.11은 확률 0.9, 즉 90퍼센트 확신이고 -2.30은 0.1, 즉 10퍼센트 확신입니다. 긴 답변은 모든 토큰의 평균 logprob을 보면 되며, 이를 이용해 모델이 확신하는 답은 사용자에게 바로 보여주고 확신이 낮은 답은 사람이 검토하도록 분기할 수 있습니다.
분류에도 쓸 수 있습니다. 리뷰가 긍정인지 부정인지를 "Positive 또는 Negative 한 단어로만 답하라"고 시킨 뒤 첫 토큰의 top 2 logprob을 읽습니다.
| 토큰 | logprob | 확률 |
|---|---|---|
| Positive | -0.05 | 0.95 |
| Negative | -3.00 | 0.05 |
라벨만이 아니라 점수도 얻게 되므로 "확률이 0.8을 넘을 때만 자동 수용하고 나머지는 검토로 보낸다"는 임계값 정책을 세울 수 있습니다. 이 확률은 모델 내부의 확신이며 정답률과 같지 않습니다. 임계값은 고객의 실제 정답 데이터로 보정해야 하고, 보정 없이 0.8을 그대로 쓰면 자동 수용 구간의 오류율을 알 수 없습니다.
2.14.4 퍼플렉시티(Perplexity)
퍼플렉시티(Perplexity)는 모델이 어떤 텍스트에 얼마나 놀라는지를 재는 값이며, 낮을수록 모델이 그 텍스트를 자연스럽게 여깁니다. 평균 logprob의 부호를 뒤집어 지수를 취합니다(perplexity = e^(-평균 logprob)). "to read books"로 계산해 보겠습니다.
- logprob을 더합니다.
-0.69 + (-1.61) + (-0.51) = -2.81 - 토큰 수 3으로 나눕니다. 평균은 약 -0.94입니다.
- 부호를 뒤집어 0.94를 얻습니다.
e^0.94를 계산하면 약 2.56입니다.
원문은 2.56으로 적었으며, 반올림 전 값(-2.8134 / 3)으로 계산하면 약 2.55입니다. 해석은 같습니다. 모델은 매 단계에서 평균적으로 약 2.5개의 똑같이 그럴듯한 토큰 사이에서 고르는 정도로 불확실했습니다. 모든 토큰을 완전히 확신했다면 퍼플렉시티는 1입니다.
같은 텍스트에서 여러 언어 모델을 비교할 때 퍼플렉시티가 낮은 모델이 텍스트를 더 잘 예측한 것입니다. 서로 다른 텍스트나 서로 다른 토큰화 방식 사이의 숫자를 직접 비교할 수는 없으므로, 모델 후보 평가에서는 같은 고객 데이터와 같은 토큰화 조건에서 재야 합니다(2.4 참조).
2.14.5 환각 위험 탐지
환각(hallucination)은 그럴듯하지만 틀린 내용을 쓰는 현상입니다(2.18 참조). "에펠탑은 1889년에 지어졌다"에서 1889 토큰의 logprob이 -0.02이면(확률 약 0.98) 모델이 확신한 것이고, -2.5이면(확률 약 0.08) 불확실했으며 top logprobs에는 근처 연도가 바짝 뒤따르고 있을 것입니다.
이름, 날짜, 숫자처럼 중요한 토큰의 logprob이 크게 낮으면 경고 신호입니다. 다만 두 방향의 한계가 있습니다.
- 낮은 logprob은 답이 틀렸다는 증명이 아닙니다.
- 높은 logprob도 답이 맞다는 보증이 아닙니다. 확신하고 틀리는 경우가 있습니다.
그래서 logprob은 "어디를 확인해야 하는가"를 가려내는 필터로 쓰고, 정오 판정은 별도 검증(근거 문서 대조 등)에 맡깁니다. 고객 화면에 낮은 logprob 토큰을 강조 표시하는 것만으로도 검수자가 볼 위치가 크게 줄어듭니다.
2.14.6 강화학습 학습에서의 쓰임
강화학습(RL)에서 LLM은 보상으로 학습합니다(1.14 참조). 좋은 답에는 양의 보상, 나쁜 답에는 음의 보상이 주어집니다. 정책 경사(policy gradient) 방식은 답을 구성한 토큰들의 logprob을 보상 방향으로 밀어 올리거나 내립니다.
- 보상이 양수이면 그 답의 토큰 logprob을 높여 비슷한 답이 더 자주 나오게 합니다.
- 보상이 음수이면 그 토큰 logprob을 낮춰 비슷한 답이 덜 나오게 합니다.
가장 단순한 형태의 목표는 보상 × (답안 토큰 logprob의 합)을 최대로 만드는 것입니다. "to read books"가 +1 보상을 받으면 to, read, books의 logprob이 함께 올라갑니다.
또한 학습된 모델이 원래 모델에서 얼마나 멀어졌는지는 같은 토큰에 대한 두 모델의 logprob을 비교해 잽니다. 이 비교가 학습이 모델을 지나치게 바꾸지 않도록 붙잡아 줍니다(11.6 참조). FDE는 이 용도를 직접 계산할 일이 드물지만, 고객 팀이 "정책 모델과 기준 모델의 logprob 차이"를 말할 때 그것이 학습 안정성 장치라는 점을 알면 됩니다.
2.15 토큰 스트리밍(Token Streaming)
원문: How does Token Streaming work?
챗봇 화면에서 답이 타자 치듯 나타나는 효과는 모델이 토큰을 하나씩 만든다는 사실과, 서버가 열어 둔 연결로 그것을 바로 흘려보내는 방식이 만나서 생깁니다. 2026년 6월 글 기준으로, 이 절은 스트리밍이 필요한 이유부터 전송 형식과 종료 표지까지의 전체 경로를 설명합니다.
2.15.1 스트리밍이 필요한 이유
토큰 스트리밍(Token Streaming)은 서버가 모델의 답이 완성될 때까지 기다리지 않고, 조각이 만들어지는 대로 사용자에게 보내는 기법입니다. 스트리밍이 가능한 근거는 LLM이 답을 한 번에 쓰지 않는다는 점입니다. LLM은 지금까지의 모든 토큰을 보고 다음 토큰 하나를 쓰는 과정을 되풀이하며, 이를 자기회귀 디코딩(autoregressive decoding)이라 합니다(2.3 참조). "auto"는 스스로 단계를 밟는다는 뜻이고 "regressive"는 매 단계가 앞서 쓴 것을 돌아본다는 뜻입니다. 그래서 문장은 다음처럼 한 토큰씩 자라고, 완성은 마지막 단계에야 옵니다.
Step 1: The
Step 2: The cat
Step 3: The cat sat
토큰을 하나씩 만드는 모델이라면 선택지가 둘입니다. 전부 모아 마지막에 한꺼번에 보내거나, 만든 즉시 보내는 것입니다. 후자가 스트리밍입니다. 500토큰짜리 긴 답을 마지막에 보내면 사용자는 500토큰이 모두 생성될 때까지 빈 화면을 보고 앱이 멈췄다고 느낍니다.
여기서 핵심 지표가 첫 토큰까지의 시간(time to first token), 즉 사용자가 첫 글자를 보기까지 기다리는 시간입니다.
| 방식 | 사용자가 처음 보는 것 | 첫 토큰까지의 시간 |
|---|---|---|
| 스트리밍 없음 | 마지막 토큰이 만들어진 뒤 전체 답이 한꺼번에 | 길다(전체 생성 시간) |
| 스트리밍 | 첫 토큰이 준비된 즉시 | 짧다 |
첫 토큰까지의 시간은 주로 모델이 프롬프트 전체를 읽는 prefill 단계가 결정합니다(10.2 참조). 스트리밍은 총 생성 시간을 줄이지 않고 사용자가 읽기 시작하는 시점을 앞당깁니다. 모든 토큰이 한꺼번에 필요한 확산(diffusion) 계열 언어 모델처럼 병렬로 문장을 만드는 모델은 이 전제가 다릅니다. FDE는 고객이 "응답이 느리다"고 할 때 총 소요 시간과 첫 글자까지의 시간을 나눠 물어야 하며, 후자라면 스트리밍 적용 여부가 첫 점검 사항입니다.
2.15.2 SSE와 열린 HTTP 연결
일반적인 웹 통신은 요청-응답(request-response)입니다. 브라우저가 한 번 묻고 서버가 한 번 답한 뒤 연결이 닫힙니다. 전화를 한 통 걸어 답을 한 번 듣고 끊는 것과 같습니다. 스트리밍에는 이 모델이 맞지 않으므로 SSE(Server-Sent Events)를 씁니다. SSE는 서버가 하나의 열린 연결로 새 데이터를 계속 보내는 방식이며, 이름 그대로 서버가 브라우저로 보내는 이벤트(작은 데이터 한 조각)입니다.
sequenceDiagram
    participant B as 브라우저
    participant S as 서버
    Note over B,S: 일반 요청-응답
    B->>S: 질문(1회)
    S-->>B: 응답(1회) 후 연결 종료
    Note over B,S: SSE
    B->>S: 질문(1회)
    S-->>B: 조각 1
    S-->>B: 조각 2
    S-->>B: 조각 3 (연결 유지)
그림 2.15.2 — 일반 요청-응답은 응답 후 연결이 닫히고, SSE는 연결을 열어 둔 채 서버가 조각을 계속 보냅니다.
브라우저는 질문을 한 번만 하고, 서버는 같은 연결로 원하는 만큼 조각을 보냅니다. 서버가 "이번 응답은 스트림이다"라고 알리는 수단이 Content-Type, 즉 응답이 어떤 종류의 데이터인지 알리는 라벨입니다. 일반 웹 페이지는 text/html, 일반 데이터 응답은 흔히 application/json이고, SSE는 다음 값을 씁니다.
Content-Type: text/event-streamstream이 핵심 단어입니다. 이 라벨을 본 브라우저는 하나의 완결된 답을 기다리지 않고 연결을 열어 둔 채 도착하는 조각을 읽는 스트리밍 모드로 들어갑니다. 따라서 연결을 열어 두는 서버 구현과 text/event-stream 라벨, 두 가지가 SSE의 전제입니다. 프록시나 게이트웨이가 응답을 버퍼링해 모아서 내보내면 스트림이 깨지므로, 고객 환경에서 스트리밍이 "한꺼번에 나온다"는 증상은 중간 장비의 버퍼링부터 의심할 수 있습니다.
2.15.3 스트림 메시지 형식과 [DONE] 종료 표지
SSE의 메시지 규칙은 단순합니다. 이벤트 하나는 data:로 시작하는 줄이며, 이벤트와 이벤트 사이는 빈 줄 하나로 구분합니다. 모델이 "The cat sat"을 만들면 서버는 다음을 보냅니다.
data: The

data: cat

data: sat
이벤트가 세 개이고, 각 이벤트 뒤의 빈 줄이 "여기서 한 이벤트가 끝난다"는 경계입니다. 설명을 위해 일반 단어로 적었지만 실제 시스템에서 data: 뒤에는 토큰과 약간의 부가 정보를 담은 JSON이 오는 경우가 보통입니다. 그래도 규칙은 같아서, 모든 토큰이 data: 줄 하나로 감싸이고 빈 줄이 뒤따릅니다. 구현할 때는 JSON을 파싱해 토큰 텍스트를 꺼내는 단계가 추가될 뿐입니다.
그렇다면 브라우저는 언제 듣기를 멈출지 어떻게 알까요. 서버가 마지막 토큰 뒤에 [DONE] 표지를 담은 이벤트를 한 번 더 보내기 때문입니다.
data: sat

data: [DONE][DONE]은 OpenAI API의 스트림이 쓰는 종료 표지입니다. Anthropic의 Claude API는 [DONE] 대신 event: message_stop처럼 이름이 붙은 이벤트로 끝을 알리며 data: 뒤는 JSON입니다. 서버마다 종료 표지의 모양은 다르지만 "끝을 알리는 이벤트가 따로 온다"는 원리는 같습니다. 여기서는 [DONE] 방식으로 설명합니다. 브라우저는 [DONE]을 읽으면 더 이상 토큰이 오지 않는다고 판단해 듣기를 멈추고 연결을 닫습니다. 이 표지가 없으면 답이 끝난 것인지 다음 토큰이 아직 오는 중인지 구분할 수 없습니다. 실제로 연결이 끊겨 답이 중간에 잘렸는데 화면에는 그대로 남는 사고는 종료 표지가 오기 전에 연결이 닫혔는지를 확인하면 잡을 수 있습니다.
2.15.4 SSE vs WebSocket
WebSocket은 브라우저와 서버 사이에 양방향 연결을 열어 두 쪽이 언제든 자유롭게 메시지를 보낼 수 있게 하는 기술입니다. SSE는 서버에서 브라우저로 가는 단방향이며, 같은 스트림으로 브라우저가 서버에 메시지를 되돌릴 수는 없습니다. 토큰 스트리밍에서는 질문을 처음 한 번 보낸 뒤로는 받기만 하면 되므로 단방향으로 충분합니다.
| 항목 | SSE | WebSocket |
|---|---|---|
| 방향 | 서버에서 브라우저로 단방향 | 양방향 |
| 기반 | 일반 HTTP | HTTP 위에 얹은 별도 규칙 |
| 설정 | 단순 | 복잡 |
| 적합한 곳 | 답 스트리밍, 실시간 갱신 | 채팅방, 게임, 실시간 협업 |
| 재연결 | 자동 | 직접 처리 |
SSE는 이미 쓰는 웹 규칙 위에서 아무것도 추가 설정하지 않고 동작하고, 연결이 끊기면 자동으로 다시 연결합니다. WebSocket은 양쪽이 동시에 자유롭게 말해야 할 때, 예를 들어 라이브 채팅방이나 멀티플레이어 게임에 씁니다. 고객이 "스트리밍이니 WebSocket을 써야 하냐"고 물으면, 응답 중에 클라이언트가 보낼 것이 없다면 SSE가 더 단순하다고 판단 기준을 줄 수 있습니다.
2.15.5 서버에서 화면까지의 전체 흐름
사용자가 질문하고 모델이 "The cat sat"을 답하는 경우를 여섯 단계로 따라가 봅니다.
- 브라우저가 서버에 HTTP 연결을 하나 열고 질문을 보냅니다. 이 연결은 답이 끝날 때까지 유지됩니다.
- 서버가 응답을 시작하며 Content-Type을
text/event-stream으로 설정합니다. - 모델이 첫 토큰
The를 만들면 서버는 기다리지 않고data:줄로 감싸 열린 연결에 바로 보냅니다. - 브라우저가
data:줄을 읽어The를 꺼내 화면에 붙입니다. 첫 글자가 거의 즉시 보입니다. - 모델이
cat을 만들고 서버가 보내면 브라우저가 이어 붙여 "The cat"이 됩니다. sat도 같은 방식으로 붙어 "The cat sat"이 되고, 마지막에data: [DONE]이 도착해 브라우저가 듣기를 멈추고 연결을 닫습니다.
flowchart LR
    M["모델<br/>토큰 The, cat, sat"] --> S["서버<br/>data: 줄로 감싸기"]
    S -->|"열린 연결 text/event-stream"| B["브라우저<br/>화면에 이어 붙이기"]
    S -->|"data: [DONE]"| E["듣기 중지, 연결 종료"]
그림 2.15.5 — 토큰은 모델에서 서버를 거쳐 하나의 열린 연결로 흐르고, 브라우저가 이어 붙이며 타자 효과를 만듭니다.
스트리밍은 모델의 생성 방식을 바꾸지 않습니다. 모델은 여전히 자기회귀 디코딩으로 한 토큰씩 쓰고, 바뀌는 것은 각 토큰이 사용자에게 가는 시점뿐입니다. ChatGPT와 Claude에서 보는 타자 효과가 이 구조이며, 코딩 어시스턴트, 글쓰기 도구, 고객 지원 봇 같은 LLM 기반 애플리케이션 전반에 같은 방식이 쓰입니다. 토큰을 빠르게 만들고 여러 사용자를 동시에 받아내는 일은 서빙 엔진의 몫입니다(10.12 참조). 음성 에이전트처럼 토큰 스트림을 다시 다른 단위로 묶어 쓰는 시스템은 이 흐름 위에서 설계됩니다(13.17 참조). 사용자는 시스템이 일하는 중임을 보고 즉시 읽기 시작하며, 이것이 단순한 시각 효과가 아니라 체감 속도 개선이라는 점이 고객 설득의 근거입니다.
2.16 컨텍스트 윈도우(Context Window)
원문: How does the Context Window work?
영상: Why is the context window limited in LLMs?
모델이 "기억하는 것처럼" 보이는 대화는 사실 매번 전체 대화를 다시 읽는 일이며, 한 번에 읽을 수 있는 분량에는 상한이 있습니다. 2026년 11월 4일 글을 기준으로, 이 절은 그 상한인 컨텍스트 윈도우의 정의, 쌓이는 방식, 가득 찼을 때의 동작, 관리 방법을 설명하고 영상 자막에서 상한이 존재하는 이유를 보탭니다.
2.16.1 컨텍스트 윈도우의 정의와 필요성
컨텍스트 윈도우(Context Window)는 모델이 답하는 동안 한 번에 읽고 기억할 수 있는 텍스트의 총량이며, 토큰 단위로 잽니다. 모델의 단기 기억이라고 생각하면 됩니다. 여기서 컨텍스트(context)는 좋은 답을 하는 데 필요한 모든 것, 즉 질문, 이전 메시지, 붙여 넣은 문서를 뜻합니다. 컨텍스트 윈도우는 모델이 지금 보고 있는 모든 텍스트를 담는 고정 크기의 공간입니다.
윈도우가 필요한 이유는 모델에게 대화의 영구 기억이 없기 때문입니다. 사용자가 "내 이름은 Amit입니다"라고 말하고, 다음 메시지에서 "내 이름이 뭐지?"라고 묻는다고 하겠습니다. 모델이 정확히 답하는 것은 두 번째 메시지를 보낼 때 대화 전체가 묶여 다시 전달되기 때문입니다. 모델은 윈도우 안에서 두 메시지를 함께 읽고 "Amit입니다"라고 답합니다.
flowchart TD
    A["메시지 2 전송"] --> W["컨텍스트 윈도우<br/>'My name is Amit.' + 'What is my name?'"]
    W --> M["모델"]
    M --> R["'Your name is Amit.'"]
그림 2.16.1 — 이전 메시지와 새 질문이 한 윈도우로 함께 모델에 전달됩니다.
대화의 기억은 모델이 아니라 매번 보내는 윈도우에 있습니다. 모델 자체는 요청 사이에 변하지 않습니다.
윈도우는 단어가 아니라 토큰으로 잽니다. 토큰은 단어 하나, 단어의 일부, 심지어 글자 하나일 수 있습니다(2.4 참조). "I love learning"은 ["I", " love", " learn", "ing"]로 쪼개져 단어 세 개가 토큰 네 개가 됩니다. 영어 기준 대략 토큰 하나가 4글자, 100토큰이 75단어이므로 8,000토큰 윈도우는 약 6,000단어(8,000 × 0.75)를 담습니다. 정확한 수는 쓰는 단어에 따라 달라지며, 이 비율은 영어 기준이므로 한국어 등 다른 언어 문서는 고객 문서로 직접 토큰 수를 세어 봐야 합니다.
윈도우 안의 토큰은 한꺼번에 읽힙니다. 모델은 각 토큰이 앞선 토큰과 어떻게 관계되는지 보며 대화 전체의 의미를 이해하고(2.9 참조), 다음 토큰을 예측하고, 그 토큰을 윈도우에 다시 넣어 또 예측합니다. 따라서 답은 한 토큰씩 만들어지며 토큰마다 윈도우 전체를 다시 읽습니다. 윈도우 안의 정보는 쓸 수 있지만 밖의 정보는 모델에게 아예 보이지 않습니다. 고객의 "왜 이걸 모르죠?"는 대부분 그 정보가 이번 요청의 윈도우에 들어 있었는지를 묻는 일로 바뀝니다.
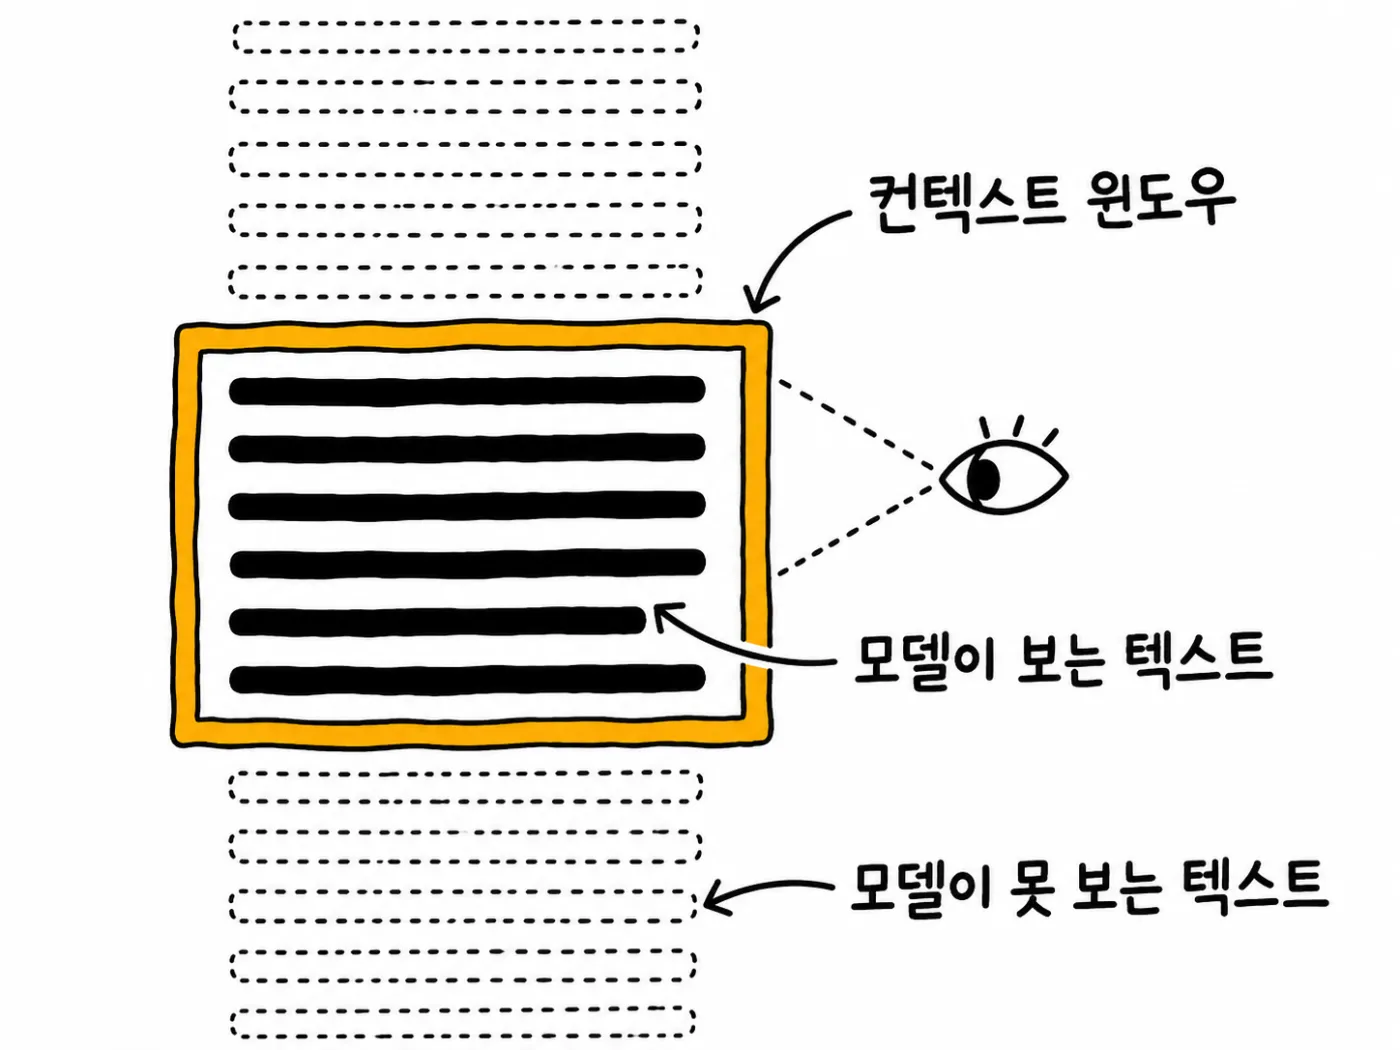
2.16.2 대화 한 턴마다 토큰이 쌓이는 과정
윈도우의 공간은 다음 다섯 가지가 함께 씁니다.
| 구성 | 내용 |
|---|---|
| 시스템 지시 | "You are a helpful teacher."처럼 우리가 주는 규칙 |
| 이전 메시지 | 앞서 사용자와 모델이 한 모든 말 |
| 현재 질문 | 방금 보낸 새 메시지 |
| 붙여 넣은 문서 | 참고용으로 추가한 파일이나 텍스트 |
| 모델의 답 | 토큰 단위로 쓰이는 중인 답변 |
이 다섯은 같은 고정 공간을 두고 경쟁합니다. 이해를 위해 윈도우가 100토큰인 작은 모델로 대화를 따라가 보겠습니다.
- 사용자가 "My name is Amit."을 보냅니다. 약 5토큰이므로 95토큰이 남습니다.
- 모델이 "Nice to meet you, Amit."로 답하고 이 답도 윈도우에 들어가 합계가 약 12토큰입니다.
- 사용자가 "What is my name?"을 묻습니다. 지금까지의 대화 전체가 모델에 전달되고 모델은 "My name is Amit"을 보고 "Your name is Amit."이라고 답합니다.
- 대화가 이어질수록 합계는 100토큰 한계를 향해 계속 커집니다.
새 턴마다 이전 턴이 모두 따라 들어가므로 윈도우는 대화와 함께 자랍니다. 모델이 영구 기억 없이도 나를 기억하는 듯 보이는 이유가 이것입니다. 저장된 기억이 이 위에 얹히는 방식은 별개의 주제입니다(6.8 참조). 매 턴 전체를 다시 보내는 구조이므로, 대화가 길수록 요청 한 번의 입력 토큰과 비용이 함께 커진다는 점을 고객 비용 추정에 반영해야 합니다.
2.16.3 윈도우가 가득 찼을 때
윈도우에는 하드 한도가 있습니다. 100토큰 윈도우에서 대화가 130토큰이 되면 30토큰이 들어가지 못하므로 무언가를 빼야 합니다. 많은 챗 애플리케이션은 가장 오래된 메시지부터 밀어냅니다.
대화 130토큰: [My name is Amit.] [이전 답] [최근 메시지] [최근 답] [새 질문]
한도 100토큰 → 가장 오래된 메시지부터 탈락
유지: [최근 메시지] [최근 답] [새 질문]
문제는 처음에 말한 이름이 밀려난 경우입니다. 그 메시지가 윈도우에서 빠지면 모델은 더 이상 볼 수 없고, 나중에 "내 이름이 뭐지?"라고 물어도 답하지 못합니다. 긴 대화에서 모델이 앞서 한 말을 "잊는" 이유는 기억이 지워져서가 아니라 그 정보가 이번 윈도우 안에 없기 때문입니다. 일부 도구는 오래된 대화를 버리는 대신 짧은 요약으로 바꿔 윈도우에 남깁니다(4.5 참조).
영상 자막은 윈도우를 무한히 키울 수 없는 이유를 세 가지로 설명합니다. 영상은 128k 토큰 윈도우를 약 300쪽짜리 책 분량으로 비유합니다(영상 기준 수치이며 모델마다 다릅니다).
- 어텐션의 계산 비용: 트랜스포머에서는 모든 토큰이 다른 모든 토큰을 봅니다(셀프 어텐션, 2.9 참조). 토큰이 1,000개면 1,000 × 1,000 = 100만 번, 10,000개면 10,000 × 10,000 = 1억 번의 비교입니다. 컨텍스트가 10배 길어지면 계산은 100배가 되며, 이를 제곱(quadratic) 비용이라 합니다.
- 메모리: 모델은 토큰마다 일부 데이터를 GPU 메모리에 보관하며 이것이 KV 캐시입니다(10.3 참조). 컨텍스트가 길수록 캐시가 커지고, 아주 긴 컨텍스트는 수백 GB의 GPU 메모리가 필요해 GPU가 감당하지 못합니다.
- 학습 데이터의 길이: 모델은 특정 길이의 텍스트로 학습합니다. 학습 때 본 길이보다 훨씬 긴 컨텍스트를 처리시키면 품질이 떨어지고 모델이 혼란스러워합니다.
이 한계를 줄이려는 연구로 희소 어텐션(sparse attention), 슬라이딩 윈도우, KV 캐시 압축 같은 긴 컨텍스트 기법이 있습니다. 윈도우가 크다는 것이 긴 입력을 균일하게 잘 읽는다는 뜻은 아닙니다(2.17 참조). FDE는 고객이 "컨텍스트가 큰 모델이면 다 넣으면 되지 않나"라고 할 때 비용은 제곱으로 늘고 품질은 보장되지 않는다는 점으로 답할 수 있습니다.
2.16.4 윈도우 관리 방법과 흔한 실수
윈도우는 한정된 자원이므로 중요한 정보를 안에 두고 필요 없는 텍스트로 채우지 않는 것이 원칙입니다(4.4 참조). 방법은 네 가지입니다.
- 중요한 세부 사항을 질문 가까이에 둡니다.
- 긴 대화는 오래된 부분을 요약합니다. 약 400토큰의 옛 대화("My name is Amit. I am from India. I teach AI and Machine Learning...")를 약 30토큰 요약("User is Amit from India. Teaches AI and ML...")으로 바꾸면 370토큰, 즉 92.5퍼센트를 되찾고 핵심 사실은 남습니다.
- 큰 문서는 관련 부분만 붙입니다. 50쪽 파일에서 필요한 것이 한 쪽이면 윈도우 대부분을 낭비하는 셈입니다.
- 답변도 토큰을 쓴다는 점을 기억해 입력으로 윈도우를 거의 다 채우지 말고 완전한 답이 들어갈 여유를 남깁니다. 8,000토큰 윈도우에 입력이 7,900토큰이면 답에는 100토큰만 남습니다.
흔한 실수는 세 가지입니다.
- 실수 1: 거대한 문서를 붙이고 모델이 전부 완벽하게 읽을 것이라 기대합니다. 문서가 윈도우보다 크면 일부는 잘려 읽히지 않거나 요청이 실패합니다.
- 실수 2: 하나의 채팅을 여러 주제에 영원히 이어 씁니다. 윈도우가 관련 없는 옛 텍스트로 차고 모델이 내용을 뒤섞습니다. 새 주제는 새 채팅에서 시작합니다.
- 실수 3: 진짜 질문을 맨 위에 묻어 두고 그 뒤에 여러 쪽의 텍스트를 붙입니다. 중요한 부분이 길을 잃을 수 있으므로 질문은 명확하게, 관련 컨텍스트 가까이에 둡니다(2.17 참조).
고객 시스템을 점검할 때는 시스템 지시, 이력, 문서, 예약해 둔 답변 공간의 토큰 예산표를 먼저 요구하면 대부분의 "모델이 잊는다"는 문제가 예산 문제로 드러납니다.
2.17 중간 소실 문제(Lost in the Middle)
원문: What is the Lost in the Middle Problem in LLMs and How to Fix It?
정보가 프롬프트 안에 분명히 들어 있는데도 모델이 틀린 답을 내는 경우, 원인은 이해력이 아니라 그 정보가 놓인 위치일 수 있습니다. 2026년 8월 글 기준으로, 이 절은 중간 소실 문제의 모양과 원인, 피해 지점, 측정법, 해법을 설명합니다.
2.17.1 U자형 성능 곡선
컨텍스트 윈도우는 모델이 한 번에 볼 수 있는 텍스트의 최대량입니다(2.16 참조). 모델의 작업 책상이라고 생각하면 됩니다. 책상 위에 올려 둔 것(지시, 문서, 질문을 합친 요청 전체인 프롬프트)은 보이고 책상 밖은 아예 보이지 않습니다. 100,000토큰 윈도우는 대략 75,000단어를 한 번에 볼 수 있습니다. 많은 사람이 윈도우에 들어가기만 하면 모델이 전부 똑같이 잘 읽는다고 가정하는데, 이 가정이 틀린 것이 중간 소실 문제입니다.
중간 소실(Lost in the Middle) 문제는 LLM이 긴 입력의 처음과 끝에 있는 정보에는 강하게 주의를 기울이고 중간에 있는 정보에는 약하게 주의를 기울이는 현상입니다. 세 시간 회의를 떠올리면 쉽습니다. 다음 날 시작 장면과 마지막 결정은 선명하지만 90분 지점의 논의는 거의 사라지고, 내내 자리에 있었어도 마찬가지입니다. 연구자들이 같은 정답을 긴 입력의 여러 위치로 옮기며 실험했을 때 여러 모델에서 같은 약점이 반복되었고, 현상 이름도 거기서 나왔습니다.
이 문제는 잘림과 다릅니다. 입력이 윈도우보다 커서 일부가 모델에 도달하기 전에 제거되는 것이 잘림이고, 중간 소실에서는 아무것도 제거되지 않고 모두 모델에 도달하는데도 모델이 중간을 없는 것처럼 설명합니다. 오류도 경고도 없이 자신 있게 틀리거나 불완전한 답을 내는 점이 위험합니다.
회사 문서 20개를 프롬프트에 넣고 "환불 정책이 무엇인가?"를 묻는 앱으로 확인해 보겠습니다.
| 환불 정책이 있는 위치 | 결과 |
|---|---|
| 문서 2(앞쪽) | 정확히 답함 |
| 문서 10(한가운데) | "주어진 문서에서 환불 정책을 찾지 못했습니다" |
| 문서 19(끝쪽) | 정확히 답함 |
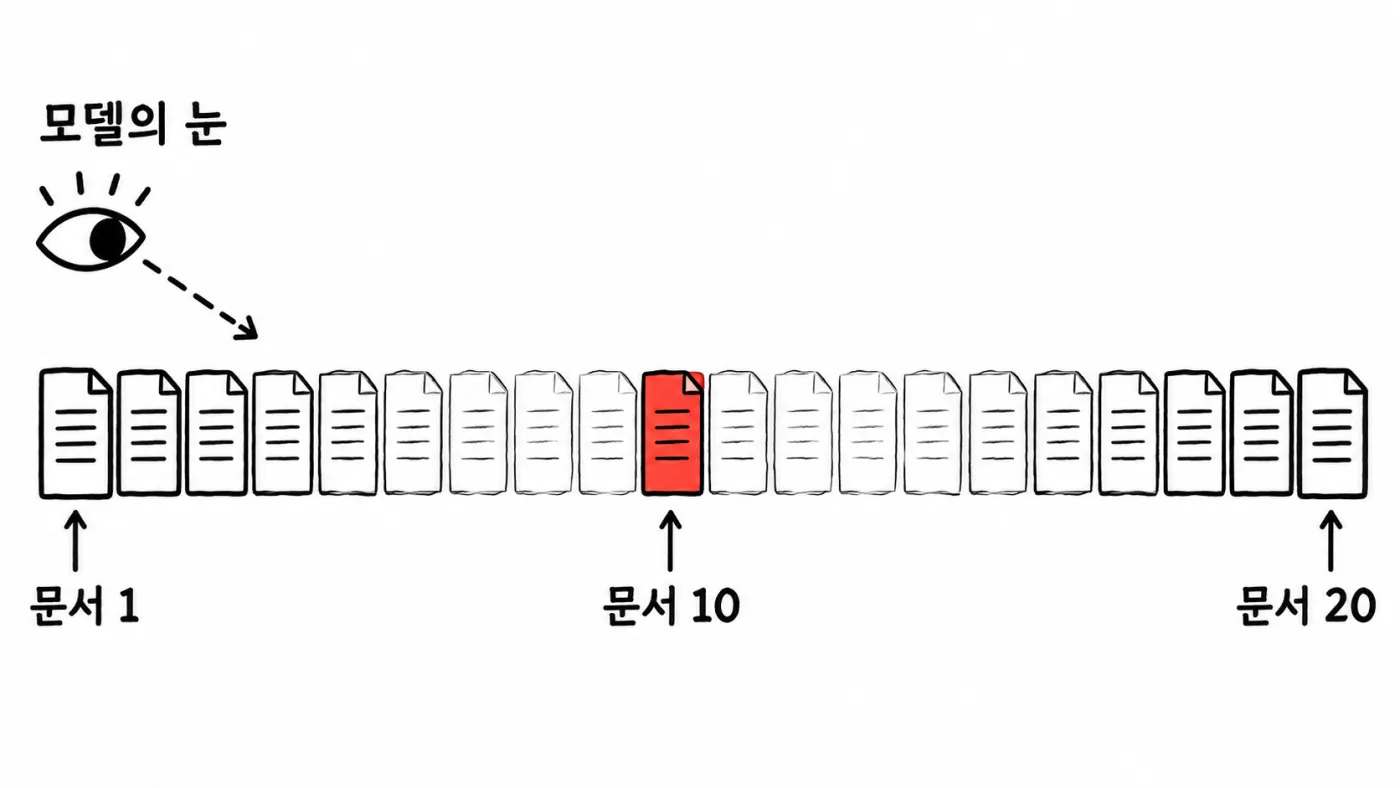
문서, 질문, 모델이 모두 같고 바뀐 것은 좌석 번호뿐인데 한가운데에서만 조용한 실패가 났습니다. 하나의 사실을 처음부터 끝까지 옮기며 위치별 정확도를 기록하면 시작에서 높고, 중간으로 갈수록 떨어지고, 끝에서 다시 오르는 U자형 성능 곡선이 그려집니다.
정확도
 높음 |  *                               *
      |     *                         *
      |         *                 *
      |             *     *     *
 낮음 |______________________________________
       시작           중간            끝
                정답의 위치
그림 2.17.1 — 정답 위치에 따른 정확도는 처음과 끝이 높고 중간이 낮은 U자 모양입니다.
사람의 초두 효과(primacy bias, 처음을 잘 기억함)와 최신 효과(recency bias, 마지막을 잘 기억함)가 모델에서도 비슷하게 나타납니다. 입력이 길수록 중간의 골이 깊어지며, 짧은 프롬프트에서는 눈에 띄지 않다가 아주 긴 프롬프트에서는 중간이 거의 사라집니다. 고객의 문서 20개 정도에서 재현되는지 위치만 바꿔 한 번 돌려 보는 것이 가장 빠른 진단입니다.
2.17.2 발생 원인
원인은 하나가 아니라 네 가지가 겹칩니다.
원인 1, 어텐션이 얇게 퍼집니다. 어텐션은 각 단어가 다른 단어에 얼마나 중요도를 둘지 정하는 메커니즘이고(2.9 참조), 나눠 줄 중요도의 총량이 정해져 있습니다. 중요도 1단위를 다른 단어 10개에 나누면 몫이 넉넉하지만 100,000개에 나누면 한 토큰의 몫이 아주 작아집니다. 방이 작으면 손전등이 구석구석 강하게 비추지만 방이 크면 같은 손전등으로 전체가 흐려지는 것과 같습니다. 입력이 길어질수록 가장 큰 목소리가 이기고 중간에 조용히 놓인 토큰은 눌립니다.
원인 2, 위치를 처리하는 방식입니다. 모델은 단어 순서를 본래 모르기 때문에 위치 인코딩(positional encoding)으로 각 토큰에 위치 정보를 태그합니다(2.8 참조). 많은 현대 모델은 멀리 떨어진 토큰끼리 연결을 약하게 하는 방식을 쓰는데, 가까운 단어가 보통 더 관련 있으므로 일반적으로는 유용합니다. 부작용으로 입력의 끝부분은 답을 쓰는 지점과 가까워 강하게 남고, 입력의 첫 부분은 보통 지시가 있어 반복 훈련으로 존중되며 강하게 남습니다. 중간은 답에서 멀고 고정점도 없어 가장 약한 영역이 됩니다. 맨 앞 토큰들은 필요 없는 어텐션을 버리는 어텐션 싱크(attention sink)로도 쓰여 한 번 더 힘을 얻습니다.
원인 3, 사람의 글쓰기가 그 습관을 가르칩니다. 기사, 논문, 이메일, 보고서는 중요한 내용을 서론에서 말하고 결론에서 반복하며 중간에는 뒷받침 세부 사항을 둡니다. 모델은 수백만 문서에서 이 패턴을 배워 처음과 끝을 더 믿는 습관을 갖게 됩니다.
원인 4, 학습에서 전체 길이를 거의 쓰지 않습니다. 128,000토큰 윈도우를 지원하는 모델이라도 학습 예제 대부분은 그보다 훨씬 짧습니다. 긴 윈도우는 보통 학습 후반 단계에서 추가됩니다. 5쪽짜리 단원으로 여러 해 공부한 학생에게 500쪽 책을 주면 모든 쪽을 넘길 수는 있어도 주의가 책 전체에 고르지 않은 것과 같습니다.
네 원인이 합쳐 중간의 골을 만드는 만큼, 고객이 "최신 모델이니 괜찮다"고 말하더라도 위치 효과는 모델 버전마다 달라지므로 직접 측정하는 것이 판단 기준입니다.
2.17.3 실무에서 문제가 되는 곳
RAG 시스템. RAG는 문서를 청크로 잘라 저장하고, 질문이 오면 리트리버가 관련 청크를 골라 프롬프트에 넣어 답하게 하는 구조입니다(5.6 참조). 많은 팀이 맥락이 많을수록 낫다고 믿고 청크를 20~50개 넣는데, 중간 청크가 무시됩니다. 검색은 완벽했고 생성이 실패했는데 디버깅할 때 리트리버를 탓하게 됩니다. 리트리버가 30개 중 12번째로 정답 청크를 가져왔다면 기술적으로는 검색에 성공했지만, 12번째는 프롬프트의 깊은 중간이라 모델은 가져오지 않은 것처럼 행동합니다.
긴 대화 이력. 대화에서 처음 메시지와 최근 메시지는 강하게 남고, 중간에 준 지시는 힘을 잃습니다. 챗봇이 한동안 규칙을 지키다 어기기 시작하는 이유가 이것입니다. 규칙이 지워진 것이 아니라 약한 중간 영역으로 옮겨 간 것입니다. 대화가 길어질수록 오래된 부분을 요약해 줄이는 이유이기도 합니다(4.5 참조).
긴 문서 분석. 200쪽 계약서나 거대한 로그에서 모든 문제를 찾으라고 하면 시작과 끝 근처 문제는 안정적으로 찾고 중간 구간의 문제는 놓칩니다. 결과가 완결된 것처럼 보이고 모델은 "중간은 건너뛰었다"고 말하지 않으므로 위험합니다.
다중 문서 비교. 보고서 10개를 비교시키면 중간에 놓인 보고서는 얕게 다뤄지고, 요약이 균형 잡힌 듯 보여도 첫 보고서와 마지막 보고서 쪽으로 조용히 기웁니다.
AI 에이전트. 에이전트는 생각하고, 도구를 쓰고, 결과를 읽고 반복하며 단계마다 출력이 컨텍스트에 쌓입니다(6.1 참조). 30단계 뒤에도 맨 처음 목표와 가장 최근 단계는 안전하지만 그 사이에서 알아낸 것은 흐려지며, 오래 도는 에이전트가 원래 요청에서 서서히 벗어나는 원인입니다.
공통점은 겉보기 완결성입니다. FDE는 고객 장애를 "정답 정보가 프롬프트에 있었는가, 있었다면 몇 번째 위치였는가"라는 두 질문으로 먼저 나눠야 하며, 잘림 문제와 구별해야 합니다.
2.17.4 문제 검증 방법
고치기 전에 측정해야 하며, 대표적인 시험이 건초더미 속 바늘(Needle in a Haystack) 시험입니다.
- 질문과 무관한 아주 긴 텍스트를 준비합니다. 이것이 건초더미입니다.
- 고유한 사실 하나를 씁니다. 이것이 바늘이며 예를 들어 "The secret code for the Mumbai office is BLUE-4471."입니다.
- 바늘을 건초더미의 정한 깊이, 예를 들어 10퍼센트 지점에 넣습니다.
- 답이 바늘에만 있는 질문("What is the secret code for the Mumbai office?")을 합니다.
- 모델이 찾았는지 기록합니다.
그 뒤 바늘 위치를 0, 10, 20퍼센트에서 100퍼센트까지 옮기며 반복하고 입력 길이도 바꿔 반복합니다. 결과를 격자에 모으면 모델이 어디서 약해지는지, 입력이 얼마나 길어질 때 중간이 무너지는지가 한눈에 보입니다.
이 시험은 자기 모델, 자기 프롬프트 형식, 자기 종류의 콘텐츠로 돌려야 합니다. 모델마다 약한 구간이 다르고 새 모델 버전마다 달라지기 때문입니다. 고객이 광고된 윈도우 크기만 보고 모델을 고르려 하면, 실제 사용 길이에서 이 시험을 한 번 돌린 결과를 선정 근거로 요구합니다.
2.17.5 해결 방법
해법은 가장 단순한 시도부터 여섯 가지가 있습니다.
| 접근 | 내용 | 한계 |
|---|---|---|
| 1. 전부 넣기 | 큰 윈도우에 모두 넣고 기대함 | 윈도우는 용량 수치일 뿐 품질 보장이 아니며 중간이 여전히 소실되고 토큰 비용과 대기 시간이 늘어남 |
| 2. 적게, 정확히 보내기 | 청크 50개 대신 5개 | 답이 여러 문서에 흩어져 많은 청크가 필요할 수 있음 |
| 3. 청크 순서 배치 | 중요도 순으로 양끝에 배치 | 피해를 줄일 뿐 없애지 못함 |
| 4. 작은 작업으로 분해 | 청크별로 따로 묻고 합침(map-reduce) | 호출이 많아 비용과 시간이 듦 |
| 5. 먼저 찾게 하기 | 관련 문장을 먼저 발췌시킨 뒤 답함 | 두 단계 프롬프트 설계 필요 |
| 6. 모델 선택 | 사용 길이에서 시험해 고름 | 모델 버전마다 재시험 필요 |
접근 2는 가장 간단하고 효과적입니다. 짧고 정확한 컨텍스트에는 중간이 거의 없어 잃을 것도 없습니다. 이를 위해 검색 단계에서 리랭커(reranker), 곧 검색된 청크가 질문에 실제로 얼마나 답이 되는지 점수 매겨 상위 몇 개만 남기는 작은 모델을 씁니다(5.5 참조).
접근 3은 청크를 버리지 않고 순서만 바꾸므로 비용이 없습니다. 가장 관련 높은 청크를 맨 앞, 두 번째를 맨 끝, 세 번째를 첫 번째 다음, 네 번째를 마지막 앞에 두는 식으로 안쪽으로 접어 들어갑니다. 순위 1~7의 청크는 1 3 5 7 6 4 2 순서가 되어 가장 약한 청크가 중간에 놓입니다. 실제 질문은 프롬프트 맨 끝, 답이 시작되기 직전에 둡니다. "주어진 문서로만 답하라" 같은 핵심 지시는 맨 앞과 맨 끝에 두 번 적습니다. 몇 토큰의 비용으로 지시가 약한 중간에 빠지지 않습니다. 다만 정답에 필요한 청크가 중간에 떨어지면 여전히 실패합니다(4.4 참조).
접근 4는 map-reduce 방식입니다. map은 같은 작은 작업을 조각마다 돌리는 것이고 reduce는 그 결과를 합치는 것입니다. 문서 30개라면 30개를 한 번에 묻는 대신 문서 하나씩 30번 호출한 뒤, 30개의 짧은 답을 모아 한 번 더 호출합니다. 모든 조각이 짧은 프롬프트의 처음과 끝에 앉으므로 약한 중간이 없고, 마지막 호출도 짧습니다. 장점은 아무것도 무시되지 않는 것이고 단점은 호출이 늘어 비용과 시간이 더 든다는 점입니다.
접근 5는 지시를 바꾸는 방법입니다. "먼저 질문과 관련된 문장을 문서 번호와 함께 그대로 나열하고, 아직 답하지 마라. 그다음 나열한 문장만 사용해 최종 답을 써라"라고 시킵니다. 복사는 추론보다 쉬우므로 모델은 훑어서 뽑고, 뽑힌 문장이 묻힌 것 없는 짧은 새 컨텍스트가 됩니다. 어려운 일 하나를 쉬운 일 두 개로 나눈 프롬프트 체이닝의 단순한 형태입니다(4.2 참조).
접근 6은 광고된 윈도우 크기로 고르지 않고 실제 길이와 실제 콘텐츠로 바늘 시험을 돌려 고르는 것입니다. 어떤 모델은 30,000토큰까지 중간을 잘 지키다 이후 무너지고 어떤 모델은 더 오래 버팁니다. 100만 토큰 윈도우를 내건 모델은 100만 토큰을 똑같이 잘 이해한다고 약속하는 것이 아니라 받아 준다고 약속할 뿐입니다.
핵심은 컨텍스트 윈도우가 모델이 받아 주는 양이지 모든 부분을 이해하는 정도가 아니며, 가장 좋은 해법은 컨텍스트를 줄여 정확하게 보내는 것이라는 점입니다. 정답이 프롬프트에 있었는데 시스템이 틀렸다면 이해 실패를 가정하기 전에 그 정보가 어디에 놓였는지부터 확인합니다. 많은 경우 답은 이미 있었고 중간에 있었을 뿐입니다. 이 문제는 RAG만이 아니라 긴 대화와 오래 도는 에이전트에도 똑같이 작용합니다.
2.18 LLM 환각(Hallucination)의 토큰 수준 원인
원문: Why Do LLMs Hallucinate? The Token-Level Explanation
환각은 모델이 거짓말을 해서가 아니라, 모르는 자리에서도 반드시 토큰 하나를 골라야 하는 구조에서 나옵니다. 2026년 10월 글 기준으로, 이 절은 한 토큰이 선택되는 순간을 따라가며 여섯 가지 원인과 줄이는 방법을 설명합니다.
2.18.1 쉬운 토큰과 사실 토큰: 날카로운 추측 vs 평평한 추측
환각(hallucination)은 AI가 그럴듯하고 자신 있게 들리지만 실제로는 틀렸거나 지어낸 답을 내놓는 현상입니다. 고의로 속이는 것이 아닙니다. 진짜 답처럼 보이는 것을 확신 있는 어조로 내놓을 뿐입니다. 이 절에서 AI는 LLM을 뜻합니다. 예를 들어 거의 알려지지 않은 작가 Meera Joshi가 언제 태어났는지 물었다고 하겠습니다(모델이 그녀에 대해 읽은 적이 없다고 가정합니다). 신중한 사람은 "모릅니다"라고 하겠지만 AI는 "Meera Joshi는 1962년에 태어났습니다"라고 답합니다. 연도는 추측입니다.
LLM은 텍스트를 토큰이라는 작은 조각으로 읽고 씁니다(2.4 참조). 단어 전체, 단어의 일부, 숫자, 공백이 붙은 단어가 모두 토큰이 될 수 있고, 위 문장은 "Me" | "era" | " Joshi" | " was" | " born" | " in" | " 19" | "62"처럼 쪼개질 수 있습니다. 이 절에서는 이해를 위해 " 1962"를 토큰 하나로 취급합니다.
모델이 하는 일은 하나이며 반복됩니다. 지금까지의 텍스트를 보고 다음 토큰을 예측합니다. 모든 토큰에 점수를 주고 이를 확률로 바꿔 "추측 목록"을 만든 뒤 하나를 고르는 것입니다(2.3 참조). "The capital of France is" 뒤의 목록은 " Paris" 92%, " a" 3%, " the" 2%, " located" 1%, 나머지 전부 2%이고(합 100%), 모델은 " Paris"를 골라 텍스트에 붙인 뒤 처음으로 돌아가 이를 답이 끝날 때까지 되풀이합니다.
- 지금까지의 텍스트를 봅니다.
- 다음 토큰의 확률 목록을 만듭니다.
- 목록에서 토큰 하나를 고릅니다.
- 그 토큰을 텍스트에 붙입니다.
- 1로 돌아갑니다.
이 루프에는 "이것이 사실인지 확인한다"는 단계가 없고 "그럴듯한 다음 토큰을 고른다"만 있습니다. 이것이 문제의 뿌리입니다.
한 문장 안에도 쉬운 정도가 다른 토큰이 섞여 있습니다. " was", " born", " in"은 쉬운 토큰(easy token)으로, 언어 규칙을 따르며 출생 연도 문장이면 어디에나 들어가므로 모델은 거의 항상 맞힙니다. " 1962"는 사실 토큰(fact token)으로, 실제 정보를 싣고 있어 맞히려면 모델이 그 사실을 알아야 합니다. 답의 대부분은 쉬운 토큰이고 사실 토큰은 소수이지만, 참과 거짓을 결정하는 것은 그 소수입니다. 모델은 두 종류에 같은 루프를 쓰며 사실 토큰에서 속도를 늦추거나 조심 모드로 바꾸지 않습니다. 따라서 사실 주변의 자신 있는 문법이 틀린 사실까지 자신 있어 보이게 만듭니다.
모델이 사실을 알 때는 목록이 날카롭습니다(sharp). "Albert Einstein was born in the year" 뒤에서 " 1879"가 95%, " 1878"이 2%, " 1880"이 1%, 나머지 2%로, 한 토큰이 다른 모든 토큰을 크게 앞섭니다. 모델이 아인슈타인에 대한 글을 수없이 읽어 사실이 깊이 저장되었기 때문입니다.
모델이 모를 때는 평평합니다(flat). "Meera Joshi was born in the year" 뒤의 목록은 다음과 같습니다.
| 다음 토큰 | 확률 |
|---|---|
| " 1962" | 14% |
| " 1958", " 1971" | 각 13% |
| " 1965", " 1960", " 1968", " 1955", " 1974" | 각 12% |
합이 100%이고 어느 토큰도 앞서지 않습니다. 모델은 다음 토큰이 연도여야 한다는 것(문장 구조)은 알지만 어느 연도인지는 모릅니다. 비유하면 아인슈타인의 출생 연도를 100명의 학생에게 물으면 거의 모두 "1879"를 외치지만(날카로운 추측), Meera Joshi를 물으면 각자 다른 연도를 외칩니다(평평한 추측). 즉 날카로운 추측은 모델이 아는 것, 평평한 추측은 모르는 것에 해당하고, 불확실성은 확률 안에 숨어 있습니다.
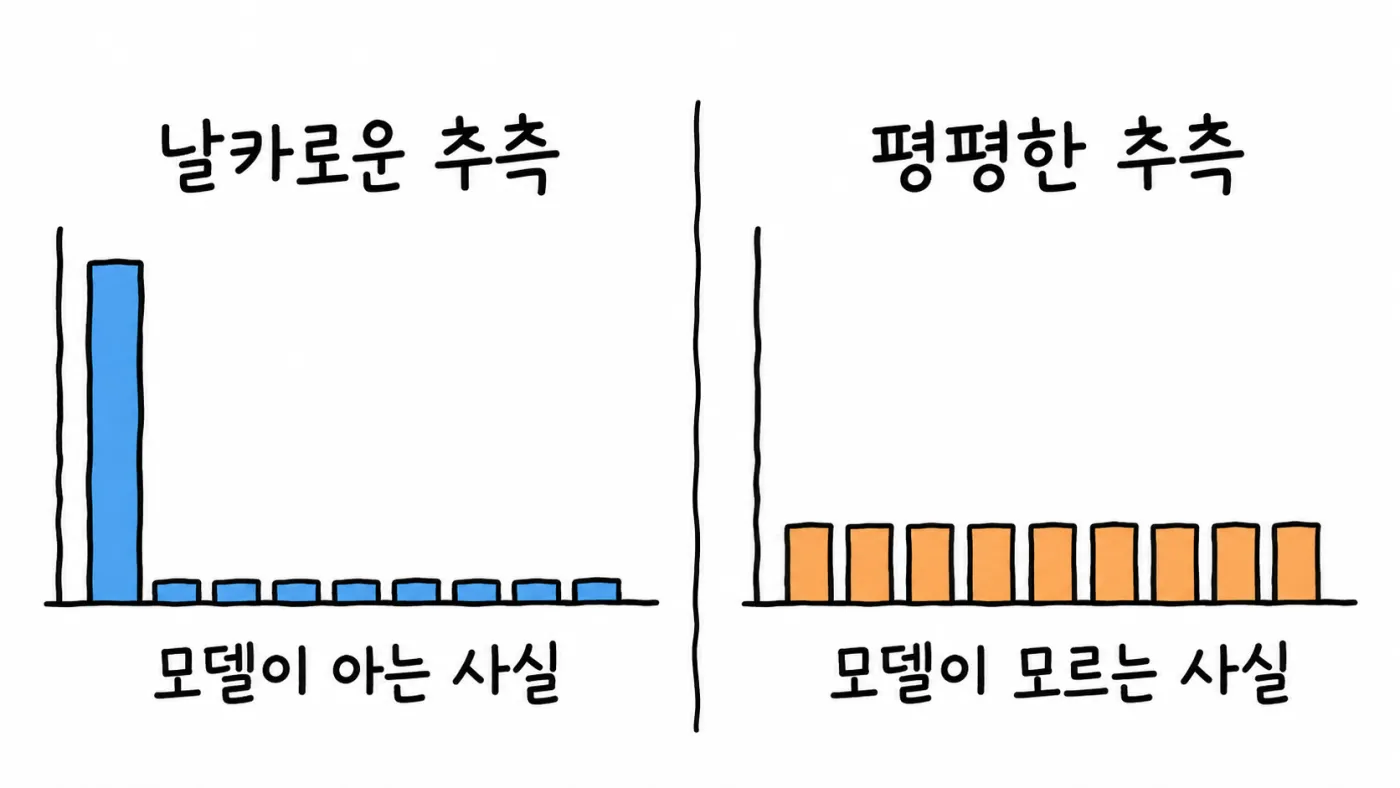
그렇다면 평평한 목록에서 모델은 무엇을 할까요. 그래도 하나를 고릅니다. 다음 파이썬 함수가 같은 일을 합니다.
import random
def pick_next_token(guesses):
    return random.choices(list(guesses), weights=list(guesses.values()))[0]
sharp_guess = {"1879": 0.95, ...}로 여러 번 돌리면 거의 항상 "1879"가 나오지만, flat_guess = {"1962": 0.14, ...}는 "1962", "1971", "1955"처럼 실행마다 바뀝니다. 함수는 항상 토큰을 반환하고 "모르겠다"를 반환하지 않으며, 그 연도가 문장에 들어가면 "1879"만큼 자신 있게 읽힙니다. 이것이 토큰 한 개 수준에서 환각이 만들어지는 방식입니다. 여기서 유용한 점검법은 답의 어느 토큰이 사실 토큰인지를 먼저 표시하는 것입니다.
2.18.2 원인 1: 건너뛸 선택지가 없다
모델은 매 단계마다 반드시 목록에서 토큰을 골라야 합니다. 목록에는 " 1962", " 1958" 같은 토큰이 있을 뿐 "이건 모르니 멈춘다"는 버튼이 없습니다. 모든 빈칸에 반드시 무언가를 써야 하는 빈칸 채우기 시험을 떠올리면, 전혀 모르는 칸에도 단어를 쓰게 되고 답 중 상당수가 그럴듯하지만 틀립니다. LLM은 모든 토큰에서 이 상황입니다.
"I do not know"도 토큰으로 쓸 수 있는데 왜 고르지 않을까요. 그 토큰이 가능성 높은 다음 토큰일 때만 쓰이고, 두 가지 이유로 확률이 작습니다.
- 학습 데이터에는 질문 뒤에 "I do not know"가 오는 글보다 질문 뒤에 답이 오는 글이 훨씬 많습니다.
- 많은 학습·평가 방식이 정직한 "모르겠다"보다 자신 있는 추측에 더 좋은 점수를 줍니다.
그래서 사실 토큰의 목록이 평평해도 모델은 연도, 이름, 숫자를 골라 빈칸을 채웁니다.
2.18.3 원인 2: 평평한 분포에서 무작위가 고른다
모델은 보통 항상 1순위 토큰만 고르지 않고 어느 정도 무작위를 섞으며, 그 정도는 온도(temperature) 설정이 정합니다(2.11 참조). 낮은 온도에서는 거의 항상 1순위를 고르고, 높은 온도에서는 다른 토큰도 더 자주 고릅니다. 날카로운 추측에서는 무작위가 중요하지 않습니다. " 1879"가 95%이므로 거의 항상 이깁니다. 평평한 추측에서는 무작위가 답을 정합니다. 어느 연도든 12~14%이므로 같은 질문을 다섯 번 하면 다음과 같이 나옵니다.
Run 1: Meera Joshi was born in 1962.
Run 2: Meera Joshi was born in 1971.
Run 3: Meera Joshi was born in 1955.
Run 4: Meera Joshi was born in 1962.
Run 5: Meera Joshi was born in 1968.
모든 답이 같은 자신감으로 쓰여 있지만 서로 일치하지 않으며, 이 불일치가 모델이 추측하고 있다는 강한 신호입니다. 위 확률로 계산하면 두 번 물었을 때 같은 연도가 나올 확률은 각 확률의 제곱합인 약 12.5%(0.14² + 0.13² × 2 + 0.12² × 5)입니다.
그러면 온도를 0으로 두면 되지 않느냐는 질문이 나옵니다. 그러면 항상 " 1962"를 고르지만 그 확률은 14%뿐이었으므로 여전히 추측이고 매번 같은 추측이 될 뿐입니다. 낮은 온도는 답을 일관되게 만들 뿐 정확하게 만들지 않습니다. 고객이 temperature 0을 "환각 방지 설정"으로 이해하고 있다면 이 구분을 바로잡아야 합니다.
2.18.4 원인 3·4: 토큰은 되돌릴 수 없고 오류가 연쇄된다
손으로 쓰다 틀리면 지우개가 있지만 LLM에는 없습니다. 한 번 고르고 텍스트에 붙은 토큰은 영원히 남고, 모델은 앞으로 다음 토큰을 더하는 것만 할 수 있습니다(원인 3). "Is 3,827 a prime number?"를 예로 들면 답의 첫 토큰이 큰 결정이며, 목록이 "Yes" 52%, "No" 48%로 거의 같은 상황을 가정하겠습니다. 모델이 "Yes"를 골랐다고 합시다. 3,827은 소수가 아니라 43 × 89입니다(재계산하면 43 × 89 = 3,827). 그러나 모델은 "Yes"를 "No"로 바꾸러 돌아갈 수 없고 이후 모든 것이 이 "Yes" 위에 쌓입니다.
모델은 매 단계에서 자기가 쓴 토큰을 포함한 지금까지의 모든 텍스트를 보고, 자기 토큰을 의심하러 돌아가지 않으며 이어 써야 할 텍스트의 일부로만 취급합니다(원인 4). "Yes" 뒤의 가장 그럴듯한 이어짐은 "Yes"를 뒷받침하는 이유이므로 "Yes, 3,827 is a prime number because it cannot be divided by any number other than 1 and itself."가 나옵니다. 각 토큰은 앞 텍스트에 비춰 좋은 선택이고 문법도 맞고 설명도 논리적으로 들리지만, 전체는 시작의 틀린 토큰 하나 위에 세워졌습니다.
작가의 예도 같습니다. "Meera Joshi was born in 1962. She grew up in the 1970s and published her first book in the late 1980s." 모델은 틀린 연도 하나에서 멈추지 않고 1962에서 자연스럽게 이어지는 세부 사항, 곧 1970년대에 성장했고 1980년대 후반에 첫 책을 냈다는 내용을 만들었고 모두 지어낸 것입니다. 틀린 사실 토큰 하나가 이후 토큰의 기반이 되어 작은 추측이 완전한 지어낸 이야기로 자랍니다. 그래서 긴 답에서는 첫 사실 토큰의 정오를 확인하는 것이 나머지 전체의 신뢰도를 좌우합니다.
2.18.5 원인 5: 그럴듯한 토큰 조합이 없는 사실을 만든다
가짜 이름, 가짜 제목, 가짜 참고문헌이 이 유형입니다. 모델에게 주제에 관한 논문을 추천하라고 하면 "Sharma, A. and Patel, R. (2019). Using AI to Detect Crop Diseases. Journal of Agricultural AI."라고 쓸 수 있습니다. 토큰별로 보면 Sharma와 Patel은 흔한 저자명이고, 2019는 이런 논문에 흔한 연도이며, 제목은 주제에 자연스럽고, "Journal of Agricultural AI"는 실제 저널처럼 들리므로 각각이 가능성 높은 토큰입니다.
그러나 이 저자, 이 연도, 이 제목, 이 저널의 정확한 조합은 어디에도 존재하지 않는다고 가정하겠습니다. 모델에게 중요했던 것은 각 토큰이 앞의 토큰과 잘 맞는지뿐이었고, 루프 어디에도 전체 조합이 현실에 존재하는지 확인하는 단계가 없었습니다. 그래서 가능성 높은 토큰들이 존재하지 않는 참고문헌으로 합쳐졌습니다. LLM이 진짜처럼 보이지만 가짜인 참고문헌을 잘 만드는 이유입니다. 고객 서비스가 인용, 판례 번호, 제품 코드를 생성한다면 각 조각이 아니라 조합의 존재를 외부 데이터로 검증해야 합니다.
2.18.6 원인 6: 최종 텍스트가 불확실성을 숨긴다
모델 내부에서는 평평한 추측이 "확신이 없다"를 뜻하지만, 토큰이 선택되고 나면 텍스트에는 토큰만 남고 그 뒤의 확률은 버려집니다. 최종 답에서 95% 확률이던 " 1879"와 14% 확률이던 " 1962"는 똑같이 문장 속 숫자로 보이고 같은 자신 있는 어조로 쓰여 있으며, 두 번째 숫자 옆에 "14%"라는 작은 표시는 없습니다.
모델은 내부에서는 불확실했지만 겉으로는 확신하는 것처럼 보이며, 독자는 단어만 보기 때문에 읽는 것만으로는 확실한 부분과 추측한 부분을 구별할 수 없습니다. 이것이 환각이 위험한 마지막 이유입니다. 확률을 되살리는 수단이 로그 확률입니다(2.14 참조).
2.18.7 토큰 수준에서 환각 줄이기
각 수정은 앞의 원인 하나에 대응합니다.
| 수정 | 방법 | 대응 원인 |
|---|---|---|
| 1. 사실을 준다 | 질문에 정확한 정보(붙여 넣은 문서)를 넣어 평평한 추측을 날카롭게 바꿈. RAG는 먼저 정보를 찾아 질문과 함께 주는 방식(5.14 참조) | 원인 1 |
| 2. "모른다"를 가능성 높게 | 모델 개발사가 불확실할 때 "I do not know"를 말하도록 학습하고 정직한 모름에 더 좋은 점수를 줌 | 원인 1 |
| 3. 토큰 뒤의 확률을 본다 | 연도·이름 같은 사실 토큰의 확률이 낮으면 "추측 가능성"으로 표시. 같은 질문을 여러 번 하여 사실 토큰이 계속 바뀌면 추측으로 판단 | 원인 2, 6 |
| 4. 답하기 전에 생각하게 한다 | 단계별 생각을 먼저 쓰게 함. 3,827을 작은 수로 나눠 43 × 89를 찾고 나서 "No"를 쓰는 식(4.1 참조) | 원인 3, 4 |
| 5. 사실 과제에는 낮은 온도 | 낮은 온도는 가능성 낮은 토큰으로의 무작위 점프를 줄임 | 원인 2 |
| 6. 사실 토큰은 항상 검증 | 이름, 숫자, 날짜, 참고문헌을 답을 믿기 전에 재확인 | 전체 |
수정 4는 문제를 완전히 풀지 못하며, 모델이 올바른 토큰에 도달할 가능성을 높일 뿐입니다. 수정 5의 낮은 온도는 답을 같게 만들 뿐 맞게 만들지 않으므로 다른 수정과 함께 써야 합니다. 어떤 수정도 환각을 완전히 없애지 못합니다. 모델이 가능성 높은 다음 토큰을 골라 쓰는 한 자신 있는 추측의 가능성은 항상 남습니다. 따라서 고객에게는 "환각 0"을 약속하지 말고, 어느 토큰이 사실 토큰인지 식별하고 그 지점에 근거 제공, 확률 표시, 검증 단계를 배치하는 설계를 약속해야 합니다.
2.19 고객이 내일 묻는다면
각 질문에 소리 내어 답해보고, 막히면 표시된 절로 돌아가십시오. 통과 기준은 "내일 고객이 물어도 LLM의 동작 원리로 설명하고 결정할 수 있는가"입니다.
- "ChatGPT는 결국 검색 엔진 아닌가요, 아니면 답을 새로 만들어 내는 건가요?" 생성형 AI가 기존 AI와 어떻게 다르고 무엇을 만들 수 있는지 설명해 보십시오. (2.1.1, 2.1.3)
- "모델이 한 단어씩 써 내려간다는데, 그럼 앞에서 틀리면 뒤도 다 틀리나요?" 자기회귀 생성의 구조와 오류가 이어지는 이유를 답해 보십시오. (2.3.2, 2.18.4)
- "한국어 문서를 넣었더니 영어보다 비용이 더 나옵니다." 토큰화가 비용과 길이에 미치는 영향을 어떻게 설명합니까? (2.4.5, 2.5.3)
- "비슷한 문서를 찾는다는데 컴퓨터가 의미를 어떻게 비교하나요?" 임베딩과 코사인 유사도로 설명해 보십시오. (2.6.2, 2.7.2)
- "트랜스포머가 RNN보다 좋다는 이유가 뭔가요?" 어텐션이 무엇을 해결했고 어떤 비용을 치르는지 답해 보십시오. (2.10.1, 2.9.2)
- "GPT 같은 모델과 BERT 같은 모델은 뭐가 다른가요?" 세 가지 트랜스포머 변형을 구분해 보십시오. (2.8.6)
- "같은 질문인데 답이 매번 달라요. 항상 같은 답을 받을 수 있나요?" 온도와 샘플링 설정으로 설명하고, 어떤 값을 권하겠습니까? (2.11.3, 2.12.5)
- "Top-p와 Top-k 중 무엇을 써야 하나요?" 각각이 무엇을 자르는지, 어떤 상황에서 달라지는지 답해 보십시오. (2.12.2, 2.12.3)
- "응답이 끝나지 않고 계속 이어지거나 중간에 잘립니다." 정지 토큰과 정지 시퀀스 관점에서 무엇을 점검합니까? (2.13.3, 2.13.5)
- "모델이 이 답에 얼마나 확신하는지 숫자로 볼 수 있나요?" logprobs로 무엇을 할 수 있고 무엇은 못 합니까? (2.14.3, 2.14.5)
- "답이 한 번에 나오지 않고 글자가 흘러나오는데, 이걸 우리 서비스 화면에 붙일 수 있나요?" 스트리밍이 필요한 이유와 연결 방식을 설명해 보십시오. (2.15.1, 2.15.2)
- "컨텍스트 윈도우가 100만 토큰이면 문서를 다 넣으면 되지 않나요?" 한도 안에서도 생기는 문제와 비용을 답해 보십시오. (2.16.3, 2.17.1)
- "긴 계약서 중간 조항만 자꾸 빠뜨립니다." 원인을 설명하고 검증 방법과 해결책을 제안해 보십시오. (2.17.2, 2.17.4, 2.17.5)
- "왜 모델이 없는 논문 제목을 그럴듯하게 지어내나요? 막을 방법이 있나요?" 토큰 수준의 원인과 완화책을 답해 보십시오. (2.18.3, 2.18.6, 2.18.7)