3. 고객에게 맞는 모델 고르기
가장 큰 모델이 늘 맞는 답은 아니며, 작업의 난이도·입력 형태·호출량·비용·지연에 따라 고르는 모델이 달라집니다. FDE는 이 장의 여섯 종류(작은 모델, 추론 모델, 전문가 혼합, 멀티모달, 비전-언어 모델, 라우팅)를 비교해 고객의 업무마다 어느 모델을 어디에 둘지 말로 설명하고 결정합니다.
학습 동기: 이 장을 읽으면 "가장 좋은 모델로 전부 처리하면 되지 않습니까"라는 고객의 질문에 크기·추론 시간·입력 종류·요청 분배라는 네 축으로 답할 수 있고, 모델의 총 파라미터와 활성 파라미터, 이미지 한 장의 토큰 수, 라우팅의 비용 효과를 숫자로 계산해 견적과 구성을 제안할 수 있습니다.
선행 가정: 토큰과 임베딩(1.4.4, 2.4), 컨텍스트 윈도우(2.16), 환각(2.18), 전문가 혼합의 개요(2.10)를 들어본 정도면 충분합니다. 수학은 곱셈과 나눗셈 수준의 비용 계산만 사용합니다.
3.1 소형 언어 모델(SLM)
원문: What are Small Language Models (SLMs) and When Should We Use Them?
고객 앞에서 "가장 큰 모델을 쓰면 되지 않습니까"라는 질문을 받을 때, 크기가 비용·속도·보안·배포 위치를 함께 결정한다는 점을 설명할 수 있어야 합니다. 이 절은 작은 모델이 무엇이고 어디에 쓰이며 어디서 한계에 부딪히는지를 수치와 함께 다룹니다(2026년 5월 글 기준).
3.1.1 '작다'의 기준과 대표 SLM
소형 언어 모델(Small Language Model, SLM)은 노트북이나 휴대폰에서도 싸고 빠르게 돌아갈 만큼 작으면서, 실무의 많은 작업을 해낼 만큼은 유능한 언어 모델입니다. 이름은 Small과 Language Model의 합이며, 파라미터 수가 적은 언어 모델이라는 뜻입니다.
- 언어 모델: 앞선 토큰들을 보고 다음 토큰(텍스트의 작은 조각)을 예측하도록 학습된 신경망입니다. "I love AI"는
I,love,AI세 토큰으로 나뉘는 식이며, 모델은 글자나 단어가 아니라 토큰 단위로 일합니다(2.4 참조).The sky is를 주면blue를 예측하고, 이 결과를 입력에 붙여 다시 다음 토큰을 예측하는 반복이 문장·문단·코드를 만듭니다. - 파라미터: 학습으로 얻은 숫자 하나하나이며 모델의 지식이 여기에 저장됩니다. 1B 모델은 10억 개, 70B 모델은 700억 개를 가지므로 용량 차이는 70배입니다.
- 작다는 기준: 엄격한 규칙은 없으나 보통 100억(10B) 미만을 SLM, 300억(30B) 이상을 LLM으로 부릅니다. 10B~30B는 보는 사람에 따라 갈리는 회색지대입니다.
용어 주의: "작다"는 상대적 개념입니다. 몇 년 전에는 7B 모델도 아주 작다고 했고, 몇 년 뒤에는 오늘의 1B가 중간 크기로 느껴질 수 있습니다. 기준 숫자보다 상대적 크기를 기억해야 합니다.
원문 게시 시점(2026년 5월)의 대표 SLM은 다음과 같습니다.
| 모델 | 크기 | 개발사 | 특징 |
|---|---|---|---|
| Phi-4-mini | 3.8B | Microsoft | 추론에 강함, 컨텍스트 128K |
| Gemma 4 E2B | 유효 2B | 휴대폰용, 128K, 텍스트·이미지·오디오 입력 | |
| Gemma 4 E4B | 유효 4B | 엣지 기기용, 128K, 오디오 입력 | |
| Llama 3.2 1B | 1B | Meta | 모바일·엣지용, 128K |
| Llama 3.2 3B | 3B | Meta | 온디바이스용 중 강한 편, 128K |
| Qwen 3.5 0.8B | 0.8B | Alibaba | 쓸 만한 모델 중 가장 작은 축, 256K |
| Qwen 3.5 2B / 4B | 2B / 4B | Alibaba | 멀티모달, 2B는 사고 모드 전환, 256K |
| Qwen 3.5 9B | 9B | Alibaba | 소형 시리즈의 적정점, 이전 세대 30B급에 견줌, 256K |
| SmolLM3 3B | 3B | Hugging Face | 공개 instruct·추론 모델, 학습 컨텍스트 64K에 YaRN 확장으로 128K |
- Gemma 4의 E는 Effective(유효)를 뜻합니다. Per-Layer Embeddings 구조 덕분에 추론 시 실제로 의미 있는 파라미터 수가 전체 수보다 작습니다.
- 크기는 0.8B에서 9B까지 걸쳐 있고, 작은 쪽은 휴대폰에서, 큰 쪽은 GPU가 있는 노트북에서 돌아갑니다. 70B LLM은 GPU 서버가 있어야 구동 자체가 됩니다.
모델 이름의 숫자는 곧 배치 장소를 암시하므로, 고객이 모델을 지목하면 먼저 그 숫자가 어느 장비에 올라가는지부터 확인합니다.
3.1.2 작아도 유능한 이유
몇 년 전의 3B 모델은 쓰기 어려웠지만 지금의 3B SLM은 상당한 일을 합니다. 달라진 것은 데이터, 학습 기법, 구조 세 가지입니다.
- 더 좋은 학습 데이터: 인터넷 전체를 쏟아붓는 대신 걸러내고 정제한 1~15조 토큰의 고품질 데이터를 씁니다. 양보다 질이 앞섭니다.
- 더 좋은 학습 기법: 지식 증류(큰 "교사" 모델의 출력을 작은 "학생" 모델이 따라 배우는 기법, 11.4 참조), 개선된 옵티마이저, 더 긴 학습이 파라미터당 능력을 더 짜냅니다.
- 더 영리한 구조: Grouped-Query Attention, RoPE(회전 위치 임베딩) 같은 기법이 파라미터를 늘리지 않고도 모델을 빠르고 강하게 만듭니다(2.10 참조).
그래서 오늘의 3B SLM은 몇 년 전 3B와 비교가 되지 않으며, 원문은 오늘의 3B가 두 해 전 13B와 맞먹거나 앞선다고 말합니다. 반대로 말하면 파라미터 수만으로 성능을 예단하면 틀립니다.
고객이 "작은 모델은 품질이 낮을 것"이라고 단정하면, 세대와 학습 방식이 바뀌었다는 점을 짚고 실제 과업 데이터로 비교 평가해 보자고 제안합니다.
3.1.3 SLM vs LLM 크기 스펙트럼
SLM이 LLM보다 좋거나 나쁜 것이 아니라 강점이 다릅니다. 배포·비용·지연·프라이버시는 SLM이, 폭넓은 지식·추론 깊이·아주 긴 컨텍스트는 LLM이 앞섭니다.
| 항목 | SLM | LLM |
|---|---|---|
| 파라미터 | 0.5B ~ 약 10B | 30B ~ 400B+ |
| 필요 메모리 | 1 ~ 18 GB | 60 ~ 800+ GB |
| 하드웨어 | 휴대폰, 노트북, GPU 1장 | 다중 GPU 서버 |
| 첫 토큰 지연 | 약 50~200 ms | 약 500 ms ~ 3 s |
| 출력 100만 토큰당 비용 | 약 $0.10 ~ $1 | 약 $5 ~ $30 |
| 일반 지식 | 쓸 만하나 제한적 | 폭넓음 |
| 복잡한 추론 | 약함~중간 | 강함 |
| 긴 컨텍스트 품질 | 128K에서 무난 | 1M 이상에서도 강함 |
| 프라이버시 | 로컬 실행으로 쉬움 | 클라우드 API라 어려움 |
| 파인튜닝 | 쉽고 저렴 | 어렵고 비쌈 |
크기 축에서는 다섯 구간으로 나뉩니다.
flowchart LR
  A["Tiny<br/>0.5B 미만<br/>임베디드 기기"] --> B["Small (SLM)<br/>0.5B ~ 10B<br/>휴대폰 / 노트북 / GPU 1장"]
  B --> C["Mid<br/>10B ~ 30B<br/>서버 GPU 1장"]
  C --> D["Large (LLM)<br/>30B ~ 70B<br/>다중 GPU 서버"]
  D --> E["Frontier<br/>100B ~ 1T+<br/>데이터센터 클러스터"]
그림 3.1.3 — 크기 축의 다섯 구간. SLM 구간은 대부분의 운영 사례에서 쓰기 쉬운 적정점입니다.
- 한 줄 요약 작업을 같은 조건에서 비교하면, 1B SLM은 약 100 ms, 메모리 약 2 GB, 비용은 거의 0입니다. 70B LLM은 약 2초, 메모리 약 140 GB, API 호출당 약 $0.0002입니다.
- 사용자 한 명이면 둘 다 괜찮습니다. 하루 100만 호출이면 $0.0002 × 1,000,000 = 하루 $200 차이이고, 응답 속도 경험도 크게 달라집니다.
- 원문 자신이 밝히듯 이 수치는 이해를 위한 어림값이며, 실제는 하드웨어와 API 가격에 따라 달라집니다.
- 메모리 수치는 파라미터당 2바이트(16비트)로 계산하면 맞아떨어집니다. 1B는 2 GB, 70B는 140 GB입니다(양자화로 줄이는 방법은 10.8 참조).
고객에게는 "호출량 × 호출당 비용"과 "메모리 × 장비 단가"를 먼저 계산해 보여 주고, 규모가 작을 때는 성능 우위를 택하고 규모가 클 때는 크기를 줄이는 방향으로 논의를 정리합니다.
3.1.4 SLM이 빛나는 사용 사례
SLM이 효과적인 곳은 작업이 좁고, 지연에 민감하고, 데이터가 민감한 경우입니다. 먼저 SLM이 중요한 여섯 가지 이유를 짚습니다.
- 비용: 출력 100만 토큰 기준으로 프런티어 LLM API가 약 $25라면, 자체 GPU에서 돌리는 3B SLM은 전기와 하드웨어 시간으로 약 $0.10~$0.20입니다. 원문은 이를 100~200배 절감이라 했으나, 계산하면 $25 ÷ $0.20 = 125배, $25 ÷ $0.10 = 250배이므로 125~250배가 맞는 범위입니다. 하루 1억 토큰이면 $2,500 대 약 $10~$20 규모의 차이입니다.
- 지연: 같은 하드웨어에서 70B의 첫 토큰이 약 2초, 3B는 약 100 ms로 20배 빠릅니다. 채팅이나 음성 비서에서는 "느리다"와 "즉각적이다"를 가르는 차이입니다(13.1 참조).
- 프라이버시: 데이터가 기기나 서버 밖으로 나가지 않으므로 의료 기록, 금융 데이터, 내부 문서처럼 클라우드 전송이 금지된 경우에 맞습니다.
- 온디바이스: 3B는 최신 휴대폰, 1B는 작은 노트북 CPU, 0.5B는 작은 엣지 기기에서 돌아갑니다. 스마트 키보드, 로컬 요약 노트 앱, 기내 번역기가 예입니다. 이런 모델은 보통 GGUF 형식으로 배포되어 llama.cpp 같은 엔진으로 실행됩니다(10.9, 10.10 참조).
- 쉬운 파인튜닝: 70B 파인튜닝에는 소규모 데이터센터가 필요하지만 3B는 소비자용 GPU 한 장으로 몇 시간이면 됩니다(11.1 참조).
- 신뢰성과 통제: API 호출 제한, 외부 장애, 예고 없는 가격 변경이 없습니다. 모델과 배포를 직접 소유합니다.
대표 사용 사례는 여섯 가지입니다.
- 온디바이스 비서: 1B~3B 모델로 오프라인 글쓰기·코드·채팅 보조를 만듭니다. 1B는 메모리 약 2 GB로 최신 휴대폰에서 초당 약 30 토큰을 내므로 실시간 채팅에 충분합니다.
- 분류: 지원 티켓을
billing,technical,account중 하나로 고르는 일입니다. 작게 파인튜닝한 0.5B 모델은 CPU 한 대에서 초당 수천 건을 분류합니다. 원문은 텍스트를 생성하지 않고 한 번의 계산으로 확률이 보정된 라벨을 돌려주는 System One 계열 모델도 이 용도의 새로운 선택지로 소개합니다. - 구조화 추출: 이메일에서 발신자·날짜·할 일·마감일을 뽑는 일입니다. 제약 디코딩(유효한 JSON만 생성하도록 강제)을 쓰면 SLM이 특히 잘 합니다.
- 에이전트의 작업 헤드: 에이전트 시스템의 작은 단계(요청 라우팅, 목록에서 도구 선택, 출력 서식화)는 추론 모델이 필요 없습니다. 어려운 추론이 필요할 때만 큰 모델을 부릅니다(6.1, 3.2 참조).
- 도메인 파인튜닝 모델: 특정 국가의 특정 계약서 문체처럼 좁은 분야에서 3B에 도메인 예시 1만 건을 파인튜닝하면 같은 과업에서 일반 70B를 앞서기도 합니다.
- 대량 파이프라인: 하루 리뷰 1,000만 건의 감성 추출을 LLM API로 하면 약 $10,000, 자체 호스팅 SLM이면 약 $100입니다. 건당으로 환산하면 $0.001 대 $0.00001입니다.
작업 정의가 좁다는 것이 SLM 적합성의 첫 번째 신호이므로, 고객 요구를 "무엇을 입력받아 무엇을 내놓는가"로 먼저 좁혀 봅니다.
3.1.5 트레이드오프와 선택 기준
SLM은 마법이 아니며 한계가 분명합니다. 이 한계를 알아야 선택 기준이 나옵니다.
- 일반 지식 부족: 1B는 70B보다 파라미터가 70분의 1이므로 외운 사실이 훨씬 적습니다. 드문 역사 사건이나 희귀한 과학 개념은 아예 모를 수 있습니다.
- 복잡한 추론 약세: 긴 수학 풀이나 복잡한 계획 같은 다단계 추론에서 흔히 틀리며, 틀린 답을 자신 있게 내놓기도 합니다.
- 긴 컨텍스트 활용 품질: 대부분의 최신 SLM이 128K 토큰 이상을 지원하므로 창의 크기가 한계는 아닙니다(2.16 참조). 차이는 그 창을 얼마나 잘 쓰느냐에 있습니다. 10만 토큰 안에서 특정 정보를 찾는 needle-in-haystack이나 여러 문서에 걸친 추론에서 3B는 200B 이상 프런티어 LLM보다 의미 있게 약합니다. 긴 입력을 작은 조각으로 쪼개 SLM급 모델이 한 조각씩 처리하게 하는 재귀적 접근도 있습니다.
- 프롬프트 민감도: 표현 한 줄만 바뀌어도 답이 크게 달라질 수 있어서 신중한 프롬프트 작성이나 파인튜닝이 필요합니다.
- 글쓰기 완성도: 긴 창작, 마케팅 문구, 세심한 다단계 추론에서는 문장이 덜 자연스럽고 덜 일관됩니다.
핵심 거래는 "추론력과 일반 지식을 덜 갖는 대신 속도와 낮은 비용을 얻는다"입니다. 이 격차는 세대마다 줄어듭니다(2026년 5월 글 기준).
선택 기준은 다음과 같습니다.
| 선택 | 조건 |
|---|---|
| SLM | 좁고 명확한 과업(분류·추출·라우팅), 하루 수백만 호출, 200 ms 미만 지연, 민감 데이터의 서버·기기 내 보관, 오프라인·온디바이스, 파인튜닝할 데이터 보유 |
| LLM | 다단계 심층 추론, 폭넓은 세계 지식, 1M 규모의 긴 컨텍스트, API 비용이 부담되지 않는 저호출량, 최고 품질을 위해 비용을 감수 |
| 하이브리드 | 대부분 단계는 단순하고 일부만 무거운 추론이 필요 |
하이브리드에서는 SLM이 앞단 라우터로서 라우팅·분류·추출·도구 선택을 맡고, 어려운 추론 단계에서만 LLM을 부릅니다.
flowchart TD
  I["입력"] --> R["SLM 라우터<br/>작고 빠름"]
  R -->|"단순 (예: 90%)"| S["SLM이 직접 처리"]
  R -->|"복잡 (예: 10%)"| L["LLM이 처리"]
  S --> O["출력"]
  L --> O
그림 3.1.5 — 하이브리드 구성. 트래픽의 90%가 단순하다면 LLM 비용은 10%의 요청에만 발생합니다.
- LLM 호출 비중이 10%라면 LLM 비용은 전부 LLM만 쓸 때의 10%입니다. 라우터 자체의 비용은 별도이지만 SLM이므로 무시할 만큼 작습니다.
- 이 패턴은 요청마다 비용·지연·품질을 기준으로 알맞은 모델을 고르는 LLM 라우팅의 한 형태입니다(3.6 참조).
- 원문의 권고는 과업이 허용하는 한 SLM으로 시작하라는 것입니다. 더 빠른 반복, 낮은 비용, 완전한 통제를 얻고 필요하면 나중에 LLM으로 올릴 수 있기 때문입니다.
FAQ에서 확인되는 사항도 같은 선상입니다. 좁은 과업에서는 파인튜닝한 SLM이 LLM을 이길 수 있고, 3B는 휴대폰에서 돌며, 긴 컨텍스트 지원 여부와 활용 품질은 별개이고, 격차는 계속 줄고, 프롬프트 문구에 민감합니다.
고객 현장에서는 먼저 하루 호출량과 지연 한도, 데이터 반출 가능 여부를 묻고, 과업별로 SLM·LLM·하이브리드 중 어디에 해당하는지 표로 판정한 뒤 소량 평가셋으로 검증합니다.
3.2 대형 추론 모델(LRM)
원문: What are Large Reasoning Models (LRMs) and How Are They Different from LLMs?
같은 LLM 계열이라도 "바로 답하는 모델"과 "먼저 생각하고 답하는 모델"은 지연·비용·정확도의 구조가 다릅니다. 이 절은 그 차이가 어디서 오는지, 어떻게 학습되는지, 언제 쓰고 언제 쓰지 말아야 하는지를 다룹니다(2026년 5월 글 기준).
3.2.1 LLM vs LRM의 차이
대형 추론 모델(Large Reasoning Model, LRM)은 답으로 곧장 뛰어들지 않고 긴 중간 추론 단계를 먼저 만든 뒤 최종 답을 내도록 학습된 LLM입니다. 이름은 Large(보통 7B~700B+ 파라미터), Reasoning(중간 단계를 길게 생성), Model(여전히 다음 토큰을 예측하는 신경망)의 합입니다. 추론 모델, 씽킹 모델도 같은 뜻입니다. 원문이 드는 예는 OpenAI GPT-5.5 Thinking, DeepSeek R1, Qwen3, Gemini 3의 Deep Think, Claude의 extended thinking, Grok 4.1의 Think 모드입니다.
차이를 보기 위해 원문이 계속 쓰는 문제 하나를 씁니다.
가게에서 펜은 2개에 5루피, 공책은 3권에 12루피입니다. 펜 6개와 공책 9권을 사면 모두 얼마입니까?
- 일반 LLM은 1초 안에 "51루피" 같은 몇 토큰을 내놓습니다. 한 번에 짐작하므로 틀리기도 합니다.
- LRM은 단가를 구하고, 곱하고, 더하고, 검산한 뒤에야 답을 씁니다. 이 정도 문제에서도 추론 토큰이 수백 개이고, 어려운 문제에서는 수천~수만 개로 늘어납니다.
- 추론 토큰은 대개 사용자에게 보이지 않지만 모델은 생각하는 비용을 이미 치렀고, 그래서 답이 더 정확합니다.
| 항목 | 일반 LLM | LRM |
|---|---|---|
| 답하는 방식 | 직접, 한 번에 | 먼저 생각하고 나중에 답 |
| 사용 토큰 | 적음 (100~500) | 많음 (5,000~50,000) |
| 지연 | 1~3초 | 10~120초 |
| 쿼리당 비용 | 낮음 | 10~30배 |
| 강점 | 단순 대화, 요약, 초안 | 수학, 코드, 논리, 계획 |
| 약점 | 어려운 다단계 문제 | 쉬운 일에는 느리고 비쌈 |
flowchart LR
  Q1["질문"] --> A1["짧은 답<br/>(빠름, 가끔 틀림)"]
  Q2["질문"] --> T["긴 사고 흔적"] --> A2["짧은 답<br/>(느림, 더 자주 맞음)"]
그림 3.2.1 — 위가 LLM, 아래가 LRM입니다. LRM은 LLM이 건너뛰는 사고 단계를 중간에 둡니다.
사고 흔적 안에서 일어나는 일은 새로운 부품이 아니라 더 많은 텍스트입니다. 모델은 문제를 쪼개고, 접근을 시도하고, 중간값을 적고, 마지막에 자기 답을 검산합니다. 시험 중 연습지에 풀이를 적는 꼼꼼한 학생과 같으며, 연습지가 추론 흔적(reasoning trace), 답안지에 쓰는 것이 최종 답입니다. 펜·공책 문제의 흔적은 <think> 안에 펜 6개 = 6 × 2.5 = 15루피, 공책 9권 = 9 × 4 = 36루피, 합계 51루피를 쓰고 "2개 묶음 3개 × 5 = 15"처럼 묶음 단위로 다시 검산합니다. 51은 직접 계산해도 맞습니다.
고객이 LRM이 다른 종류의 신경망이냐고 물으면, 같은 신경망이 학습으로 더 많은 토큰을 쓰도록 바뀐 것이라고 답합니다. 비용 협의에서는 "답이 짧아 보여도 청구는 긴 추론에 대해 나온다"를 먼저 확인합니다.
3.2.2 테스트 타임 컴퓨트: 오래 생각할수록 똑똑해진다
학습 시점 컴퓨트(train-time compute)는 더 큰 모델을 더 많은 데이터로 학습해 똑똑하게 만드는 방식이며, 학습 때 한 번 비용을 내면 이후 응답은 빠릅니다. LRM은 두 번째 손잡이인 테스트 타임 컴퓨트(test-time compute)를 더합니다. 답하는 순간 더 오래 생각해서 똑똑해지는 방식입니다.
원문이 인용한 OpenAI의 AIME 2024(어려운 고등학교 수학 경시) 공개 수치입니다.
| 모델과 조건 | 정답률 |
|---|---|
| GPT-4o (일반 LLM) | 약 12% |
| o1, 추론 1회 | 약 74% |
| o1, 병렬 64회 다수결 | 약 83% |
| o1, 1,000회 리랭킹 | 약 93% |
- 첫 줄은 비교 기준이고, 나머지 세 줄은 같은 o1 모델입니다. 줄마다 바뀌는 것은 답하는 순간에 쓰도록 허용한 컴퓨트의 양뿐입니다.
- 일반 LLM 대비 12%에서 74%로 약 6.2배, 같은 모델 안에서 74%에서 93%까지 오르는 데 시도 횟수를 64회, 1,000회로 늘렸습니다.
- 학생 비유로는 같은 학생에게 연습지를 더 주는 것입니다. 머리는 같아도 연습지가 길면 답이 나아집니다.
- 바깥에서 컴퓨트를 쓰는 방법도 있습니다. 일반 LLM이 여러 추론 경로를 시도하고 평가해 좋은 것만 남기는 방식입니다(4.3 참조).
- 공짜가 아닙니다. 토큰이 늘면 시간과 비용이 늘고, 생각 토큰을 두 배로 늘리면 그 쿼리의 출력 비용도 대략 두 배가 되며, LRM 청구서는 대부분 출력 비용입니다. "속도를 덜고 정확도를 더하는" 이 거래가 LRM이 별도 종류로 존재하는 이유입니다.
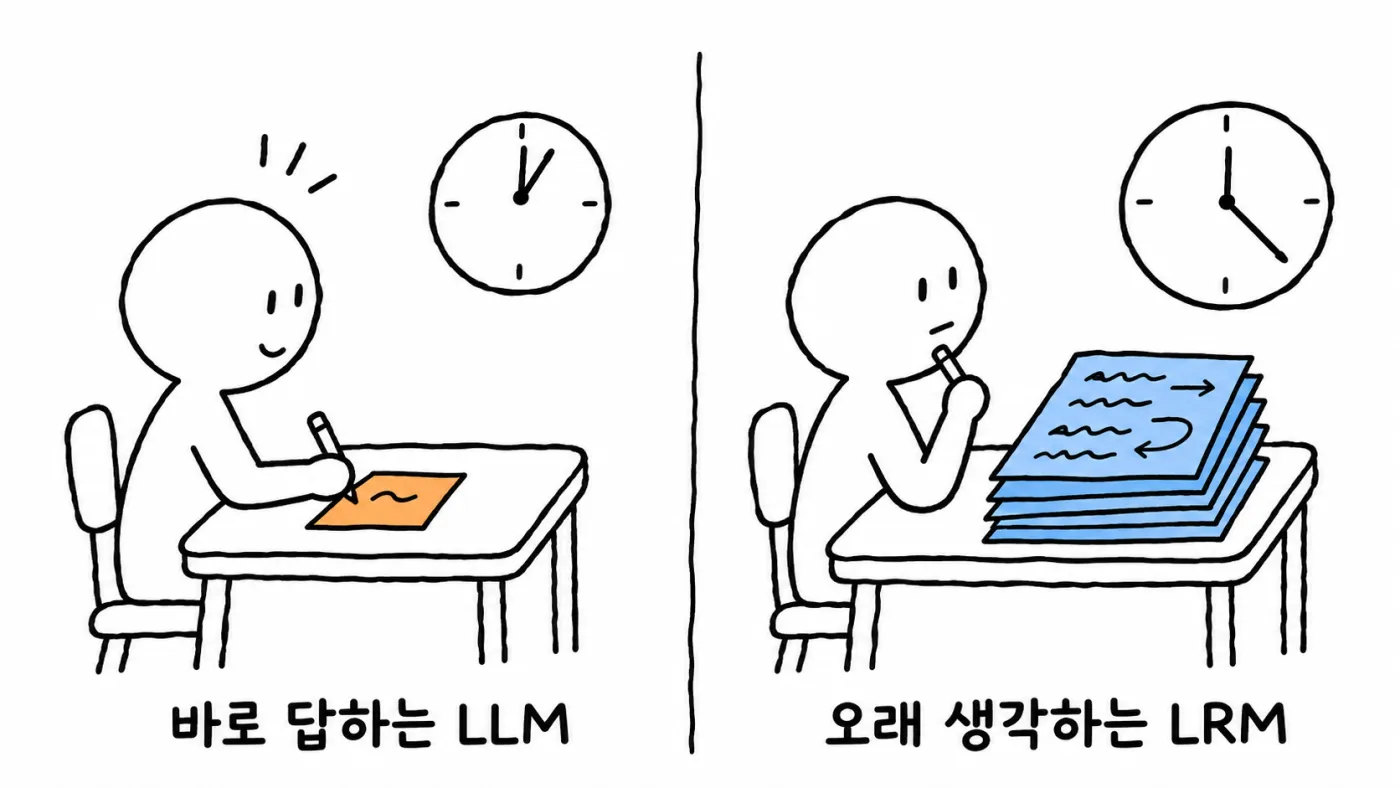
많은 LRM API는 생각 예산(thinking budget)을 조절하게 합니다. 예산을 1,024, 8,192, 32,768 토큰 같은 값으로 두면 작은 예산은 빠르고 싼 답, 큰 예산은 느리지만 정확한 답을 냅니다. 최신 API는 질문의 복잡도에 따라 모델이 스스로 정하는 적응형 생각(adaptive thinking) 쪽으로 가고 있습니다. 토큰이 얼마나 빨리 나오느냐는 하드웨어 문제이며, 이 부분을 빠르게 만들려는 칩이 LPU입니다(12.5 참조).
고객에게는 정확도 곡선과 비용 곡선을 같이 보여 줍니다. 필요한 정확도에서 멈추는 지점이 곧 생각 예산입니다.
3.2.3 LRM의 학습 방식
일반 LLM은 인터넷 텍스트로 하는 사전학습과, 프롬프트를 따르게 하는 지시 튜닝(11.1 참조) 두 단계를 거칩니다. LRM은 그 위에 추론 과제에 대한 강화학습(1.14 참조)을 한 단계 더합니다.
- 정답이 알려진 어려운 문제를 줍니다.
- 같은 문제에 대해 긴 추론 흔적을 병렬로 여러 개(16, 32, 64개 같은 그룹) 생성하게 합니다.
- 어느 흔적이 정답에 도달했는지 확인합니다. 수학은 정답이 분명해서 자동으로 확인됩니다.
- 각 흔적을 같은 그룹의 나머지에 상대적으로 채점합니다. 그룹 평균보다 잘한 흔적은 강화하고 못한 흔적은 벌점을 줍니다.
- 다음에는 좋은 추론 패턴을 더 자주 따르도록 모델을 갱신합니다.
이 그룹 상대 채점이 DeepSeek R1 학습에 쓰인 GRPO(Group Relative Policy Optimization)의 핵심이며, 절대 목표가 아니라 그룹과 비교하는 방식이 이 규모에서 학습을 안정시킵니다. 이 전체를 검증 가능한 보상 기반 강화학습(Reinforcement Learning with Verifiable Rewards, RLVR)이라 부릅니다. 검증 가능이란 보상이 사람의 의견이 아니라 자동 검사기에서 나온다는 뜻입니다(사람 선호에 의존하는 RLHF와 구분됩니다, 11.6 참조).
- 수학: 최종 숫자가 정답과 같은가
- 코드: 생성된 코드가 단위 테스트를 모두 통과하는가
- 논리: 답이 퍼즐의 알려진 해와 일치하는가
사람이 끼지 않으므로 이 루프를 수백만 번 돌릴 수 있습니다. 그 결과 모델은 문제를 먼저 쪼개기, 한 단계 풀고 단위 확인하기, 실수를 발견하면 돌아가 다른 접근을 시도하기 같은 습관을 익히며, 긴 추론 흔적에서 보이는 것이 바로 이 습관입니다.
한계도 구조에서 나옵니다. 검사기가 있는 문제(수학·코드·퍼즐)에서만 이 방식이 잘 작동하므로, 정답이 하나로 정해지지 않는 고객 업무에서는 "자동 검사기를 만들 수 있는가"가 LRM 효과를 가늠하는 질문이 됩니다.
3.2.4 학습·예측 단계별 입출력 네 가지 경우
같은 두 모델을 학습과 예측 두 단계에서 보면 입력과 출력이 네 가지로 갈립니다.
| 경우 | 입력 | 출력 | 신호 |
|---|---|---|---|
| LLM 학습 | 다음 토큰이 가려진 텍스트 (The capital of France is) |
예측한 다음 토큰 (Paris) |
손실: 실제 토큰과 얼마나 가까운가 |
| LRM 학습 | 정답을 아는 어려운 문제 | 최종 답으로 끝나는 완전한 추론 흔적 여러 개 | 보상: 최종 답이 맞는가 |
| LLM 예측 | 사용자 프롬프트 (Write a haiku about rain.) |
직접 답(하이쿠), 내부 사고 없음 | 없음 |
| LRM 예측 | 사용자 프롬프트 | <think>...</think>의 긴 흔적과 짧은 최종 답 |
없음 |
- LLM 학습: 실제 다음 토큰도
Paris이므로 맞혔고 손실이 작습니다.London이라 예측했다면 손실이 크고 가중치가 고쳐집니다. - LRM 학습: 펜·공책 문제에 대해 흔적 16개를 병렬로 만든다고 합시다. 검사기가 각 흔적의 최종 답을 정답 "51루피"와 비교하고, 원문의 가정으로 6개가 51, 10개가 48이나 54 같은 오답이라면 맞은 6개는 그룹 평균보다 위에서 강화되고 틀린 10개는 아래에서 벌점을 받습니다.
- 평균 보상은 6 ÷ 16 = 0.375입니다. 표준편차 0.484로 정규화하면 맞은 흔적은 약 +1.29, 틀린 흔적은 약 −0.77의 상대 점수를 받습니다(GRPO식 상대 점수의 이해를 돕는 계산이며 원문의 수치는 아닙니다).
- LRM 예측: 같은 문제를 받으면 모델은 학습에서 보상받은 종류의 흔적을 그대로 만들고, 다수 제품에서 사용자는 "총 51루피입니다"만 봅니다. 학습에서 점수가 매겨진 16개 중 하나와 같은 형태이며, 이것이 학습이 보상한 바로 그 행동입니다.
입출력 형태가 다르면 장애 양상도 다릅니다. LLM은 틀린 답을 빠르게 내고, LRM은 느리게 틀리거나 예산에 막혀 흔적 중간에 끊깁니다. 그래서 LRM 서비스에는 응답 시간 제한과 토큰 한도를 함께 설계합니다.
3.2.5 LRM과 일반 LLM의 선택 기준
LLM과 LRM 가운데 고르는 기준은 과업이 몇 단계의 신중한 사고를 요구하는지, 틀렸을 때의 비용이 얼마인지입니다.
- 일반 LLM: 과업이 짧고 직접적일 때입니다. 빠른 채팅 응답, 간단한 요약, 이메일 초안, 완벽한 정확성보다 지연이 중요할 때, 수백만 호출이라 쿼리당 비용이 낮아야 할 때가 해당합니다.
- LRM: 신중한 다단계 사고가 필요하고 오답의 대가가 클 때입니다. 복잡한 수학, 어려운 코딩, 과학 질문, 다단계 계획, 깊은 데이터 분석, 까다로운 논리 디버깅이 예입니다. 30초 이상 기다릴 수 있고 높은 토큰 비용을 감당할 수 있어야 합니다.
- 제3의 선택: 답이 텍스트가 아니라 어느 범주, 어느 팀, 안전 여부 같은 결정이라면 확률이 보정된 라벨을 순식간에 내는 System One 계열 모델이 있습니다.
원문 게시 시점(2026년 5월)의 대표 LRM은 다음과 같습니다.
| 모델 | 특징 |
|---|---|
| OpenAI GPT-5.5 Thinking | OpenAI 추론 플래그십(2026년 4월 출시), 원문은 원본 추론 흔적을 숨기고 짧은 요약과 최종 답만 제공한다고 설명합니다. 이 부분은 외부 출처로 확인하지 못했습니다 |
| DeepSeek R1 / R1-Zero | 가중치 공개, 전체 흔적 표시, RLVR이 핵심 학습 단계. R1-Zero는 사람이 쓴 예시로 하는 지도 파인튜닝(SFT) 없이 규칙 기반 보상만으로 기본 모델 위에서 학습한 가장 순수한 RLVR 사례 |
| DeepSeek V3.1·V4 | 생각 모드와 비생각 모드를 한 모델에 포함 |
| Qwen3 | Alibaba의 가중치 공개 모델, 한 모델이 생각·비생각 모드를 모두 지원하고 생각 예산 손잡이 제공 |
| Gemini 3 Deep Think | Gemini 계열 안의 추론 모드, 어려운 문제에 수십 초에서 수 분의 테스트 타임 컴퓨트 사용 |
| Claude Opus 4.7 extended thinking | Anthropic 공식 문서에 따르면 Opus 4.7은 생각 예산을 수동 지정하는 방식 대신 모델이 생각량을 정하는 적응형 생각(adaptive thinking)을 지원 |
| Grok 4.1 Think | 생각 단계에 X와 웹 대상 DeepSearch를 결합 |
모두 "먼저 생각하고 나중에 답한다"는 같은 핵심을 공유하며 차이는 모델 크기, 학습 데이터, 추론 흔적의 공개 여부입니다. 모델명과 기능은 변하므로 고객 제안 시점에 공식 문서로 다시 확인합니다.
고객 현장에서는 업무를 "단순 응답 / 신중한 다단계 / 단일 결정"으로 분류한 뒤, 호출 비중이 높은 단순 업무에 LRM이 배정되지 않았는지부터 점검합니다.
3.2.6 LRM 사용 시 흔한 실수
LRM은 비싸고 느린 도구이므로 실수의 대부분은 비용과 사용 방식에서 나옵니다.
- 모든 곳에 LRM 쓰기: 문장 번역이나 문단 요약에 LRM을 쓰면 일반 LLM이 1초에 끝낼 일에 10~30배 비용과 30초 대기를 치릅니다. 어려운 작업만 LRM으로 라우팅합니다(3.6 참조).
- 추론 토큰 비용 무시: 흔적이 숨겨져도 과금은 됩니다. 보이는 토큰이 200개인 쿼리가 뒤에서 15,000개의 추론 토큰을 썼을 수 있습니다. 청구 모델을 먼저 확인합니다.
- LRM 프롬프트에 "단계별로 생각하라" 추가: 모델은 이미 단계별로 생각하도록 학습되어 있어서 추가 지시가 대개 도움이 되지 않고 때로 혼란을 줍니다. 프롬프트는 간결하게 문제만 서술합니다(CoT 프롬프팅은 4.1 참조).
- 운영 트래픽에 생각 예산을 두지 않기: 하나의 어려운 입력이 수만 추론 토큰을 태울 수 있어서 쿼리당 비용이 크게 출렁이고, 한 건의 나쁜 입력이 하루 청구서를 좌우합니다. 대부분 경로는 8,192 토큰, 극히 어려운 경로만 32,768 토큰 같은 식으로 한도를 둡니다. 적응형 생각이 도움이 되지만 상한을 하드하게 두는 편이 안전한 기본값입니다.
- 추론 흔적을 최종 답으로 취급: 흔적은 초안이며 틀린 중간 단계, 임시 값, 수정이 섞여 있습니다. 최종 사용자에게는 최종 답만 보입니다.
FAQ의 내용도 이와 같습니다. LRM은 다른 종류의 신경망이 아니며, 흔적 공개 여부는 제품에 따라 다르고, RLVR은 사람 채점이 필요 없고, Qwen3처럼 한 모델이 두 모드를 지원합니다.
고객에게 LRM 도입을 제안할 때는 월 호출 수 × 평균 추론 토큰 × 토큰 단가를 먼저 계산하고, 생각 예산 상한과 응답 시간 상한을 계약서 수준의 운영 파라미터로 확정합니다.
3.3 전문가 혼합(Mixture of Experts, MoE)
원문: What is Mixture of Experts (MoE) and How Does It Work?
모델 카탈로그에는 "총 파라미터 수천억, 활성 수백억" 같은 표기가 자주 나옵니다. 이 절은 그 표기가 가리키는 구조, 곧 모델 내부에서 전문가를 고르는 라우터와 부하 분산을 다루며, 모델 전체의 구조적 조망은 2.10에 있습니다(2026년 4월 글 기준).
3.3.1 전문가(Expert)와 라우터(Router)
전문가 혼합(Mixture of Experts, MoE)은 큰 신경망 하나를 모든 입력에 쓰는 대신, 작은 네트워크인 전문가(expert) 여러 개를 두고 입력마다 몇 개만 켜는 구조입니다. 어느 전문가를 쓸지는 라우터(router)가 정합니다. 병원에 비유하면 모든 환자를 보는 의사 한 명이 아니라 심장·피부·뇌 전문의가 있고, 접수 담당자(라우터)가 환자를 맞는 전문의에게 보내는 구조입니다. 환자는 병원의 모든 의사를 만나지 않습니다.
밀집 모델(dense)은 모든 토큰이 모든 파라미터를 쓰는 모델입니다. 1,000억 파라미터 모델이면 토큰 하나마다 1,000억 개를 전부 씁니다. 이 구조에는 두 문제가 있었습니다.
- 연산 비용: 모델이 똑똑해지려고 커질수록 토큰당 연산과 GPU 비용이 함께 늘어납니다.
- 낭비된 용량: 입력마다 필요한 하위 네트워크는 다른데 밀집 모델은 필요 여부와 상관없이 전부 통과시킵니다.
MoE는 총 파라미터는 크게 두되 입력마다 일부만 쓰게 해서, 거대 모델의 이점을 전체 연산 비용을 내지 않고 얻는 방식입니다.
전문가의 정체: 현대 LLM에서 전문가는 작은 피드포워드 네트워크(feed-forward network)입니다. 트랜스포머에 이미 있는 그 피드포워드 층(2.8 참조)이며, 한 층에 8개, 64개, 128개가 나란히 놓입니다. 전문가가 수학이나 물리처럼 주제별로 특화된다는 것은 오해입니다.
용어 주의: "전문가"라는 이름은 오해를 부릅니다. 수학 전문가, 물리 전문가를 따로 학습시키지 않으며 수동 라벨링도 없습니다. 어떤 전문가가 어떤 입력을 맡을지는 학습 중 모델이 스스로 정하고, 실제로는 구두점, 단어 유형, 토큰 형태 같은 낮은 수준의 패턴으로 특화되는 경우가 많습니다.
라우터의 정체: 라우터는 토큰마다 어느 전문가가 처리할지 정하는 아주 작은 신경망이며, 실제로는 깊은 네트워크가 아니라 선형 층 하나와 Softmax입니다(1.10, 1.11 참조). 동작은 세 단계입니다.
- 입력 토큰에 대해 전문가마다 점수를 냅니다. 전문가가 8개면 점수 8개이며, 식은
Router(x) = Softmax(x · W_router)입니다.x는 입력 토큰,W_router는 라우터가 학습한 가중치 행렬이고, Softmax는 원점수를 합이 1인 확률로 바꿉니다. - 점수가 가장 높은 top-k 전문가를 고릅니다. 대부분의 MoE 모델은
k = 2이고, Switch Transformer 같은 일부는k = 1입니다. - 토큰은 선택된 top-k 전문가에게만 가고 나머지는 이 토큰에 대해 완전히 건너뜁니다.
flowchart TD
  T["토큰"] --> R["라우터"]
  R -.-> E1["E1"]
  R -.-> E2["E2"]
  R ==> E3["E3 선택"]
  R -.-> E4["E4"]
  R ==> E5["E5 선택"]
  R -.-> E8["... E8"]
  E3 --> O3["Out_3"]
  E5 --> O5["Out_5"]
  O3 --> W["가중합"]
  O5 --> W
  W --> O["출력"]
그림 3.3.1 — 라우터가 E3와 E5를 고른 예. 선택되지 않은 전문가는 이 토큰에서 쉽니다.
트랜스포머 안의 위치: 트랜스포머 층은 멀티헤드 어텐션(2.9 참조)과 피드포워드 두 하위 층으로 이루어집니다. MoE 트랜스포머는 피드포워드 하위 층만 MoE로 교체하고, 어텐션은 그대로 둡니다. 모든 층이 MoE일 필요도 없어서, 밀집 층과 MoE 층을 번갈아 두는 모델도 있으며 이는 설계 선택입니다.
고객 질문에 "MoE는 모델 여러 개를 합친 앙상블입니까"가 나오면 아니라고 답합니다. 한 모델 안의 피드포워드 층만 여러 갈래로 나눈 구조입니다.
3.3.2 희소 활성화와 활성 vs 전체 파라미터
토큰당 몇 개의 전문가만 실행되므로 희소 활성화(sparse activation)된 모델이라고 부릅니다. 층마다 전문가가 8개이고 top-2를 고르면 토큰마다 8개 중 2개만 실행되고 6개는 쉽니다. 전체 파라미터는 8개 전문가를 모두 포함하지만 토큰당 연산은 2개 분량입니다.
- 층마다 자기 라우터가 있습니다. MoE 층이 32개면 라우터도 32개입니다. 각 층은 자기 전문가 집합으로 토큰을 보내는 방식을 따로 학습하므로 라우터는 층 사이에서 공유되지 않으며, 선택되는 전문가도 층마다 다를 수 있습니다.
- 전체 파라미터(total)와 활성 파라미터(active): 전체는 모델의 총 크기이고 활성은 토큰 하나가 실제로 쓰는 파라미터입니다.
| 예 | 전체 | 활성 | 활성 비율 |
|---|---|---|---|
| 전문가 8개, 각 10B, top-2 | 80B | 20B | 25% |
| Mixtral 8x7B | 약 47B | 약 13B | 약 28% |
- 첫 줄은 연산 면에서 20B 모델처럼 움직이면서 80B 모델의 지식을 지닙니다. 한 줄로 "큰 두뇌에 작은 청구서"입니다.
- Mixtral 8x7B는 7B 기반 위에 전문가 8개를 둔 모델로, 속도는 13B처럼 빠르고 성능은 47B처럼 똑똑합니다.
- 8 × 7 = 56인데 왜 47B인가: 전문가마다 복제되는 것은 피드포워드 하위 층뿐입니다. 어텐션, 임베딩, 정규화 층은 모든 전문가가 공유합니다. 그래서 총량은 "전문가 수 × 전문가 크기"가 아닙니다. 원문 수치를 맞춰 보면 공유 부분 약 1.6B, 전문가 하나당 약 5.6B이며 1.6 + 8 × 5.6 ≈ 47, 1.6 + 2 × 5.6 ≈ 13이 되어 두 수치가 일관됩니다(이 분해는 원문 수치에서 역산한 값입니다).
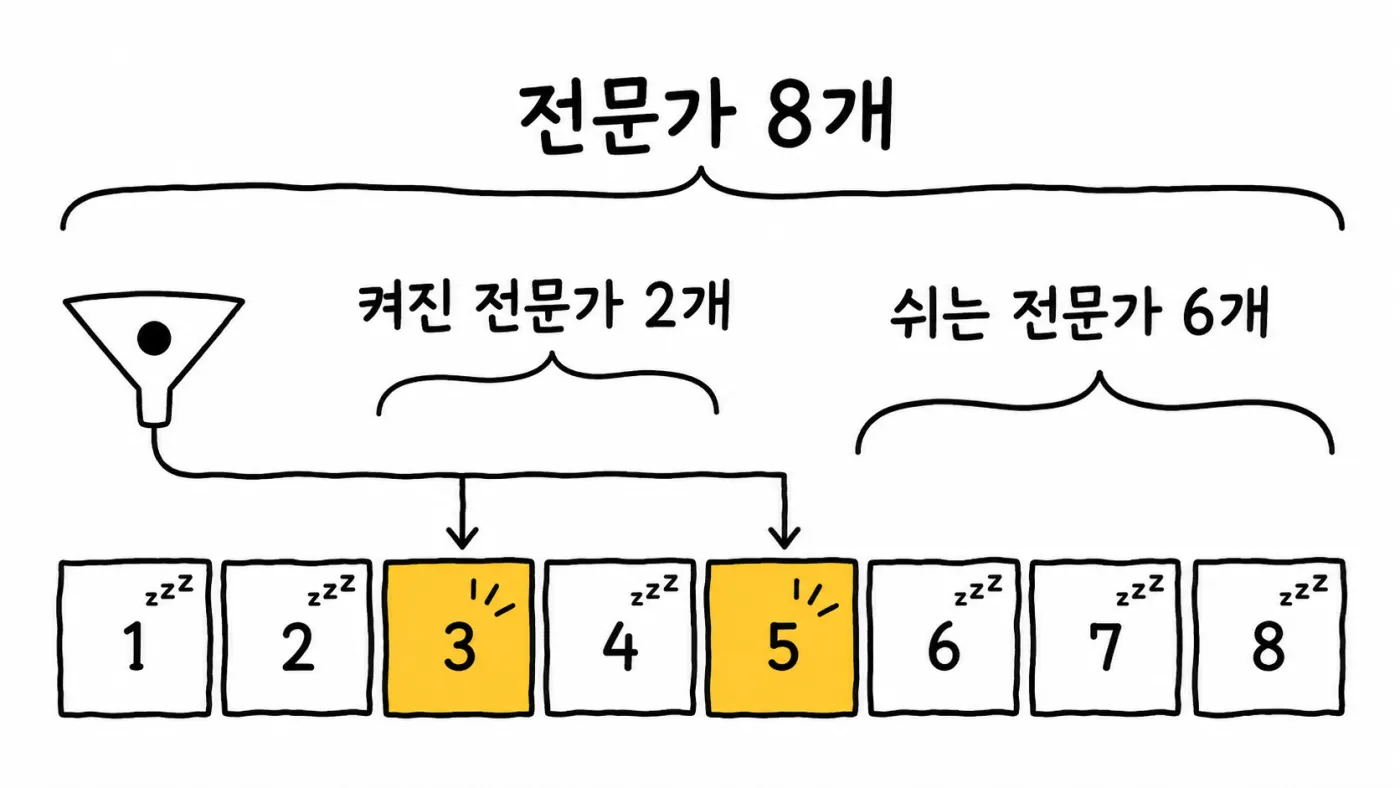
고객과 모델을 비교할 때 "총 파라미터"는 메모리, "활성 파라미터"는 토큰당 연산과 지연을 가늠하는 숫자라고 구분해서 읽습니다.
3.3.3 부하 분산(Load Balancing)
라우터가 매 토큰마다 같은 전문가 두 개만 고르면 나머지 6개는 아무것도 배우지 못하고 모델의 용량이 낭비됩니다. 이것이 부하 불균형(load imbalance) 문제이며 MoE 학습의 실제 난제입니다.
- 해법: 보조 부하 분산 손실. 학습 중 주 손실에 보조 손실(auxiliary load balancing loss)을 더해 라우터가 토큰을 전문가 전반에 고르게 퍼뜨리게 압박합니다. Switch Transformer, GShard 같은 논문에서 도입된 방식입니다. 일을 두 직원에게만 몰아주고 나머지가 노는 팀을 고르게 배분하는 관리자에 비유할 수 있습니다.
- 실패 양상: 부하 분산이 없으면 모델이 붕괴해서 몇 개의 전문가만 쓰이고 나머지는 죽은 가중치가 됩니다. 분산이 있으면 모든 전문가가 유용한 기술을 익혀 전체 용량을 씁니다.
- 전문가 용량(expert capacity): 각 전문가는 배치당 처리할 수 있는 토큰 수가 고정되어 있습니다. 한 전문가로 토큰이 지나치게 몰리면 넘치는 토큰은 버려지거나 차선 전문가로 보내집니다. 이 용량 한계가 실제 시스템에서 부하 분산이 중요한 이유입니다.
운영하는 쪽에서는 요청이 특정 전문가에 쏠리면 해당 GPU가 병목이 되므로, 자체 호스팅 MoE의 성능 문제를 진단할 때 전문가별 토큰 분포를 가장 먼저 봅니다.
3.3.4 출력 결합 방식
라우터는 top-k를 고를 뿐 아니라 각 전문가를 얼마나 신뢰할지를 가리키는 가중치도 냅니다. 최종 출력은 선택된 전문가 출력들의 가중합이며, top-2라면 최종 출력 = w1 × Expert_1(입력) + w2 × Expert_2(입력)입니다. 가중치는 전체 전문가가 아니라 선택된 전문가들의 점수에만 Softmax를 적용해 얻으므로 합이 1입니다.
토큰 하나가 전문가 8개짜리 MoE 층에 들어오는 예입니다.
- 점수: 라우터가 8개 전문가에 점수를 매기고 상위 2개가 전문가 3(0.7)과 전문가 5(0.3)입니다.
- 실행: 전문가 3과 5만 실행되어 각각 출력 벡터
Out_3,Out_5를 만듭니다. - 결합:
최종 출력 = 0.7 × Out_3 + 0.3 × Out_5. 가중치 합은 0.7 + 0.3 = 1.0입니다. - 전달: 결과가 다음 트랜스포머 층으로 넘어갑니다.
점수가 높은 전문가 3의 출력이 더 신뢰받고, 모델은 한 전문가의 거친 답이 아니라 상위 전문가들이 섞인 부드러운 답을 얻습니다.
top-1 모델(Switch Transformer)에서는 이 섞는 단계가 없고 선택된 전문가 하나의 출력이 그대로 나갑니다. 이 점이 top-k의 k가 품질과 연산을 맞바꾸는 손잡이가 되는 이유입니다.
3.3.5 장점과 도전 과제
MoE가 널리 쓰이는 이유는 비용 대비 규모이고, 치르는 값은 메모리·통신·학습 난이도입니다.
장점
- 규모와 비용: 총 파라미터가 수천억~수조여도 토큰당 활성 파라미터는 훨씬 작게 유지합니다. 모델 크기를 극단까지 밀어붙이는 현실적인 유일한 방법이라고 원문은 평가합니다.
- 빠른 추론: 토큰당 실제 연산이 작아서 응답이 빠르고 운영 GPU 비용이 낮습니다.
- 특화: 서로 다른 전문가가 서로 다른 종류의 입력을 자연스럽게 맡고, 라우터가 누가 무엇을 잘하는지를 누구도 알려 주지 않았는데 학습합니다.
- 스케일링: 밀집 모델과 같은 품질에 학습 연산이 훨씬 적게 드는 경우가 많다는 연구가 있습니다.
도전 과제
- 메모리 비용: 토큰당 몇 개의 전문가만 쓰더라도 모든 전문가를 메모리에 올려야 합니다. 80B MoE는 토큰당 20B만 써도 80B를 담을 GPU 메모리가 필요합니다. 16비트(파라미터당 2바이트)로 단순 환산하면 80B는 160 GB, 활성 20B는 40 GB 규모입니다. MoE가 아끼는 것은 연산이지 메모리가 아닙니다.
- 부하 분산이 까다로움: 신중히 학습하지 않으면 라우터가 몇 전문가로 붕괴합니다. 부하 분산 손실을 추가하고 세심하게 조정해야 합니다.
- 통신 비용: 큰 MoE에서는 전문가들이 서로 다른 GPU에 있어서 토큰을 맞는 GPU로 보내고 결과를 되받는 통신 오버헤드가 생깁니다. SGLang 같은 서빙 엔진은 전문가를 여러 기계에 분산하면서 이 오버헤드를 낮추도록 만들어졌습니다(10.13 참조).
- 파인튜닝이 어려움: 파인튜닝 중 라우터 동작이 바뀔 수 있어서 밀집 모델보다 까다롭습니다(11.1 참조).
현대 LLM과의 관계: 원문은 Mixtral, DeepSeek-V2, DeepSeek-V3와 몇몇 프런티어 모델이 MoE 기반이며, 상위 비공개 모델 다수도 내부적으로 MoE를 쓴다는 강한 추측이 있다고 적습니다. 밀집 모델은 수천억 파라미터에서 학습과 서빙 비용이 극단적으로 커져 벽에 부딪히고, MoE는 토큰당 연산을 같은 속도로 늘리지 않고 총 크기를 키워 이 벽을 우회합니다(2026년 4월 글 기준, 비공개 모델의 내부 구조는 추측입니다).
고객 현장에서는 "이 MoE 모델이 빠르다"는 말을 곧바로 "메모리도 적게 든다"로 이어 받지 않습니다. 배치할 GPU의 총 메모리와 노드 간 통신 대역폭을 먼저 확인합니다.
3.4 멀티모달 AI(Multimodal AI)
원문: What is Multimodal AI? How It Works and Where It Is Used
고객의 실제 업무 자료는 PDF 속 표, 스크린샷, 통화 녹음, 현장 사진처럼 텍스트 밖에 있는 경우가 많습니다. 이 절은 하나의 모델이 여러 종류의 데이터를 어떻게 함께 다루는지, 어떤 유형이 있고 어디서 실패하는지를 설명합니다(2026년 5월 글 기준).
3.4.1 모달리티와 유니모달 vs 멀티모달
멀티모달 AI(Multimodal AI)는 두 종류 이상의 데이터를 동시에 이해하고 생성하는 AI입니다. Multi(여럿)와 Modal(모달리티에서 온 말)의 합이며, 하나의 모델이 텍스트를 읽고, 이미지를 보고, 오디오를 듣고, 영상을 보고, 이 가운데 어느 형태로든 응답할 수 있습니다. 오랫동안 AI는 텍스트 모델, 이미지 모델, 오디오 모델이 각자의 세계에 살며 서로 대화하지 못했는데 멀티모달이 이 벽을 허뭅니다. 새 콘텐츠를 만드는 이 능력은 생성형 AI의 영역입니다(2.1 참조).
모달리티(modality)는 정보가 우리에게 닿는 특정한 형태나 통로이며, 쉽게 말해 데이터의 종류입니다.
- 텍스트: 단어, 문장, 소스 코드, 기사, 채팅 메시지
- 이미지: 사진, 차트, 도표, 스캔한 문서
- 오디오: 음성, 음악, 벨소리, 기계 소리
- 영상: 소리가 딸리기도 하는 움직이는 이미지(영화, 릴스)
- 기타: 센서 데이터, 깊이 지도, 3D 형상, 생체 신호
사람은 보고, 듣고, 읽고, 만지고, 냄새 맡은 신호를 하나의 이해로 섞는 자연스러운 멀티모달 시스템입니다. 환자를 진료하는 의사가 매일 이렇게 합니다.
유니모달 AI(Unimodal AI)는 한 종류의 데이터만 다룹니다. 텍스트만 읽는 스팸 분류기, 이미지만 보는 얼굴 검출기, 고양이/개를 판정하는 이미지 분류기가 예입니다.
용어 주의: 라벨이나 숫자는 모달리티가 아닙니다. 모달리티는 텍스트·이미지·오디오·영상 네 가지입니다. 스팸 분류기가 "spam"이라는 단어를 출력해도 언어를 생성한 것이 아니라 입력에 태그를 붙였을 뿐이므로 여전히 유니모달입니다.
멀티모달 AI는 두 종류 이상을 동시에 다룹니다. 사진과 질문을 받아 답하는 모델, 영상을 보고 텍스트로 요약하는 모델, 노래를 듣고 앨범 표지 이미지를 만드는 모델이 예입니다.
flowchart LR
  subgraph U["유니모달"]
    U1["텍스트 또는 이미지 또는 오디오<br/>(한 번에 하나)"] --> UM["모델"] --> UO["출력"]
  end
  subgraph M["멀티모달"]
    M1["텍스트"] --> MM["모델"]
    M2["이미지"] --> MM
    M3["오디오"] --> MM
    MM --> MO["출력"]
  end
그림 3.4.1 — 유니모달 모델은 한 번에 한 종류의 입력을, 멀티모달 모델은 여러 종류를 함께 받아 하나의 출력을 냅니다.
| 항목 | 유니모달 | 멀티모달 |
|---|---|---|
| 입력 | 한 종류 | 두 종류 이상 동시 |
| 이해 | 한 감각에 제한 | 감각을 가로질러 결합 |
| 용도 | 좁은 과업 | 풍부한 실제 과업 |
| 예 | 트윗 감성 분석 | "이 이미지를 설명해 줘" 비서 |
| 비용 | 낮음 | 높음 |
멀티모달이 필요한 까닭은 현실이 멀티모달이기 때문입니다. 의사는 병력(텍스트)을 읽고, X-ray(이미지)를 보고, 심장 소리(오디오)를 듣고, 걸음걸이(영상)를 보고 하나의 진단으로 합칩니다. 텍스트만 읽는 모델은 오류 화면 스크린샷을 붙여도 도울 수 없고, 이미지만 보는 모델은 그 이미지에 대한 질문에 답할 수 없으며, 오디오만 듣는 모델은 녹음과 함께 온 회의 메모를 읽지 못합니다.
고객 업무를 볼 때 입력이 몇 종류인지, 출력이 어떤 종류여야 하는지를 먼저 적어 보면 멀티모달이 필요한 곳과 유니모달로 충분한 곳이 갈립니다.
3.4.2 멀티모달의 작동 방식
모든 멀티모달 시스템의 핵심 발상은 하나입니다. 모든 종류의 입력을 모델이 이해하는 공통 숫자 형태로 바꾼 뒤 함께 처리합니다. 순서는 인코딩 → 정렬 → 추론 → 생성입니다.
flowchart TD
  T["텍스트"] --> TE["텍스트 인코더"]
  I["이미지"] --> IE["이미지 인코더"]
  A["오디오"] --> AE["오디오 인코더"]
  TE --> S["공유 임베딩 공간"]
  IE --> S
  AE --> S
  S --> MM["멀티모달 모델"]
  MM --> O["출력 (텍스트 / 이미지 / 오디오)"]
그림 3.4.2 — 인코더가 각 입력을 벡터로 바꾸고 공유 공간에서 만나 하나의 모델이 처리합니다.
- 모달리티별 인코더: 모델은 날것의 텍스트, 픽셀, 음파를 이해하지 못하고 숫자만 이해합니다. 인코더(encoder)는 원본 데이터를 벡터(숫자 목록)로 바꾸는 작은 모델입니다. 의사가 X-ray는 눈으로, 심장 소리는 귀로, 기록은 독해로 보듯 종류마다 인코더가 다릅니다. 텍스트 인코더는 단어를, 이미지 인코더는 픽셀을(흔히 Vision Transformer 사용), 오디오 인코더는 음파를 벡터로 만듭니다. 이 벡터가 임베딩이며 입력의 의미를 모델이 쓸 수 있게 담은 벡터입니다(2.6 참조).
- 공유 임베딩 공간: 멀티모달의 핵심 요령입니다. 인코더들을 함께 학습해서 출력이 같은 벡터 공간에 놓이게 합니다. 학습은 맞는 짝(고양이 사진과 단어 "cat")을 가깝게 당기고 틀린 짝(고양이 사진과 단어 "car")을 멀리 밉니다. 그 결과 픽셀에서 나온 사진과 글자에서 나온 단어가 이 공간에서 가까워지고, 개 사진과 "dog"도 마찬가지입니다. 이 공간 덕분에 모델이 사진과 문장을 비교하거나 소리를 영상 프레임에 맞출 수 있습니다.
- 멀티모달 모델: 공유 임베딩이 하나의 모델, 대개 트랜스포머(2.8 참조)로 들어가서 모든 입력을 한꺼번에 가로질러 추론합니다. 부엌 사진과 "의자가 몇 개입니까?"를 주면 이미지 임베딩과 텍스트 임베딩을 함께 보고 답합니다.
- 출력: 모델과 과업에 따라 텍스트, 이미지, 오디오, 영상이 될 수 있습니다.
끝에서 끝까지 예를 들면 다음 순서입니다.
- 부엌 사진을 올리고 "How many chairs are there?"를 입력합니다.
- 이미지 인코더가 사진을 이미지 임베딩으로, 텍스트 인코더가 질문을 텍스트 임베딩으로 바꿉니다.
- 두 임베딩이 멀티모달 모델에 함께 들어가 함께 처리됩니다.
- 모델이 텍스트로 "There are 4 chairs."라고 답합니다.
이 구조에서 실패는 대개 정렬에서 시작합니다. 공유 공간이 부실하면 사진과 문장이 연결되지 않으므로, 고객의 도메인(공장 도면, 의료 영상 등)이 학습 분포에서 먼 경우 소량 샘플로 먼저 확인합니다.
3.4.3 세 가지 대표 유형
현실의 멀티모달 시스템은 입출력 모달리티의 관계에 따라 세 유형으로 나뉩니다.
| 유형 | 입력 → 출력 | 예 |
|---|---|---|
| 멀티모달 이해 | 여러 모달리티 → 한 모달리티(대개 텍스트) | GPT-4V, Gemini, 비전 기능이 있는 Claude |
| 교차 모달 생성 | 한 모달리티 → 다른 모달리티 | 텍스트→이미지(DALL-E, Midjourney), 텍스트→영상(Sora, Veo), 오디오→텍스트(Whisper) |
| 교차 모달 정렬 | 둘 이상 모달리티를 같은 공유 공간에 배치 | CLIP: 텍스트로 이미지 검색 |
- 멀티모달 이해: 사진을 보내 "이 이미지에 뭐가 있나요?"라고 묻고 텍스트로 답을 받는 식입니다. 이미지를 보고 텍스트로 답하는 모델이 비전-언어 모델(Vision-Language Model, VLM)입니다(3.5 참조).
- 교차 모달 생성: 입력과 출력의 모달리티가 다릅니다. Whisper는 오디오를 듣고 텍스트를 만드는 모델이라 이 유형입니다.
- 교차 모달 정렬: 모든 멀티모달 모델이 내부에 공유 공간을 쓰지만, 이 유형에서는 공유 공간 자체가 제품입니다. 모델은 주로 이 공간을 만들고 노출하도록 학습되며, 생성된 답을 거치지 않고 모달리티 간에 곧바로 비교하거나 검색할 수 있습니다(5.11 참조).
- 실제 모델은 둘 이상의 유형을 섞기도 합니다.
원문이 드는 실제 모델은 다음과 같습니다(2026년 5월 글 기준).
- GPT-4V: 텍스트와 이미지를 읽고 텍스트로 응답
- GPT-4o: 텍스트·이미지·오디오를 읽고 텍스트나 오디오로 실시간 응답
- Google Gemini: 텍스트·이미지·오디오·영상·코드를 한 번에 읽음
- Claude(비전 포함): 텍스트와 이미지를 읽고 텍스트로 응답
- CLIP(Contrastive Language-Image Pretraining): 텍스트와 이미지를 공유 임베딩 공간에 연결
- DALL-E, Midjourney: 텍스트 프롬프트로 이미지를 생성(확산 모델 기반)
- Whisper: 오디오를 듣고 텍스트 생성
- Sora, Veo: 텍스트로 영상 생성
고객이 "이미지를 다루는 AI"를 요청하면 위 표에서 입력은 이미지이고 출력은 텍스트인지(이해), 이미지인지(생성), 검색 결과인지(정렬)를 먼저 확정해야 모델 후보가 정해집니다.
3.4.4 사용 사례와 흔한 실수
멀티모달은 현실의 풍부한 과업에서 쓰이며, 실수는 대부분 필요 이상으로 쓰거나 정렬·평가를 소홀히 하는 데서 나옵니다.
사용 사례
- 시각 질의응답(VQA): 사진을 올리고 질문해 답을 얻습니다.
- 문서 이해: 텍스트·표·차트가 한꺼번에 든 PDF를 읽습니다.
- 의료 영상: X-ray, 스캔, 환자 기록을 결합해 진단을 돕습니다.
- 자율주행: 카메라, 레이더, LIDAR(Light Detection and Ranging) 데이터를 섞어 안전하게 운전합니다.
- 접근성: 보지 못하는 사람에게 이미지를 설명하고, 읽지 못하는 사람에게 글을 읽어 줍니다.
- 콘텐츠 제작: 간단한 텍스트 프롬프트로 이미지·영상·음악을 만듭니다.
- 고객 지원: 긴 글 대신 스크린샷이나 음성 메모를 보내게 합니다.
- 교육: 도표를 설명하고, 손글씨 수학 문제를 풀고, 교과서 쪽을 소리 내어 읽습니다.
- 모바일 앱: 외국어 메뉴를 사진으로 찍어 즉시 번역하고 요리 이름을 소리로 들려줍니다.
- 텍스트·이미지·오디오·영상이 현실과 구분되지 않을 만큼 진짜 같아지므로 콘텐츠의 출처를 확인하는 장치도 필요합니다. 생성물에 숨은 신호를 넣는 워터마킹이 그 예입니다(9.4 참조).
흔한 실수
| 실수 | 설명 |
|---|---|
| "텍스트 + 이미지"로만 이해 | 오디오, 영상, 센서 데이터, 3D 형상도 모달리티입니다. 자율주행차는 카메라·레이더·LIDAR를 섞습니다. |
| 한 모델이 모든 일에 맞다고 가정 | 어떤 과업에는 집중된 유니모달 모델이 맞습니다. 멀티모달이 항상 낫지는 않습니다. |
| 데이터 품질 무시 | 모달리티 사이의 정렬이 모델 품질의 상한입니다. 사진에 잘못된 캡션 같은 나쁜 짝은 나쁜 결과로 이어집니다. |
| 비용 망각 | 멀티모달 모델은 유니모달보다 무겁고 느립니다. 추가 신호가 값을 하는 곳에 씁니다. |
| 모달리티별 평가 생략 | 텍스트에 강하고 오디오에 약할 수 있어서 각각과 결합을 따로 시험해야 합니다. |
| 너무 많은 모달리티를 한꺼번에 | 새 모달리티는 잡음, 지연, 위험을 더합니다. 과업에 분명한 가치가 있을 때만 더합니다. |
| 편향 간과 | 각 모달리티와 학습 짝에서 편향이 들어올 수 있으므로 유니모달과 마찬가지로 출력의 불공정한 패턴을 점검합니다. |
FAQ에서 확인되는 내용도 같습니다. 스팸 분류기는 멀티모달이 아니고, 멀티모달이 항상 낫지 않고, Whisper는 오디오 입력과 텍스트 출력이므로 교차 모달 생성의 예이며, 고양이 사진과 단어 "cat"의 의미가 같다는 것은 공유 공간에서의 근접으로 알아냅니다.
고객 현장에서는 "이 업무에 실제로 추가 모달리티가 필요한가"를 모달리티별로 정확도 향상, 지연 증가, 비용 증가를 놓고 한 표에 적어 판단합니다.
3.5 비전-언어 모델(VLM)
원문: How does a Vision-Language Model (VLM) work?
고객이 영수증, 스크린샷, 차트 이미지를 모델에 넣겠다고 할 때 비용과 정확도를 가늠하려면 이미지가 모델 안에서 어떤 모양의 입력이 되는지 알아야 합니다. 이 절은 3.4의 시각-언어 유형을 구성 요소 단위로 분해합니다(2026년 10월 글 기준).
3.5.1 컴퓨터가 이미지를 보는 방식
비전-언어 모델(Vision-Language Model, VLM)은 이미지와 텍스트를 함께 입력받아 같이 이해하고 텍스트로 답하는 AI 모델입니다. 부엌 사진과 "이 테이블 위 재료로 뭘 요리할 수 있나요?"를 주면 달걀·토마토·양파를 보고 "토마토와 양파를 넣은 오믈렛을 만들 수 있습니다"라고 답합니다. ChatGPT, Claude, Gemini에 사진을 올려 질문할 때 일하는 것이 VLM입니다. 대표 과업은 사진 설명, 이미지 질의응답, 스크린샷·영수증·문서의 글자 읽기, 차트·도표 이해입니다.
컴퓨터는 고양이나 나무를 보지 못하고 숫자만 봅니다. 이미지는 픽셀(pixel)이라는 작은 색 점의 격자이고, 픽셀마다 빨강(R)·초록(G)·파랑(B)의 세기를 0~255 숫자 세 개로 갖습니다. 순수한 빨강은 [255, 0, 0], 흰색은 [255, 255, 255]입니다.
- 336 × 336 사진은 336 × 336 = 112,896 픽셀이고 픽셀마다 숫자 3개이므로 모두 338,688개의 숫자입니다.
- 이 날것의 숫자는 "고양이"라고 직접 말해 주지 않습니다. 숫자를 의미로 바꾸는 부품이 필요합니다.
LLM이 다루는 대상은 토큰의 임베딩 열(2.4, 2.6 참조)이고 이미지는 픽셀 격자이므로, 둘은 전혀 다른 형태의 데이터입니다. 영어만 읽는 작가에게 그림을 보여 주고 이야기를 부탁하는 비유로 풀 수 있습니다. 작가는 그림을 볼 수 없으므로 두 조력자를 둡니다. 그림의 세부를 자기만의 메모로 적는 그림 전문가와, 그 메모를 작가가 읽을 영어 문장으로 바꾸는 번역가입니다. 작가는 영어 메모와 질문을 읽고 이야기를 씁니다. 이 구조가 VLM의 세 부분이며 전문가는 비전 인코더, 번역가는 프로젝터, 작가는 언어 모델입니다.
flowchart TD
  IMG["이미지"] --> VE["비전 인코더<br/>(그림 전문가)"] --> PV["패치 벡터"] --> PR["프로젝터<br/>(번역가)"] --> VT["시각 토큰"]
  Q["텍스트 질문"] --> TT["텍스트 토큰"]
  VT --> LM["언어 모델<br/>(작가)"]
  TT --> LM
  LM --> A["텍스트 답"]
그림 3.5.1 — 인기 있는 VLM의 세 부분. 이미지는 시각 토큰으로 바뀌어 텍스트 토큰과 한 열로 합쳐집니다.
고객 문서가 이미지로만 들어온다면 먼저 이 숫자 격자가 모델에 얼마나 큰 입력이 되는지(토큰 수 계산은 3.5.4 참조)를 확인합니다.
3.5.2 비전 인코더와 CLIP
비전 인코더(vision encoder)는 이미지를 이해해서 벡터(숫자 목록)로 바꾸는 부분입니다. 가장 흔한 것이 Vision Transformer(ViT)이며 LLM 안에 쓰이는 트랜스포머 구조를 이미지에 적용한 것입니다. 단계는 네 가지입니다.
- 패치로 자르기: 이미지를 패치(patch)라는 작은 정사각형으로 자릅니다. 336 × 336 이미지를 14 × 14 픽셀 패치로 자르면 한 변에 24개, 24 × 24 = 576개입니다. 패치는 문장 속 단어처럼 행 순서로 읽습니다.
- 패치를 벡터로: 14 × 14 패치는 14 × 14 × 3 = 588개의 숫자입니다. 이를 한 줄로 펴서 학습된 층에 통과시켜 벡터로 만듭니다. 이제 패치 하나가 이미지의 "단어" 하나입니다.
- 위치 임베딩 추가: 패치가 이미지의 어디 있었는지 알려 줍니다. 없으면 하늘 패치가 위인지 아래인지 모릅니다.
- 트랜스포머 층 통과: 어텐션(2.9 참조)으로 모든 패치가 다른 모든 패치를 봅니다. 귀 패치가 눈 패치와 털 패치를 보며 "고양이 얼굴"이라고 함께 이해합니다.
결과는 패치당 벡터 하나이고, 이 벡터는 날것의 색이 아니라 의미를 담습니다. 그림 전문가의 사적인 메모에 해당합니다.
그렇다면 인코더는 사물이 무엇인지 어떻게 배웠을까요. 많은 VLM이 2021년 OpenAI가 공개한 CLIP(Contrastive Language-Image Pre-training)의 비전 인코더를 가져옵니다.
- CLIP은 인터넷에서 모은 약 4억 쌍의 이미지-캡션(예: 갈색 개 사진과 "공원에서 노는 갈색 개")으로 학습되었습니다.
- 구성은 이미지 인코더와 텍스트 인코더입니다. 배치의 이미지와 캡션을 모두 벡터로 만든 뒤 각 이미지의 벡터를 자기 캡션의 벡터에는 가깝게, 배치의 나머지 캡션 벡터에는 멀게 만듭니다.
- 맞는 짝과 틀린 짝을 대비해 배우므로 대조 학습(contrastive learning)이라 부릅니다(3.4.2의 공유 임베딩 공간을 만드는 방법이 바로 이것입니다).
- 학습 뒤 CLIP의 이미지 인코더는 이미지에 대한 의미를 담은 벡터를 내며 그 의미가 이미 언어와 연결되어 있습니다. VLM의 그림 전문가로 잘 맞는 이유입니다.
비전 인코더가 이미 언어와 맞닿아 있다는 점은, 고객 도메인(예: 공정 사진)이 CLIP이 본 인터넷 이미지 분포와 멀 때 성능이 떨어질 수 있다는 판단 근거가 됩니다.
3.5.3 프로젝터
비전 인코더가 낸 패치 벡터는 인코더만의 사적인 언어이며 LLM이 읽을 수 없습니다. 예를 들어 비전 인코더는 크기 1,024 벡터를 내고 LLM은 크기 4,096 임베딩을 기대합니다. 크기만이 아니라 숫자 하나하나의 의미도 다릅니다.
프로젝터(projector)는 각 패치 벡터를 LLM이 단어 임베딩으로 읽을 수 있는 벡터로 바꾸는 작은 신경망입니다.
- 프로젝터는 아주 단순할 수 있습니다. 대표 모델 LLaVA의 첫 버전은 학습된 숫자 표 하나를 곱하는 선형 층 하나였고, LLaVA-1.5는 2층짜리 작은 신경망인 MLP(Multi-Layer Perceptron)를 썼습니다.
- 프로젝터를 지나면 패치 하나가 시각 토큰(visual token)이 됩니다. LLM에게 시각 토큰은 이미지에서 왔어도 단어 토큰과 똑같이 보입니다. 번역가의 일입니다.
- 코드의 차원으로 보면 1,024 × 4,096 크기의 표 하나가 곱해지는 것이며, 이 표의 값은 학습으로 정해집니다.
patch_vectors = np.random.rand(576, 1024)     # 비전 인코더 출력 (패치당 1,024)
projector = np.random.rand(1024, 4096)        # 학습으로 정해지는 표
visual_tokens = patch_vectors @ projector     # (576, 4096)
원문의 NumPy 예제는 난수로 데이터 모양의 흐름만 보여 줍니다. 곱셈 뒤 시각 토큰의 모양이 (576, 4096)이 되어 LLM의 임베딩 크기와 같아졌다는 점이 핵심입니다.
대안 설계도 있으며 프로젝터 방식이 가장 흔할 뿐 유일하지는 않습니다.
| 설계 | 이미지를 잇는 방식 | 예 |
|---|---|---|
| 프로젝터 | 모든 패치를 시각 토큰으로 바꿔 텍스트 앞에 놓음 | LLaVA |
| 쿼리 기반 커넥터 | 학습된 소수의 쿼리가 이미지에서 중요한 정보를 끌어와 토큰이 적음 | BLIP-2 (Q-Former) |
| 크로스 어텐션 | 이미지를 토큰으로 넣지 않고, LLM 내부 추가 층이 글을 읽으며 이미지를 봄 | Flamingo |
| 네이티브 멀티모달 | 처음부터 이미지와 텍스트 토큰을 함께 학습 | Chameleon |
- 프로젝터 방식은 단순하고 세부를 모두 유지하지만 토큰이 많이 듭니다. 쿼리 기반 방식은 토큰이 적은 대신 작은 세부를 잃을 수 있습니다.
- 크로스 어텐션은 텍스트가 LLM 안에서 이미지를 보는 구조입니다.
고객이 쓰려는 상용 VLM이 어떤 연결 방식인지는 대개 공개되지 않지만, 이미지 한 장당 과금되는 토큰 수가 공개되어 있다면 이 설계 차이가 비용으로 나타난 것입니다.
3.5.4 언어 모델
언어 모델은 시각 토큰과 텍스트 토큰이 이어진 긴 열 하나를 받습니다.
[시각 토큰 1] [시각 토큰 2] ... [시각 토큰 576] [What] [is] [in] [this] [image] [?]
LLM은 이 열을 일반 텍스트와 똑같이 읽습니다. 어텐션을 통해 텍스트 토큰이 시각 토큰을 봅니다. "this"가 시각 토큰을 보고 고양이 패치를 찾습니다. 그런 다음 한 번에 한 토큰씩 답을 만듭니다. 예를 들면 "This is an orange cat sleeping on a blue sofa."입니다. LLM은 픽셀을 보지 않고 토큰만 보며, 어떤 토큰은 단어에서 왔고 어떤 토큰은 이미지에서 왔습니다.
원문 코드의 출력은 다음과 같습니다.
Patches: 576
Visual tokens: (576, 4096)
LLM input: (584, 4096)- 이미지가 576개, 질문이 8개 토큰이므로 LLM이 받는 입력은 576 + 8 = 584토큰이고 모두 크기 4,096으로 같아서 함께 읽을 수 있습니다.
- 이미지 한 장이 8토큰짜리 질문의 72배인 576토큰을 썼습니다(576 ÷ 8 = 72). 이것이 이미지를 넣으면 VLM이 텍스트만일 때보다 느리고 비싼 이유입니다.
- 이미지를 몇 개 넣느냐가 비용과 컨텍스트 윈도우 사용량을 좌우합니다(2.16 참조).
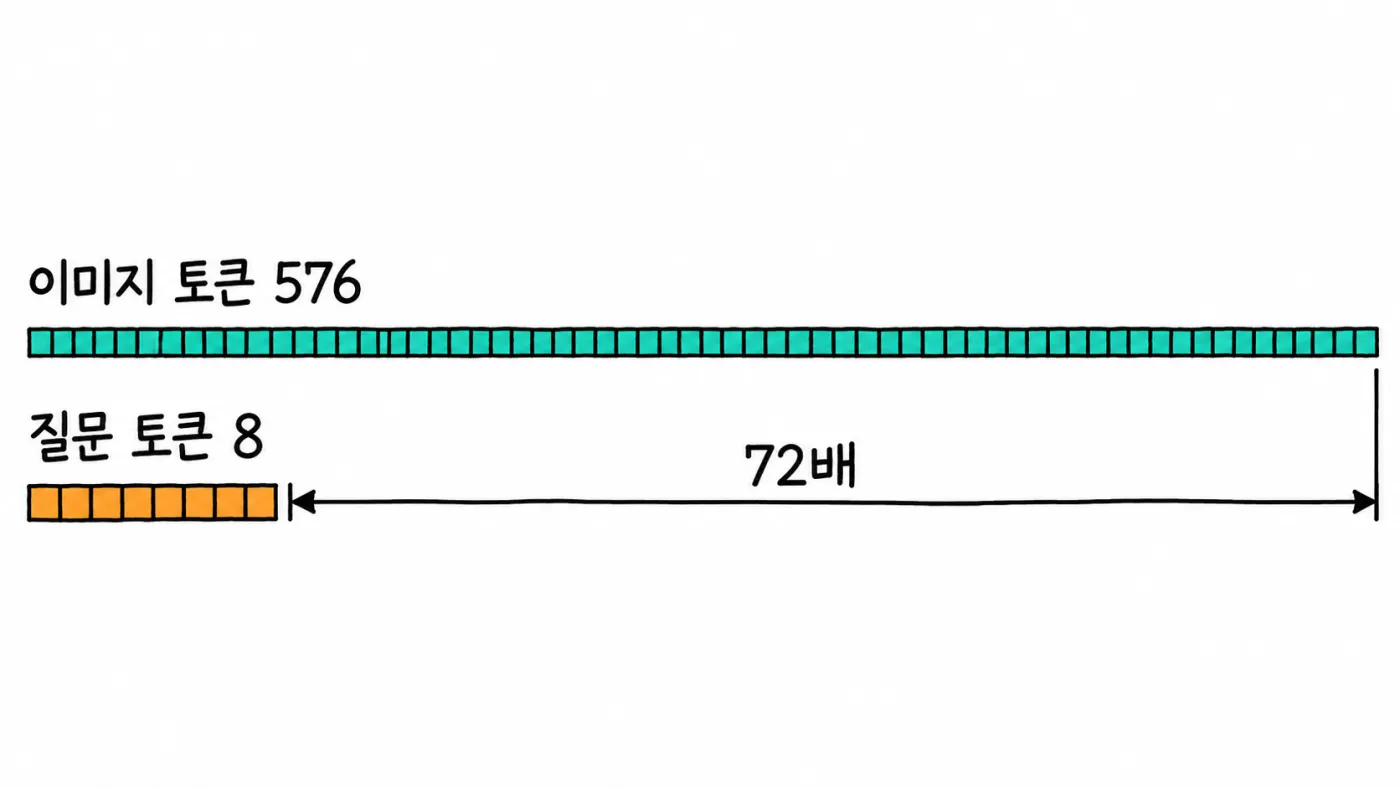
FAQ의 질문인 "LLM이 픽셀을 보는가"의 답은 아니오입니다. 비전 인코더가 패치를 벡터로, 프로젝터가 그 벡터를 시각 토큰으로 바꾸고, 언어 모델은 시각 토큰과 텍스트 토큰을 한 열로 읽습니다.
고객 견적에서는 이미지 한 장의 토큰 수에 월 이미지 수를 곱한 값을 텍스트 입력 비용에 더해서 계산합니다.
3.5.5 VLM 학습 방식
VLM은 이미 잘하는 부품을 재사용해서 싸게 학습합니다. LLaVA의 레시피가 단순해서 좋은 예입니다. 출발점은 이미 학습된 두 부분, 곧 CLIP의 비전 인코더와 언어를 이미 아는 LLM이며, 새로 만드는 것은 프로젝터뿐입니다.
- 번역가 가르치기: 비전 인코더와 LLM을 동결(frozen)(파라미터를 갱신하지 않음)하고 프로젝터만 대규모 이미지-캡션 쌍으로 학습합니다. 과업은 이미지를 보고 캡션을 만드는 것이며, 이미지 벡터를 LLM의 언어로 바꾸는 법을 프로젝터가 익힙니다.
- 지시 따르기 가르치기: 이미지와 질문, 좋은 답이 있는 예시로 학습합니다. 거리 사진과 "건너도 안전한가요?"라는 질문에 유용한 답이 짝지어진 식이며, 이 단계에서는 프로젝터와 LLM을 함께 학습합니다. 비전 인코더는 보통 동결 상태로 둡니다. VLM이 이미지에 대해 유용한 대화를 하도록 배웁니다.
| 부분 | 1단계 | 2단계 |
|---|---|---|
| 비전 인코더 | 동결 | 동결 |
| 프로젝터 | 학습 | 학습 |
| LLM | 동결 | 학습 |
- FAQ에 따르면 VLM을 만들 때 비전 인코더는 보통 다시 학습하지 않습니다. CLIP에서 이미 학습된 채로 쓰입니다.
- 새로 학습하는 양이 적으므로 처음부터 학습하는 것보다 훨씬 싸고, 이 재사용이 VLM 학습을 싸게 합니다.
- 처음부터 이미지와 텍스트를 함께 학습하는 네이티브 멀티모달(Chameleon)은 이 재사용 방식과 대비되는 접근입니다(3.5.3 참조).
파인튜닝(11.1 참조)으로 VLM을 고객 도메인에 맞출 때도 어느 부분을 동결하고 어느 부분을 학습할지가 비용을 정합니다. 프로젝터만 손보면 싸지만 표현력이 제한됩니다.
3.5.6 잘 되는 곳과 실패하는 곳
VLM은 일반적인 시각 이해에 강하고, 정확한 수치·위치·작은 글자에는 약합니다.
잘 되는 곳
- 사진을 설명하고 일반 질문에 답하기
- 스크린샷, 영수증, 문서의 글자 읽기
- 차트, 표, 도표 이해
- 저시력 사용자가 주변을 이해하도록 돕기
실패하는 곳
| 실패 | 원인과 양상 |
|---|---|
| 환각 | 이미지에 없는 것을 묘사합니다. 탁자에 컵이 없는데 있다고 말하는 식입니다. 큰 원인은 LLM이 텍스트에서 얻은 강한 습관이며, 컵은 보통 부엌 탁자에 있으므로 빈 곳을 "보통 있는 것"으로 채웁니다(2.18 참조). |
| 개수·정확한 위치 | "하늘에 새가 몇 마리?", "열쇠가 휴대폰 왼쪽에 있나?" 같은 질문에 자주 틀립니다. |
| 작은 세부 | 큰 이미지를 비전 인코더 크기에 맞춰 줄이면 작은 글자와 작은 물체가 뭉개집니다. 최신 VLM 다수는 큰 이미지를 여러 타일로 잘라 각각 인코딩해 고치지만 토큰이 더 듭니다. |
| 비용 | 이미지 한 장이 수백~수천 토큰을 더해 느리고 비싸집니다. |
- 타일링을 쓰면 토큰이 타일 수에 비례해 늘어납니다. 위 예의 576토큰 이미지를 4개 타일로 자르면 576 × 4 = 2,304토큰이 됩니다(타일 수는 설명을 위한 가정입니다).
- 환각은 시스템이 아니라 모델의 습관에서 오므로, 값이 중요한 항목(금액, 개수)은 이미지에서 추출한 값을 사람이나 규칙이 한 번 더 검증하는 단계를 둡니다.
고객 현장에서는 문서의 글자 크기와 해상도, 개수·위치 질문의 비중을 먼저 확인합니다. 작은 글자의 표나 개수 세기가 핵심이라면 단일 VLM 호출만으로 약속하지 말고 해상도 분할과 검증 단계를 계획에 포함합니다.
3.6 LLM 라우팅(LLM Routing)
원문: What is LLM Routing? How to Send Each Query to the Right LLM
고객은 비용을 줄이면서 품질은 유지하길 원하고, 모델 풀에는 크기와 가격이 다른 모델이 여럿 있습니다. 이 절은 모델 안의 전문가 선택(3.3)과 달리 모델과 모델 사이에서 요청을 나누는 애플리케이션 계층의 장치를 다룹니다(2026년 5월 글 기준).
3.6.1 라우터의 구조
LLM 라우팅(LLM Routing)은 모든 쿼리를 같은 LLM에 보내지 않고 비용·지연·품질을 기준으로 쿼리마다 알맞은 LLM을 고르는 일입니다. 여러 LLM 앞에 놓인 계층이 쿼리를 보고 어느 LLM이 답할지 정합니다. 쉬운 쿼리는 작고 싸고 빠른 LLM에, 어려운 쿼리는 크고 똑똑하고 비싼 LLM에 보내서 품질을 잃지 않고 비용을 아낍니다. 병원 접수 담당자가 감기는 일반의에게, 심장 문제는 심장내과에, 뇌 문제는 신경과에 보내는 것과 같습니다. 접수 담당자가 라우터이고 의사가 LLM이며 환자가 쿼리입니다.
라우팅이 필요한 이유는 모델들이 세 가지에서 다르기 때문입니다.
- 비용: 프런티어 LLM(시장 맨 위의 가장 크고 똑똑한 모델)은 비싸고 작은 LLM은 아주 쌉니다.
- 지연: 큰 모델이 느리고 작은 모델이 빠릅니다.
- 품질: 어떤 쿼리는 가장 똑똑한 모델이 필요하고 많은 쿼리는 그렇지 않습니다.
원문의 수치로 프런티어 LLM이 출력 100만 토큰당 약 $15, 작은 LLM이 약 $0.50이면 격차는 15 ÷ 0.5 = 30배입니다. "2 + 2는?", "이 이메일 요약해 줘", "프랑스의 수도는?" 같은 대부분의 쿼리는 쉬우므로, 전부를 프런티어 LLM에 보내는 것은 비용과 시간의 낭비입니다. 가격 수치는 시점에 따라 달라지므로 2026년 5월 글의 예시로 읽습니다.
라우터는 네 부분으로 구성됩니다.
flowchart TD
  Q["사용자 쿼리"] --> R["LLM 라우터"]
  R --> S["작은 LLM"]
  R --> M["중간 LLM"]
  R --> F["프런티어 LLM"]
  R --> C["코드 전문 LLM"]
  S --> A["응답"]
  M --> A
  F --> A
  C --> A
그림 3.6.1 — 쿼리가 라우터를 거쳐 LLM 풀의 한 모델로 전달되고 응답이 사용자에게 돌아갑니다.
- 쿼리: 사용자의 원래 입력이며 라우터가 보는 유일한 정보입니다.
- 라우터: 어느 LLM이 처리할지 정하는 작고 빠른 구성 요소입니다. 규칙 집합, 작은 분류기, 임베딩 조회, 심지어 작은 LLM이 될 수 있습니다.
- LLM 풀: 강점·비용·속도가 다른 LLM의 집합입니다. 작은 LLM, 중간 LLM, 프런티어 LLM, 코드 전문 LLM이 함께 있을 수 있습니다.
- 선택된 LLM: 라우터가 이 쿼리에 고른 하나의 LLM이며 쿼리가 전달되고 응답이 사용자에게 반환됩니다.
라우터 자신은 빨라야 합니다. 경험칙으로 라우터 자체의 지연을 선택된 LLM 지연의 10% 아래로 둡니다. 선택된 LLM이 1초 걸리면 라우터는 많아야 100 ms를 더해야 합니다.
LLM 풀을 구성하는 고객 현장에서는 풀의 모델 목록, 모델별 단가·지연, 그리고 라우터가 볼 수 있는 입력(쿼리뿐인지 대화 이력도 포함하는지)부터 확정합니다.
3.6.2 규칙 기반 라우팅
규칙 기반 라우팅은 가장 단순한 전략으로, 쿼리의 키워드, 길이, 패턴을 보고 LLM을 고릅니다. 원문의 함수는 이렇게 동작합니다.
def route(query: str) -> str:
    q = query.lower()
    if "code" in q or "function" in q or "bug" in q:
        return "code-llm"
    if len(q) < 50:
        return "small-llm"
    if len(q) < 200:
        return "mid-llm"
return "frontier-llm"- 코드 키워드가 있으면 코드 LLM, 50자 미만이면 작은 LLM, 200자 미만이면 중간 LLM, 그보다 길면 프런티어 LLM으로 보냅니다.
- 장점: 가장 빠르고 가장 쌉니다. 라우팅을 위해 모델을 호출하지 않습니다.
- 단점: 깨지기 쉽습니다. "Why is my Python script broken?"에는
code,function,bug가 모두 없어서 키워드 검사를 빠져나갑니다. 새로운 패턴이 나오면 규칙이 무너집니다. - 이 함수를 직접 돌려 보면 이 쿼리는 31자라서 길이 규칙에 따라 작은 LLM으로 갑니다. 코드 문제인데 코드 LLM에 가지 못한 것입니다.
- 길이 신호의 약점은 "Prove the Riemann hypothesis"(28자)가 어려운 문제인데도 작은 LLM으로 가는 데서도 드러납니다(3.6.7 참조).
규칙은 쿼리 유형이 몇 개로 뚜렷하고 변하지 않는 소규모 시스템에서는 충분합니다. 유형이 늘면 예외가 규칙보다 빨리 늘어납니다.
3.6.3 분류기 기반 라우팅
분류기 기반 라우팅은 과거 (쿼리, 최적 LLM) 쌍의 데이터로 작은 분류기를 학습시킨 뒤, 실행 시 분류기가 쿼리를 받아 알맞은 LLM을 예측하게 합니다.
- 분류기의 종류: 쿼리 임베딩 위의 로지스틱 회귀, 작은 신경망, 또는 선택한 LLM과 보정된 확률을 함께 돌려주는 System One 계열 모델이 가능합니다.
- 장점: 실제 데이터에서 배우므로 단순한 규칙이 놓치는 패턴을 잡습니다.
- 단점: 라벨이 달린 학습 데이터와 재학습 루프가 필요합니다.
- 실제 사례: 원문은 Sakana의 Fugu를 이 발상의 실제 모델로 들며, 가벼운 선택 헤드가 쿼리를 읽고 모델마다 점수를 매겨 최적 모델을 고른다고 설명합니다. 외부 자료는 Fugu를 모델 풀 위에서 요청마다 모델을 고르는 학습된 오케스트레이터로 소개하며, 선택 헤드 구조는 외부 출처로 확인하지 못했습니다.
"쿼리별 최적 LLM"이라는 라벨은 누가 정하는가가 이 방식의 실질적 난관입니다. 고객 데이터에 모델별 응답 품질 평가가 없다면 먼저 그 라벨을 만드는 평가 작업이 필요합니다(8.1 참조).
3.6.4 임베딩 기반 라우팅
임베딩 기반 라우팅은 각 쿼리를 의미를 담은 벡터인 임베딩으로 바꾸고(2.6 참조), LLM마다 하나씩 그 LLM이 잘하는 쿼리 유형을 대표하는 소수의 기준 임베딩(reference embedding)을 둡니다. 새 쿼리가 오면 가장 가까운 기준 임베딩을 찾고, 그 기준을 소유한 LLM이 쿼리를 처리합니다. 가까움은 코사인 유사도로 잴 수 있습니다(2.7 참조).
- 장점: 학습이 필요 없습니다. 새 LLM을 더하려면 기준 하나만 추가하면 됩니다.
- 단점: 품질이 기준 임베딩이 얼마나 좋은가에 달렸습니다.
- 같은 쿼리가 반복해서 임베딩되므로 임베딩 캐시로 반복 비용을 없앨 수 있습니다(5.12 참조).
기준 임베딩이 곧 "이 모델이 잘하는 쿼리"의 정의입니다. 고객의 실제 쿼리 로그에서 대표 예시를 뽑아 기준으로 삼아야 라우팅이 현장 분포에 맞습니다.
3.6.5 LLM-as-Router
LLM-as-Router는 작고 싼 LLM을 라우터로 씁니다. 라우터 LLM은 대상 LLM과 별개이며 쿼리를 읽고 어느 대상 LLM이 답할지 고르는 일만 합니다. 쿼리와 같은 언어를 쓰므로 고정 규칙보다 의도와 난이도를 훨씬 잘 이해합니다.
def route_with_llm(query: str) -> str:
    prompt = f"""Pick the best LLM for this query.
Options: small-llm, mid-llm, frontier-llm, code-llm.
Query: {query}
Answer with one word from the options:"""
return router_llm(prompt).strip()router_llm이 작고 싼 LLM이고, 쿼리를 읽어small-llm,mid-llm,frontier-llm,code-llm중 하나의 이름을 출력합니다.- 장점: 유연성이 가장 높습니다. 학습이 필요 없고 프롬프트만 바꿔 라우팅 규칙을 바꿉니다.
- 단점: 본 호출 앞에 LLM 호출이 하나 더 붙습니다. 라우터 LLM은 작고 빨라야 합니다.
- 출력은 자유 텍스트이므로 옵션 이외의 단어가 돌아오면 처리할 기본값(폴백)이 필요합니다.
프롬프트로 정책을 바꿀 수 있다는 유연함은 곧 변경 관리의 부담이기도 합니다. 라우터 프롬프트도 코드처럼 버전을 남기고 평가셋으로 회귀 시험을 합니다(8.1 참조).
3.6.6 캐스케이드 라우팅
캐스케이드(cascade) 라우팅은 비용 절감이 가장 큰 전략으로, 가장 싼 LLM에 먼저 보내고 답이 확신이 낮거나 틀려 보이면 더 큰 LLM으로 올립니다.
flowchart LR
  Q["쿼리"] --> S["작은 LLM"] --> C1{"확신?"}
  C1 -->|예| R1["답 반환"]
  C1 -->|아니오| M["중간 LLM"] --> C2{"확신?"}
  C2 -->|예| R2["답 반환"]
  C2 -->|아니오| F["프런티어 LLM"] --> R3["답 반환"]
그림 3.6.6 — 각 LLM은 답하거나 한 단계 큰 LLM에 넘깁니다.
- 확신 여부 검사는 LLM의 자기 평가, 검증 모델, 또는 답의 길이나 "I do not know" 포함 여부 같은 단순 휴리스틱입니다.
def cascade(query: str) -> str:
    answer = small_llm(query)
    if is_confident(answer):
        return answer
    answer = mid_llm(query)
    if is_confident(answer):
        return answer
return frontier_llm(query)- 장점: 비용 절감이 큽니다. 대부분의 쿼리가 가장 싼 LLM에서 해결됩니다.
- 단점: 어려운 쿼리는 LLM을 두세 번 호출해 값을 치르므로 느립니다.
- 가정 계산: 쿼리의 90%를 작은 LLM이 끝내고 10%가 프런티어까지 올라간다고 하면(중간 단계는 생략), 출력 100만 토큰당 비용은 0.9 × $0.50 + 0.1 × ($0.50 + $15) = $2.00입니다. 모두 프런티어에 보내는 $15의 약 13%입니다. 비율 90/10은 설명을 위한 가정이며 원문의 수치가 아닙니다.
- 이 계산에서 어려운 10%가 작은 LLM의 시도 비용을 추가로 치르는 점이 캐스케이드의 구조적 비용입니다.
전략별 비교는 다음과 같습니다.
| 전략 | 속도 | 비용 | 유연성 | 학습 필요 |
|---|---|---|---|---|
| 규칙 기반 | 가장 빠름 | 가장 낮음 | 낮음 | 아니오 |
| 분류기 기반 | 빠름 | 낮음 | 중간 | 예 |
| 임베딩 기반 | 빠름 | 낮음 | 중간 | 아니오 |
| LLM-as-Router | 중간 | 중간 | 높음 | 아니오 |
| 캐스케이드 | 어려운 쿼리에서 느림 | 평균적으로 최저 | 높음 | 아니오 |
단연 최선인 전략은 없습니다. 뚜렷한 유형이 몇 개뿐인 작은 시스템에는 규칙 기반이 충분하고, 쿼리가 섞여 있는 큰 제품에는 캐스케이드나 LLM-as-Router가 낫습니다.
3.6.7 흔한 실수와 수정
라우팅은 공학 비용이 있어서 이득이 날 때만 도입하며, 도입한 뒤에는 아래 여섯 가지 실수를 점검합니다.
도입이 값을 하는 신호
- 쿼리 양이 많을 때: 하루 수천 건은 라우팅을 거의 정당화하지 못하고 하루 수백만 건이면 거의 항상 정당화합니다.
- 쿼리 난이도가 섞여 있을 때: 대부분 쉽고 일부만 어렵다면 크게 이득입니다. 모든 쿼리가 같은 수준이면 LLM 하나로 충분합니다.
- 비용 압박이 있을 때, 그리고 이미 둘 이상의 LLM을 서로 다른 이유로 쓰고 있을 때 라우터가 임기응변 논리를 정리해 줍니다.
- 어느 것에도 해당하지 않으면 중간 크기 LLM 하나가 더 나은 선택일 수 있습니다.
LLM 라우팅과 MoE의 구분
| 항목 | LLM 라우팅 | MoE (3.3 참조) |
|---|---|---|
| 위치 | LLM 바깥, 애플리케이션 계층 | 하나의 LLM 안, 모델 계층 |
| 라우팅 대상 | 사용자 쿼리 전체 | 토큰 하나씩 |
| 고르는 것 | 완전한 LLM 하나 | 소수의 전문가 하위 네트워크 |
| 제어 주체 | 애플리케이션 개발자 | 모델 아키텍처 |
둘 다 라우터를 쓰고 연산의 부분집합을 고르지만, LLM 라우팅은 시스템 수준에서, MoE는 한 모델 안에서 일합니다.
여섯 가지 실수와 수정
| 실수 | 수정 |
|---|---|
| 라우터가 너무 무거움: 프런티어 LLM을 라우터로 쓰면 라우터 비용이 절감액보다 커질 수 있음 | 아주 작은 LLM, 분류기, 단순 규칙을 라우터로 사용 |
| 폴백 경로 없음: 선택된 LLM이 실패하거나 타임아웃되거나 나쁜 답을 낼 수 있음 | 항상 폴백 LLM을 두고, 작은 LLM이 실패하면 중간으로 내려받는 식으로 이어감 |
| 라우터가 지연을 너무 더함: 본 호출 앞에 500 ms가 붙으면 사용자 경험이 무너짐 | 규칙은 마이크로초, 분류기는 수 ms, 작은 LLM은 200 ms 이하로 유지 |
| 라우팅과 오케스트레이션의 혼동: 라우팅은 한 쿼리에 LLM 하나를 고르고, 오케스트레이션은 여러 단계에 걸쳐 여러 LLM을 조율함(6.15 참조) | 라우터를 하나의 집중된 구성 요소로 만듦 |
| 관측성 부재 | 어느 LLM이 어느 쿼리를 처리했는지, 비용·지연·품질을 로그로 남겨 라우터를 조정하고 잘못된 결정을 잡음(8.4 참조) |
| 잘못된 신호로 라우팅: "Prove the Riemann hypothesis"는 짧지만 어렵고, "Please summarize this email for me, thanks"는 길지만 쉬움 | 길이만이 아니라 의도와 난이도 신호를 사용 |
- 앞의 규칙 기반 함수로 실제 길이를 재면 리만 가설 쿼리는 28자, 이메일 요약 쿼리는 42자로 모두 50 미만이라 작은 LLM으로 갑니다. 전자는 어려운 쿼리가 작은 LLM에 가는 오라우팅의 실제 사례입니다.
- 원문의 전체 추적 예제(네 쿼리)는 규칙 기반 라우터로 동작을 보여 줍니다. "What is 2 + 2?"(14자)는 작은 LLM에서 약 100 ms, 3줄 이메일 요약(117자)은 중간 LLM에서 약 500 ms, "Fix the bug in this Python function that calculates Fibonacci."(62자,
bug와function일치)는 코드 LLM에서 약 700 ms, 의료 진단 멀티 에이전트 설계 요청(248자)은 프런티어 LLM에서 약 3초가 걸립니다. - 네 쿼리 가운데 프런티어로 간 것은 하나뿐이므로 라우팅이 없을 때(네 쿼리 모두 프런티어)와 비교해 호출이 4분의 1로 줄어듭니다. 원문은 이를 "접수 담당자가 일을 제대로 했다"고 표현합니다.
FAQ의 질문, 즉 라우팅과 오케스트레이션이 같은지, 라우터가 얼마나 빨라야 하는지, 프런티어를 라우터로 써도 되는지, 길이가 좋은 신호인지, 어느 전략이 가장 아끼는지에 대한 답은 위 표와 항목에 모두 반영되어 있습니다. 길이 신호만으로는 부족하고 캐스케이드가 가장 아끼되 어려운 쿼리가 느려집니다.
고객 현장에서는 호출량, 쿼리 난이도 분포, 단가를 가지고 위 신호 네 가지를 점검해 라우팅이 값을 하는지 먼저 판정하고, 도입한다면 폴백과 로그를 처음부터 포함시켜 설계합니다.
3.7 고객이 내일 묻는다면
각 질문에 소리 내어 답해보고, 막히면 표시된 절로 돌아가십시오. 로드맵이 제시한 통과 기준은 "내일 고객이 물어도 설명하고 결정할 수 있는가"입니다.
- "가장 큰 모델 하나로 전부 처리하면 안 되나요?" 작은 모델이 맞는 작업과 맞지 않는 작업을 어떻게 가릅니까? (3.1.4, 3.1.5)
- "개인정보라 데이터를 밖으로 못 보냅니다. 모델을 우리 서버나 노트북에 올릴 수 있나요?" 무엇을 보고 가능 여부를 정합니까? (3.1.1, 3.1.3)
- "추론 모델이 일반 모델보다 훨씬 비싸다는데 왜 그렇습니까?" 어떤 토큰에 비용이 붙고 무엇으로 상한을 둡니까? (3.2.2, 3.2.6)
- "요약 업무에 추론 모델을 쓰라고 팀에서 제안했습니다." 어떤 기준으로 쓸지 말지 결정합니까? (3.2.5)
- "추론 모델 프롬프트에 '단계별로 생각하라'를 넣어야 하죠?" 무엇이라고 답합니까? (3.2.3, 3.2.6)
- "이 모델은 700억 파라미터인데 80억짜리처럼 빠르다고 합니다. 사실인가요?" 총 파라미터와 활성 파라미터로 설명해 보십시오. (3.3.2)
- "MoE는 모델 여러 개를 합친 앙상블 아닙니까?" 무엇이 다른지 말해 보십시오. (3.3.1, 3.3.4)
- "MoE 모델에서 일부 전문가만 계속 쓰이면 무슨 문제가 있나요?" 학습에서는 어떻게 막습니까? (3.3.3, 3.3.5)
- "영수증 사진과 음성 메모를 한 번에 분석하고 싶습니다." 멀티모달 모델은 서로 다른 입력을 어떻게 한 모델이 받습니까? (3.4.2, 3.4.3)
- "스캔한 문서 이미지를 하루 수만 장 넣을 예정인데 비용이 얼마나 나올까요?" 이미지 한 장을 어떤 단위로 환산해 견적합니까? (3.5.1, 3.5.4)
- "비전 모델이 사진에 없는 물건을 있다고 하고, 개수도 자주 틀립니다." 왜 그렇고 어떻게 대응합니까? (3.5.6, 3.4.4)
- "요청마다 모델을 다르게 쓰고 싶은데 언제 라우팅이 값을 합니까?" 어떤 조건에서 도입을 정당화합니까? (3.6.7)
- "라우터를 만들었는데 짧은 어려운 질문이 작은 모델로 갑니다." 어떤 방식이 있고 무엇을 고칩니까? (3.6.2, 3.6.3, 3.6.7)
- "라우팅과 MoE는 같은 것 아닙니까? 캐스케이드는 또 뭔가요?" 위치와 단위로 구분해 설명해 보십시오. (3.3.1, 3.6.6, 3.6.7)